Дайджест #26: результат вырос, а навык не появился
Модели в выпуске – оценка в нашем бенчмарке
Эти две недели были про одно: ИИ помогает выдать результат, но не оставляет после себя знания. К одному и тому же выводу независимо пришли три замера – на консультантах BCG, на китайских школьниках и на кандидатах технического собеседования.
В выпуске:
- Результат вырос, навык не появился: эксперимент на почти 500 консультантах и 30 месяцев наблюдений за почти 27 тысячами школьников, один механизм на двух выборках.
- Кандидат принял код ИИ и не смог его объяснить: десять компаний уже пускают ИИ на собеседование, и 93% предложений модели кандидаты принимают, не отклоняя почти ничего.
- За что компании платят и что получают: около миллиона долларов в месяц на инструменты при метриках, которые не сдвинулись, больше 17 рабочих дней в год на переделку кода за ИИ и привычка, которая складывается в первые недели.
- Что поменялось в инструментах: ClipJury перечитал условия 175 сервисов, Mistral и Kimi открыли веса, Z.ai закрыла, клиентам Cursor предлагают бесплатную замену.
- Что нового у нас: мы пересобрали сайт, отписка больше не отбирает оплаченный курс, а игру «ИИ или человек?» теперь можно пройти и по-английски.
- Шесть ссылок в конце: проспект Anthropic перед выходом на биржу, заказы от агентов, которых почти нет, и расширение для истории промптов, которое слило её на чужой сервер.
Результат вырос, навык не появился
В Nature Human Behaviour вышла статья «Generative AI and the temporary upskilling of knowledge workers»: экономист Эмма Уайлс из Бостонского университета, Лиза Крайер и коллеги из BCG Henderson Institute и Памела Мишкин из команды OpenAI по экономическим эффектам. Рандомизированный эксперимент, план анализа зарегистрирован заранее. Почти 500 консультантов BCG. Больше 60% участников никогда не программировали или знают только основы – писать код консультант по должности и не обязан.
Половине участников дали GPT-4 и 15–20 минут обучения промптам, другой половине – столько же обучения поиску ответов через Google, Stack Overflow и Khan Academy. На задачу отводили 90 минут, и каждому случайно доставались две из трёх: очистить и объединить в Python две таблицы заказов и найти пять клиентов с самым высоким средним чеком; разобрать советы модели при построении модели, предсказывающей взятие ипотеки; построить прогнозную модель по истории международных футбольных матчей. Точкой отсчёта стали 44 штатных дата-сайентиста BCG, которые решили те же задачи без ИИ: их средний результат приняли за ноль, а всех остальных мерили как отставание от него в процентных пунктах.
На задаче с кодом консультанты без ИИ отставали от штатных специалистов на 63 пункта, с ChatGPT – на 14. На задаче со статистикой – на 32 и 12. На прогнозную модель – 43 и 26. Те, кто до эксперимента считал себя уверенным программистом, на коде и статистике разрыв закрыли: их отставание статистически не отличалось от нуля. На задаче с прогнозной моделью даже они остались на 20 пунктов позади.
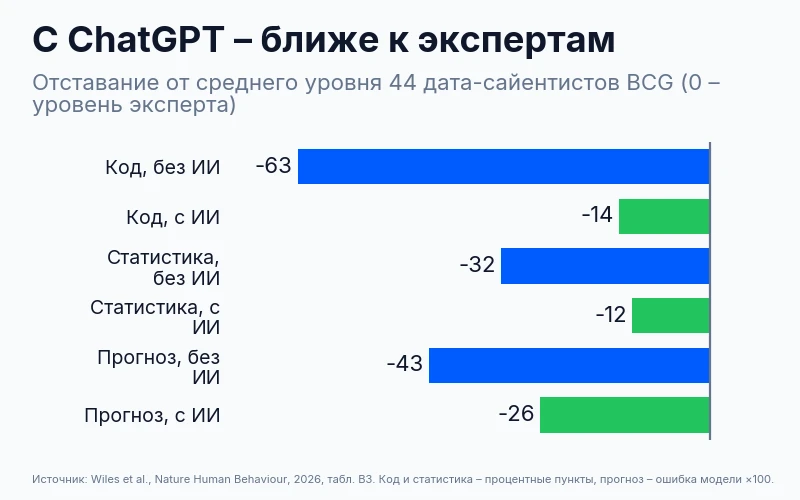
Ноль на этом графике – уровень штатных дата-сайентистов. Группа с ChatGPT сократила отставание на всех трёх задачах, но до нуля не дотянулась нигде.
Потом ChatGPT забрали. Участникам задали пять вопросов по тем же темам: один про код, один про вероятность, два про подготовку данных и один про то, к какому типу относится задача. В среднем обе группы ответили верно на 71% вопросов. Поровну. Разницы не оказалось ни на одном вопросе по отдельности, совместная проверка по всем пяти тоже ничего не показала.
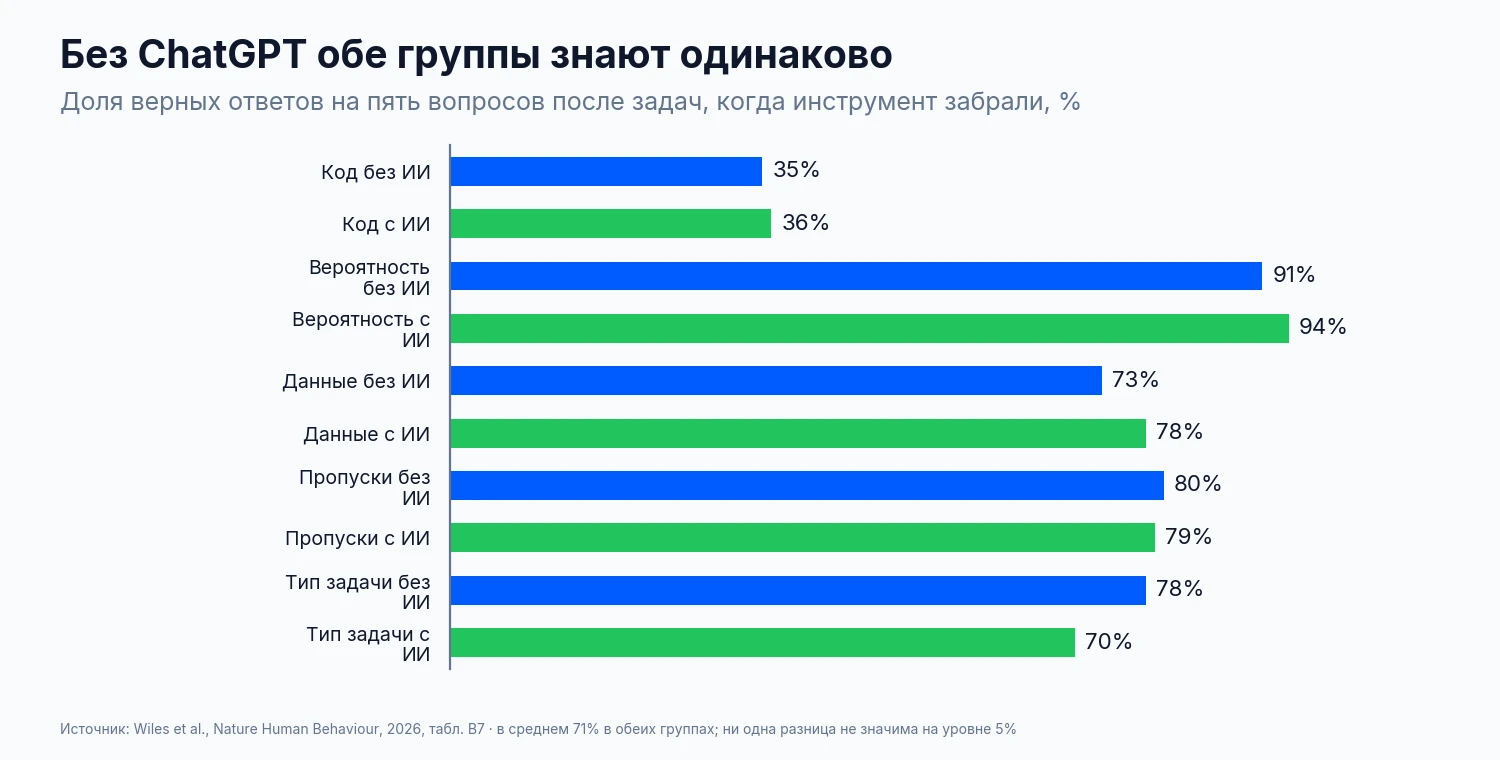
Пять вопросов по темам, на которых участники только что работали с моделью. Пары столбиков почти равны, и в среднем выходит ровно поровну.
Авторы описывают эффект одним образом: экзоскелет. Пока конструкция надета, человек поднимает больше, чем позволяют мышцы. Но мышцы от этого не растут. Для того, что здесь произошло, это самое короткое точное описание.
Третий результат авторы заранее не планировали и сами называют поисковым. До и после работы участников спрашивали, с какой вероятностью GPT-4 решит данную задачу. После работы с моделью участники стали заметно увереннее, что она справится, – и это на всех четырёх задачах, которые она решить не могла: выбрать города с чётным населением, поделить счёт на 10 долларов по позициям с разными ценами, нарисовать слово hello символами # и _, найти лучший ход в крестиках-ноликах. Из трёх задач, которые модель решала, на двух уверенность не изменилась.
Прежде чем делать выводы, три оговорки. Знания до эксперимента не замеряли, поэтому вывод «ChatGPT мешает учиться» отсюда не следует: сравнить можно только две группы между собой, и группа с моделью просто не обошла группу, которая искала ответы по старинке. Эксперимент прошёл в марте–апреле 2024 года на GPT-4, данным два с половиной года, и сегодняшние модели сильнее. Свободные ответы проверял GPT-4 Turbo по рубрике, сверял дата-сайентист – оценка частично машинная.
То же самое на совсем другой выборке мы разобрали 30 октября в статье про китайских школьников. Почти 27 тысяч школьников, 30 месяцев наблюдений. Оценки за домашние задания с ИИ выросли на 18%, время на домашку упало на 30%. Ежемесячные закрытые экзамены просели на 20%, вступительный экзамен чжункао – на 24%.
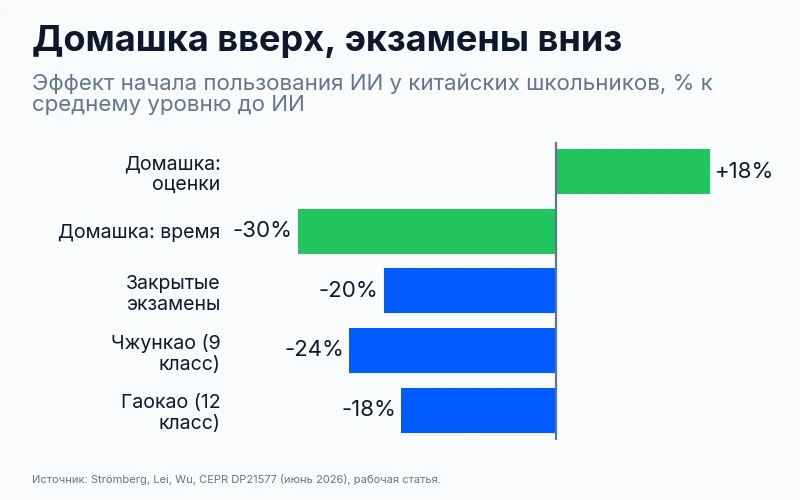
Домашние задания, которые можно делать с ИИ, пошли вверх, закрытые экзамены – вниз. Чем меньше возможности открыть модель во время проверки, тем заметнее падение.
Для менеджера обе выборки сводятся к одной проверке. Отчёт или скрипт, собранный сотрудником с ИИ, выглядит как работа сильного специалиста, а осталось ли что-то в голове у сотрудника, видно, только когда инструмент забрали и попросили объяснить решение. Результат виден в работе. Навык – только когда инструмент забрали.
→ Прочитать разбор эксперимента и взять промпт для проверки понимания
Кандидат принял код ИИ и не смог его объяснить
Речь про собеседование на программиста, где кандидат пишет код при интервьюере. Ещё недавно за открытый ChatGPT на таком собеседовании снимали с процесса. Теперь десять компаний сами сажают кандидата работать с ИИ-ассистентом: модель открыта в том же окне, предлагает куски решения, кандидат их принимает или отклоняет, а смотрят теперь на то, что он сделал с этими предложениями и может ли объяснить получившийся код. В шести случаях из десяти инструмент выбирает компания и ставит его внутрь своей среды, в трёх кандидат приносит свой, в одном – неясно.
Компания Nyrion, которая делает инструменты для технических собеседований, собрала такие случаи: Canva, Shopify, Meta, DoorDash, Amazon, Stripe, Coinbase, Google, Instacart, Atlassian. В июне 2025 года компания с таким форматом была одна.
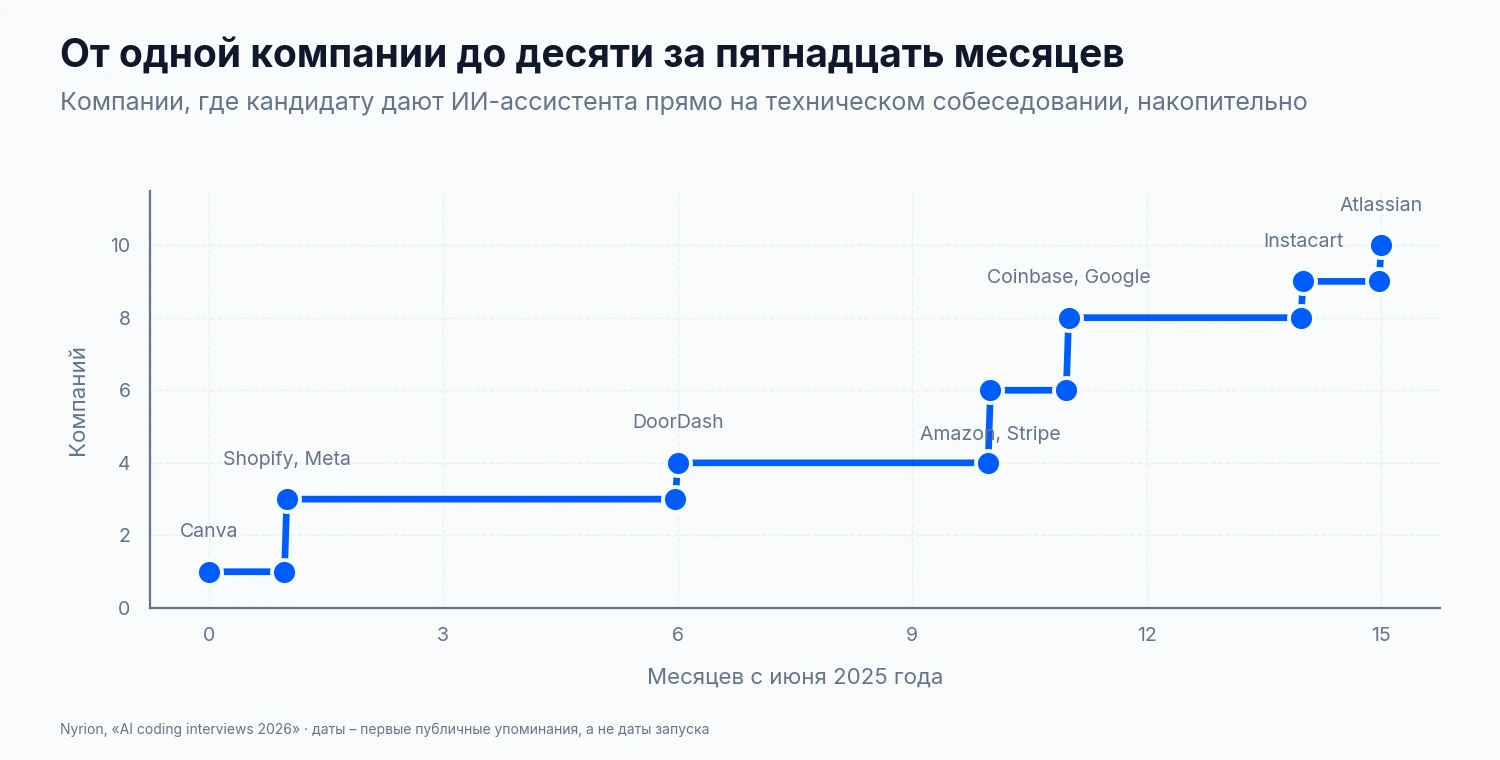
Пятнадцать месяцев назад так собеседовала одна компания. Список собран по первым публичным упоминаниям, поэтому реальные даты могут быть раньше.
Помощь работает. Первый сабмит проходил тесты в 87% попыток с подсказкой ИИ и в 53% без неё. А вот что люди делали с этой помощью: из 1 659 решений принять или отклонить предложенный моделью код 93% оказались «принять» – 1 546 принятий, 113 отклонений, 203 человека. Из 109 человек, решавших задачу пять раз и больше, 62 не отклонили ни одного предложения.
Дальше кандидатов попросили письменно объяснить собственный код. 497 ответов от 154 человек: полный ответ – 9%, частичный, где идея верна, а детали упущены, – 79%, неверный – 12%. Хотя бы один полный ответ дали 25 человек из 154. Открытые вопросы пропускали в 29% случаев; вопросы с готовыми вариантами – в 5%, и на них же 78% отвечали правильно.
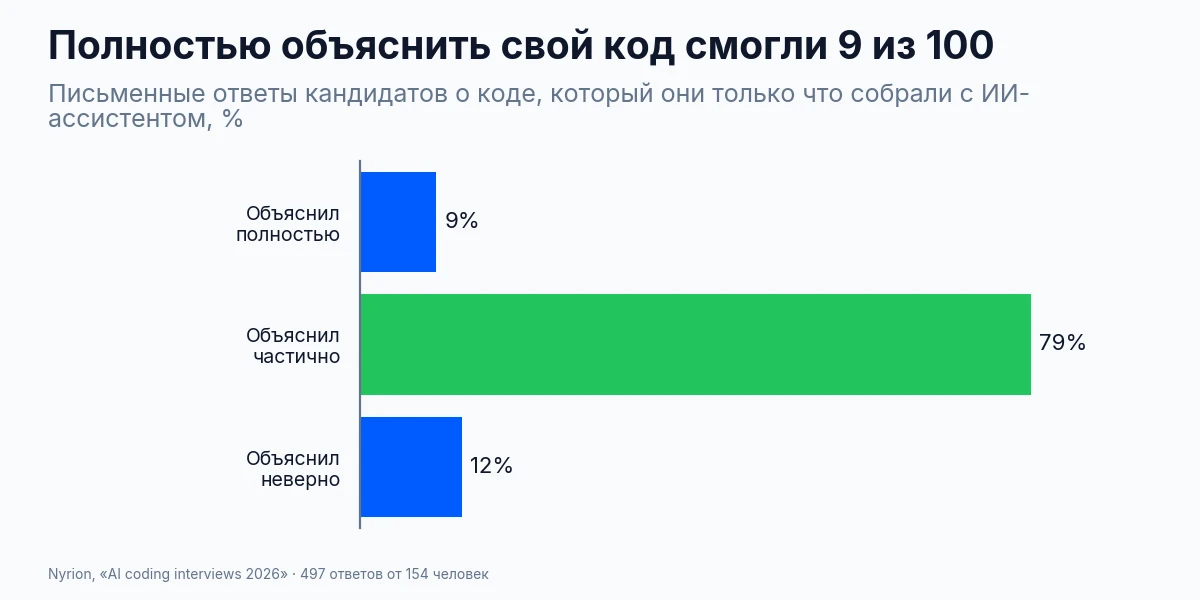
Из 154 человек хотя бы один полный ответ о своём коде дали 25.
В прошлом выпуске мы разбирали, как hh.ru отбирал Школу аналитиков среди тестовых заданий, часть которых написал ИИ: само подозрение на ИИ баллов не снижало, оценивали решение. Две истории складываются в одно правило: факт использования модели ничего не говорит о качестве работы.
Оговорка про источник. Nyrion продаёт платформу для собеседований и мерил на её участниках, а не на реальных кандидатах десяти компаний выше; даты в их таблице – первые упоминания инструмента, а не даты запуска.
Если вы нанимаете через тестовое задание, хватит одной переделки: добавьте к заданию один открытый вопрос о решении и задавайте его без инструмента – почему так, что сломается при других входных данных, от чего вы отказались. Один такой вопрос расскажет о кандидате больше, чем десяток задач, где код за него приняла подсказка.
За что компании платят и что получают
ActiveState через LeadDev опросила больше 300 руководителей по безопасности, управлению, платформам и инженерии в компаниях от 1 000 сотрудников в Северной Америке и Западной Европе. Инженеры тратят минимум 139 часов в год – больше 17 рабочих дней – на переделку кода, написанного ИИ; авторы сами называют оценку консервативной. Половина организаций говорит, что новые зависимости попадают в продакшен без проверки.
Уходит это время в основном на чужие библиотеки, которые модель притащила в код вместе с решением. Подключить готовый пакет, чтобы закрыть задачу, она готова охотно, а отвечать за его лицензию, за дыры в нём и за то, что автор завтра всё перепишет, будет не она. Разбираются с этим люди, и далеко не только инженеры: в 76% компаний из-за таких библиотек за год срывался релиз, в 58% за них прилетало замечание на аудите, в 32% за два года случился инцидент безопасности. Посчитать, во что это обходится, формально взялись 31%.
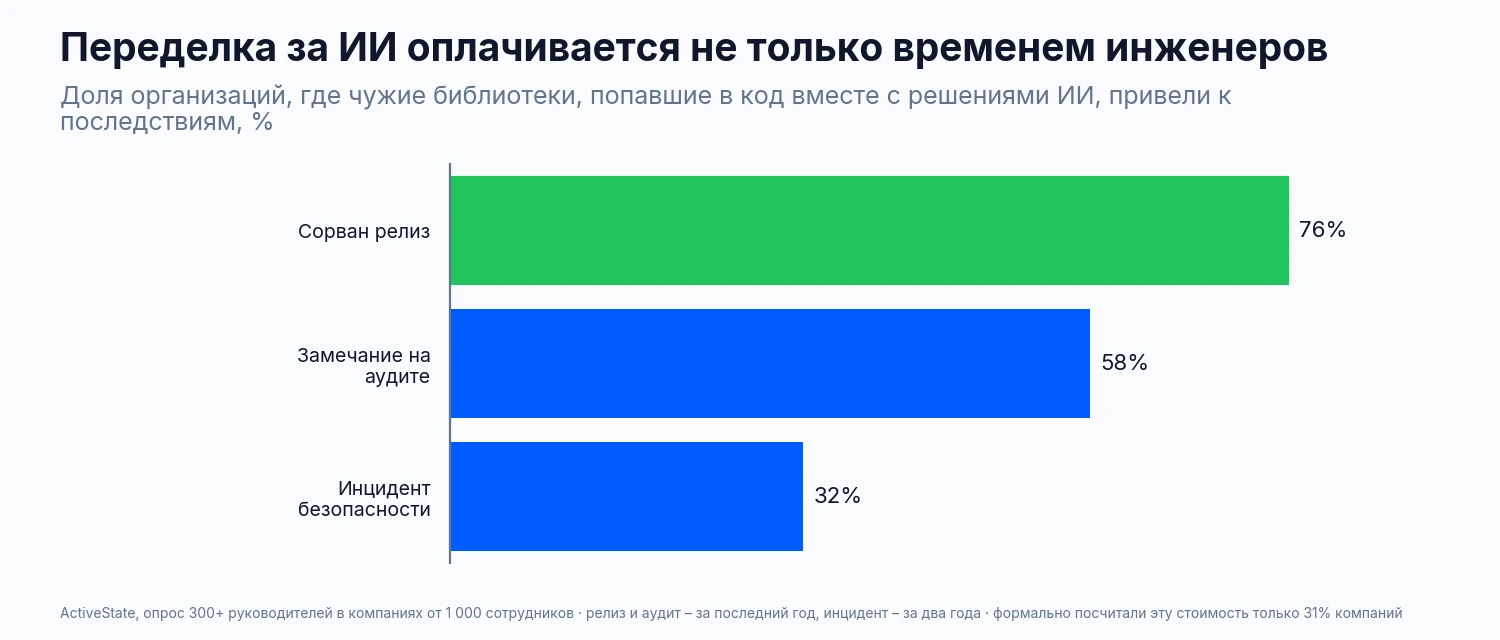
Инженерные 139 часов – только та часть счёта, которую видно. Остальное оседает в бюджетах операций, аудита и безопасности, где его обычно никто не складывает.
ActiveState продаёт управление зависимостями, так что интерес компании держим в голове.
Со стороны открытых проектов ту же картину замерил Linux Foundation – отчёт «Navigating Open Source Software Development in the Generative AI Era», опрос 234 участников и мейнтейнеров. Новость об этом отчёте разошлась под заголовком «четверть pull request – это мусор от ИИ», и цифра в отчёте действительно есть: в среднем мейнтейнеры оценивают в 25% долю входящих заявок на изменения, которые модель сделала наспех. Это их оценка на глаз, а не подсчёт заявок, и на крупных проектах она доходит до 31%, на маленьких падает до 20%. Там же 64% мейнтейнеров крупных проектов говорят, что проверка стала дольше, и называют выгорание главной своей проблемой.
Но самое интересное в отчёте – то, чего в новостях не было. Экономия времени от ИИ не одинакова и зависит от сложности задачи: на простых и средних задачах время экономят 79% и 83% опрошенных, на сложных – 64%, а 22% на сложных задачах тратят времени больше, чем тратили без модели. Авторы пишут прямо: выигрыш сужается и может развернуться в минус по мере роста сложности.
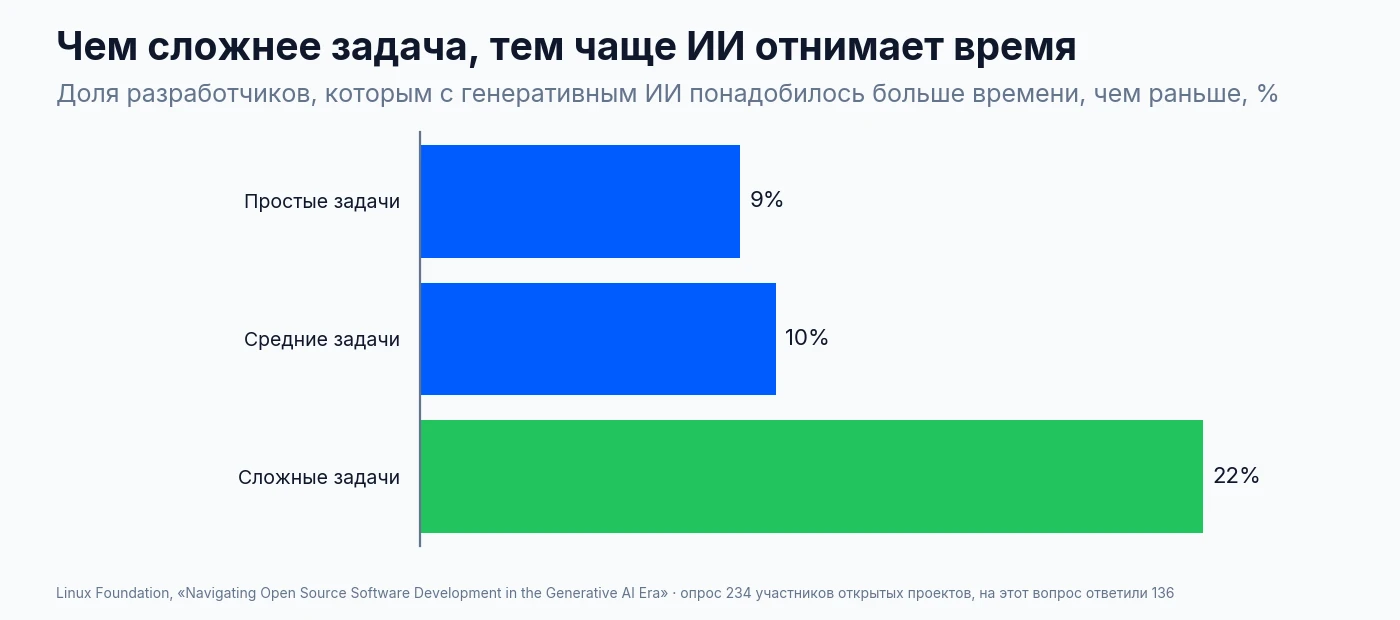
На сложных задачах каждый пятый тратит с ИИ больше времени, чем тратил без него. Экономят там всё равно 64% – но разворот начинается именно здесь.
Ещё одна деталь из отчёта, которой тоже не было в пересказах: мусор не обязательно навсегда. Проект curl в 2025 году тонул в отчётах об уязвимостях, написанных моделью, а к апрелю 2026 его руководитель Даниэль Стенберг сообщил, что поток мусора прекратился и вместо него приходят хорошие отчёты, почти все сделанные с помощью ИИ. Правила и давление проекта на качество работают.
Привычка во всех этих историях складывается раньше, чем заканчивается обсуждение бюджета. Исследователи Корнелла Shengqi Zhu, Jeffrey Rzeszotarski и David Mimno разобрали 140 тысяч чат-сессий примерно 8 тысяч пользователей: манера работы с моделью складывается и закрепляется быстро, на первых собственных попытках, а дальше человек почти не исследует. Долгосрочные исходы – возвращаемость, повторяющиеся формулировки – связаны с тем, как человек пробовал в начале. Авторы называют это парадоксом свободы действий: поле ввода ничем не ограничено, а пользуются им узко. Сколько именно времени есть у команды до того, как привычка затвердеет, из этих данных не следует.
Если манера работы складывается на первых попытках, важно, что человек пишет в поле ввода в первую неделю – и что в этот момент лежит в постановке задачи. В нашем замере одни и те же модели решают одни и те же задачи по-разному в зависимости от того, как поставлена задача: когда в ней есть правила, средний балл 76, когда правил нет – 49, когда просьба неясна – 45, и столько же, когда дан только исходный запрос.
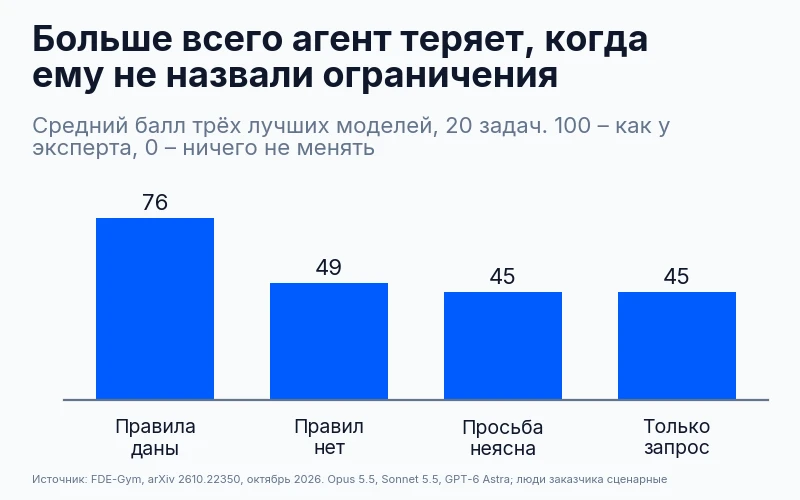
Одни и те же модели, одни и те же задачи, отличается только постановка. Правила в задаче подняли средний балл с 49 до 76, а неясная просьба работает так же, как полное отсутствие правил.
Расходы на инструменты усиливают то, что в команде уже есть, а то, чего в ней нет, токенами не докупить.
Что поменялось в инструментах
Сервис ClipJury трижды за 15 недель перечитал страницы условий и тарифов 175 ИИ-инструментов. Изменилось что-то, влияющее на право продавать сделанное, у 105 инструментов из 175. На их оценке 31 пункт сместился к большему риску для автора и только 6 – к меньшему, а 15 сервисов ужесточили коммерческие права на бесплатном тарифе сразу. 41 утверждение о том, что бесплатный тариф можно монетизировать, перестало подтверждаться текущими формулировками. По конкретике: Lexica в июне разрешала коммерческое использование бесплатных картинок, а 3 октября её условия потребовали «платный план Lexica». Suno на бесплатном тарифе пишет «нет коммерческих прав». Два сервиса озвучки исчезли. LOVO ушёл в ликвидацию (Chapter 7), домен play.ht не отвечает. К источнику стоит прислушаться и с другой стороны: ClipJury сам нашёл 18 мест, где его собственные данные были неверны, и написал об этом. Если ваша команда продаёт тексты, картинки или звук, сделанные ИИ, формулировки выбранного полгода назад инструмента могли успеть устареть – проверять стоит текущую страницу условий.
Что в этих формулировках вообще искать, мы разбирали в трёх статьях. В первой – что именно восемь платформ передают вам, а что оставляют себе, с таблицей по каждой. Во второй – как на это смотрят закон и суды в России, США, ЕС и Китае. В третьей – что делать, когда ваш материал копируют, а закон этому не мешает. Статьи вышли в январе, и правила платформ с тех пор поменялись как раз так, как описывает ClipJury, – таблицу из первой части стоит читать как образец того, какие пункты сверять, а не как актуальный список.
Подписки тоже переехали. Anthropic переименовала старшие тарифы Claude: Max 5x стал Max за $100 в месяц, Max 20x – Ultra за $200, а на подтверждённом Ultra сняли пятичасовой лимит. Подписчики ChatGPT Pro и Business могут запросить до $500 в месяц кредитами на API.
Движение в открытых моделях идёт в обе стороны. Mistral выложила открытые веса Mistral Large 4 – модель на триллион параметров, которую можно развернуть у себя; в их API она стоит $0,70 за миллион входных токенов, $0,07 за кэшированный вход и $2,10 за миллион выходных. Kimi K3.1 Pro – открытая модель, доступна в приложениях Kimi и через API, полные веса обещаны не позднее 4 ноября. Отдельно отметим: сам Kimi работает по карте «Мир» и без VPN, для российской команды это редкость. Тут так и хочется написать «открытые веса, значит развернём у себя», и я сам едва не написал: модель такого размера требует стойку серверных GPU, а не сервер. Z.ai двинулась в обратную сторону – GLM-5-Turbo стала полностью закрытой.
Google представила Gemini 4 Carbon по цене $2 и $10 за миллион токенов; модель возглавила Intelligence Index у Artificial Analysis. Доступна она только специалистам по кибербезопасности. В нашем бенчмарке её нет, и место среди замеренных нами моделей приписать ей нельзя.
У корпоративных клиентов Cursor дедлайн: 12 ноября заканчивается доступ к моделям OpenAI, мы писали об этом в прошлом выпуске. Kilo предлагает таким клиентам свой Enterprise бесплатно до конца их контракта с Cursor, максимум на 12 месяцев. Хорошая сторона для менеджера: способ не остаться без инструмента и без нового бюджета, пока рынок утрясается. Плохая: команда меняет редактор по чужой акции, а стоимость переезда и переучивания при этом никто не считает.
OpenAI предложила единый тег в robots.txt – файле, которым сайт объясняет роботам, что можно читать, – чтобы сайт запрещал обучение на своём контенте отдельно от обычной индексации; другие провайдеры идею поддержали. Если компания публикует контент, запрет теперь можно сформулировать точно: поисковые роботы остаются, обучение выключается.
С доступом из России у Anthropic, OpenAI и Google ничего не изменилось. Изменения цен и доступа мы записываем в ленту хаба агентов.
Что нового у нас
Мы пересобрали сайт. Он стал светлее, а собран теперь вокруг тех забот, с которыми к нам приходят чаще всего в этом году. Насколько они совпадают с вашими – любопытнее посмотреть, чем прочитать в пересказе.
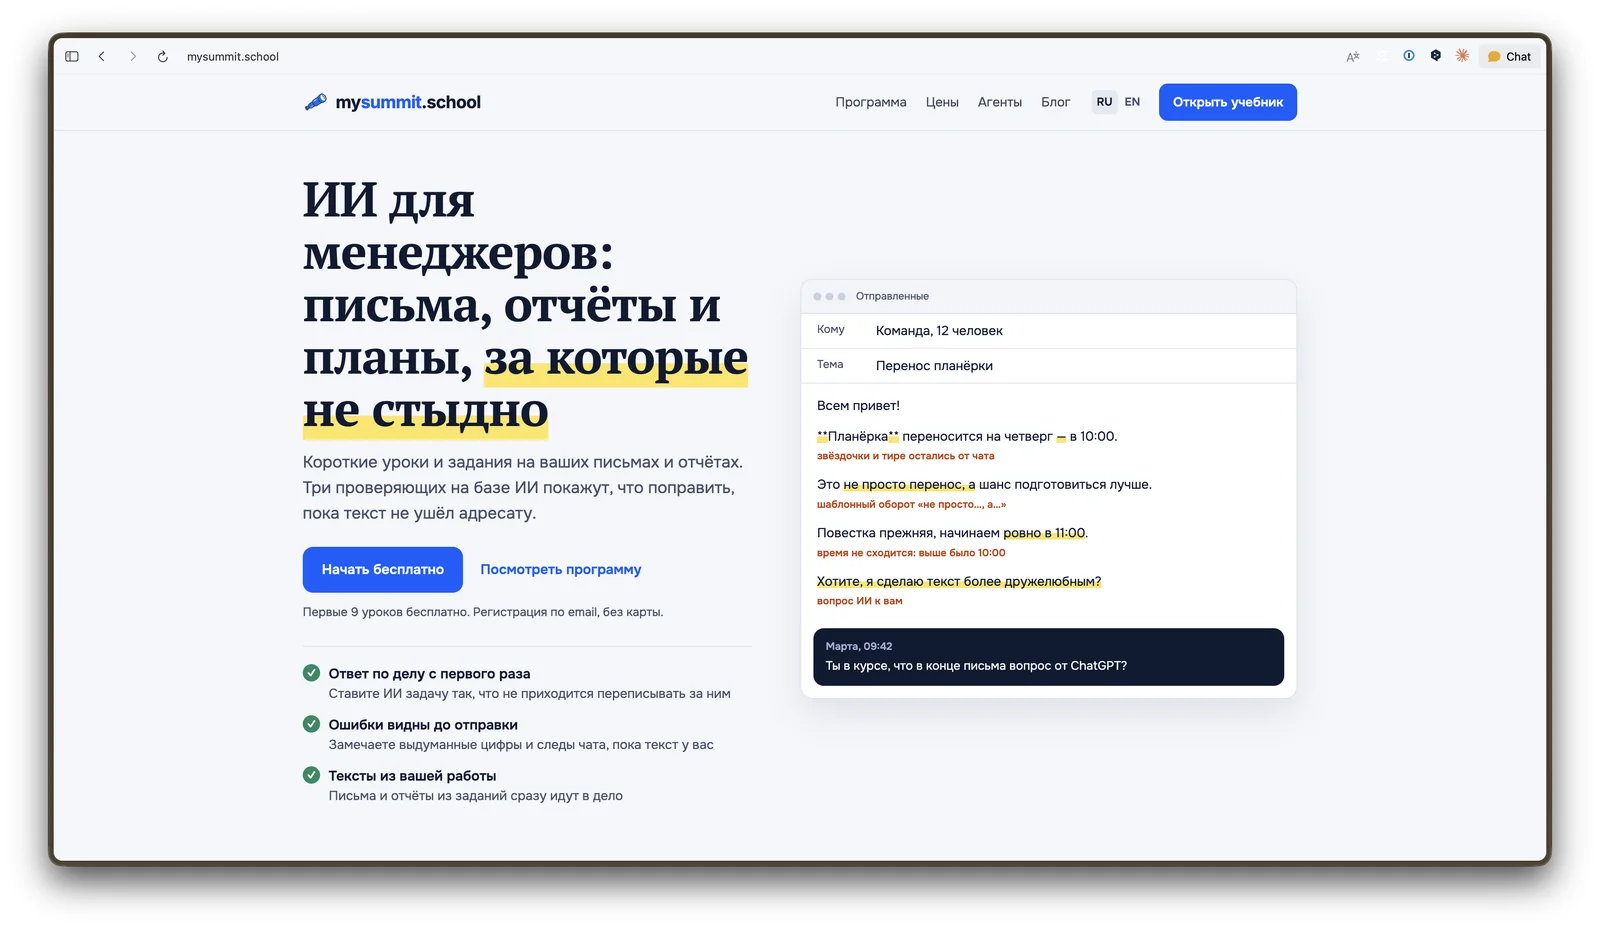
Первый экран. Если узнаёте здесь своё письмо, дальше можно не объяснять.
Появилась страница проверки сертификата по номеру, на русском и английском: сертификат можно положить в резюме так, чтобы работодатель проверил его сам.
И раз уж весь выпуск про то, что результат с ИИ перестал быть сигналом, проверьте это на себе: в игре «ИИ или человек?» мы показываем семь пар текстов, и в каждой паре один написан человеком. Три минуты. Там же есть английская версия, если хотите задачу потруднее: на чужом языке следы чата ловятся заметно хуже.
Идеи и ссылки
Anthropic выходит на биржу: Nasdaq, тикер ANT, роуд-шоу с 9 ноября. Цифры ниже – из самой формы S-1 на сайте SEC, в обновлённой версии добавили третий квартал. За девять месяцев 2026 года выручка – $33,2 млрд против $2,5 млрд за те же месяцы 2025-го, рост в тринадцать раз. Чистый убыток за те же девять месяцев – $104 млрд, и значительная его часть приходится на переоценку конвертируемых займов и похожих обязательств, за которой не стоит расход денег. На вычисления и инфраструктуру ушло $18,8 млрд, на людей – $4,9 млрд: счёт за железо вчетверо больше счёта за сотрудников.
Самая большая цифра в документе – другая. Anthropic пишет, что её обязательства по закупке вычислений и аренде, вместе с ещё не начавшимися договорами, составляют около $895 млрд, и многие из них оплачиваются независимо от того, будут мощности использованы или нет. Это при девятимесячной выручке в $33 млрд. Отдельной строкой в рисках – концентрация: пять крупнейших клиентов дают около четверти выручки и в большинстве своём долгосрочными контрактами не связаны. Для бюджета на инструменты вывод простой: поставщик, от которого зависит ваш процесс, сам живёт в режиме очень большой ставки, и цены с условиями будут качаться ещё долго.
В российской прессе этот сюжет разобрал The Bell – там же про то, что из тридцати крупных американских IPO за три года выше цены размещения торгуются десять.
Заказов от ИИ-агентов почти нет. DoorDash на звонке с аналитиками назвал число заказов от сторонних агентов: несколько сотен за всё время при 3 млн доставок в день по отчёту 2025 года. WIRED обошёл руководителей примерно 50 компаний: T-Mobile – «ничего значимого», Hilton – «незначительно», фитнес-сеть Life Time – ноль отмен подписок через агентов, индийская Eternal – «близко к нулю», eBay – «очень-очень мало». При этом Цукерберг на отчёте сказал, что Muse активировали больше 10 млн человек в США и Канаде и больше 25% пользовались им для покупок. Chipotle говорит, что агенты спотыкаются на оформлении заказа, и переделывает сайт под них. Обе картинки не могут быть неверными одновременно, а объяснения у меня нет. Если планируете продажи через агентов, строить на этих цифрах прогноз пока рано; оговорка общая для всех – компании отчитываются выборочно, а звонок с аналитиками место, где продают будущее.
Computer Science теряет студентов. National Student Clearinghouse опубликовал предварительные данные по набору осени 2026 года: на направлении Computer and Information Science набор продолжает резко падать, причём на всех уровнях сразу – минус 12,4% в четырёхлетних вузах, минус 12,3% в двухлетних и минус 10,4% в магистратуре и аспирантуре. Общий набор в высшее образование при этом стоит на месте (+0,2%), а на медицинских направлениях растёт, так что причина – в выборе специальности. Через несколько лет на рынок выйдет меньше новых разработчиков, и вместе с тем, что компании уже сейчас нанимают меньше джуниоров, вход в профессию сужается с двух сторон. Оговорка: оценки предварительные, окончательные Clearinghouse обещает в январе.
Мартин Фаулер написал про «голос LLM»: узнаваемая гладкость сгенерированного текста вызывает у читателей отторжение независимо от содержания. Его совет – не отдавать модели ни черновик, ни структуру, а начинать текст самому. Совет его собственный и спорный: есть команды, которые начинают с черновика модели и переписывают его, и читатели на это не жалуются. За своей реакцией следить всё равно полезно: если письма и документы команды стали выглядеть одинаково, причина, скорее всего, в этом.
Расширение claude-mem сливало историю промптов: установка версии 15.2.0 и выше отправляла на сервер cmem.ai историю промптов пользователя за последние 30 дней – без явного согласия и вопреки собственной политике конфиденциальности проекта. Для менеджера это про то, что расширения для агентов стоит проверять так же, как любой софт с доступом к работе команды: в историю промптов попадают данные клиентов и внутренние документы. Источник – публичный issue в репозитории проекта.
Агенты не делают резервную копию. В бенчмарке RegretBench современные агенты – GPT-5.6, Claude Opus 5, Gemini 3.7 – создают резервную копию данных перед опасным действием лишь в 15% случаев. Значит, там, где агент работает с боевыми данными, копию должен делать процесс, заранее и независимо от того, что решит модель. Оговорка: это бенчмарк с искусственными условиями, а не статистика реальных инцидентов, но 15% – достаточно низкая цифра, чтобы на неё не закладываться.
Новое в блоге
ИИ как экзоскелет: сотрудник справился, но не научился – разбор того самого эксперимента BCG на почти 500 консультантах, с промптом, который проверяет, понимает ли сотрудник собранный с ИИ скрипт.
Оценки вверх, знания вниз: ИИ и 26 811 китайских школьников – почти 27 тысяч школьников за 30 месяцев: оценки за домашку с ИИ выросли, закрытые экзамены просели.
ИИ знает о риске, но промолчит – два исследования из Казахстана и России о том, как модель выполняет задачу и молчит о рисках, о которых её не спросили, и одна строка в промпте, которая это меняет.
Почему ИИ-агент делает то, что просили, и не приносит пользы – пять проблем из исследования FDE-Gym и что менеджеру указать в постановке задачи до запуска.
Как читать ИИ-исследования: разбор статьи T-Tech о LIMe – пошаговый разбор чужой статьи: что проверять в первую очередь и какие выводы из цифр не следуют.
Возьмите одну работу, которую сотрудник недавно собрал с ИИ – скрипт, отчёт, анализ, – и попросите объяснить решение, не открывая инструмент. Если объяснить не получилось, начните со статьи из первого раздела: там есть готовый промпт для такой проверки.
Напишите в ответ, спрашиваете ли вы с команды объяснение решений, собранных с ИИ, и что из этого выходит. Особенно интересно, если после такой проверки вы поменяли то, какие задачи вообще отдаёте модели.
Открытый модуль бесплатный для всех: нужен только email, без карты. Кто его проходит, тому открывается скидка на платные треки. До конца ноября цены прежние, с декабря каждый модуль дорожает на 20–30%, так что начинать сейчас заметно дешевле: цены и состав.