Qwen d'Alibaba en 2026 : les poids ouverts reviennent au sommet de la gamme
Modèles d’IA dans cet article
Pendant que les managers paient ChatGPT Plus et Claude Pro, Alibaba a bâti l’un des plus vastes écosystèmes d’IA au monde – chat gratuit, modèles ouverts et tarifs d’API plusieurs fois inférieurs à ceux de la concurrence. Qwen (prononcez « tchouène », de 通义千问 – « Mille questions ») a dépassé mi-2026 tous ses équivalents occidentaux en nombre de téléchargements, et c’est devenu un outil que tout manager devrait connaître. Au printemps, l’écosystème semblait prendre le chemin d’OpenAI et d’Anthropic : les modèles phares de la série 3.7 sont sortis fermés, des développeurs clés sont partis. En août, Alibaba a publié trois modèles et fait demi-tour. Le modèle phare Qwen3.8-Max est promis avec des poids publiés, et Qwen3.8-27B, sous licence Apache 2.0, tourne sur une seule carte graphique grand public.
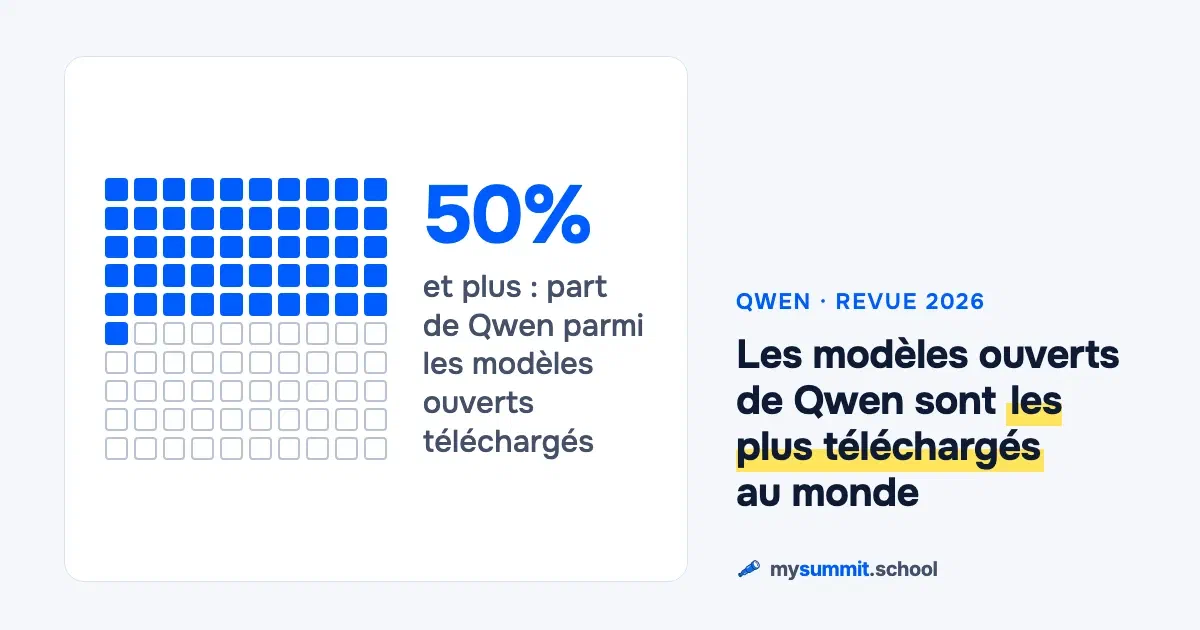
L’argument principal de Qwen pour un manager est simple : c’est un assistant IA complet, accessible gratuitement via Qwen Chat – sans abonnement ni plafond de requêtes. En avril 2026, les modèles Qwen approchaient le milliard de téléchargements, soit plus de 50 % de tous les téléchargements de modèles ouverts dans le monde. L’application grand public compte plus de 200 millions d’utilisateurs actifs mensuels, troisième rang mondial derrière ChatGPT et DouBao.
Qu’est-ce qui distingue Qwen ?
Ce qui distingue Qwen de la plupart de ses concurrents, c’est l’échelle et la souplesse. Alibaba publie une grande partie de ses modèles en accès libre sur Hugging Face : n’importe quelle entreprise peut les télécharger et les déployer sur ses propres serveurs. Oylan, le modèle de langue national du Kazakhstan, fait partie des projets bâtis sur Qwen. Cet été, les poids ouverts ont cessé d’être réservés aux modèles de milieu de gamme : Alibaba a annoncé qu’elle publierait aussi ceux de son modèle phare, Qwen3.8-Max. La série 3.7, elle, reste fermée et accessible uniquement par API.
- La plupart des modèles Qwen sont disponibles au téléchargement pour tourner sur votre propre serveur. Pour les entreprises soumises à des exigences strictes de sécurité des données, les modèles ouverts – Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen 4 Coder et toute la famille Qwen 3.5 – restent parmi les meilleurs au monde.
- Les modèles phares reposent sur la spécialisation : chaque requête n’est traitée que par le groupe d’experts concerné, une petite partie active du modèle. Concrètement, un modèle qui tourne sur un ordinateur portable donne aujourd’hui des réponses qui exigeaient hier un matériel serveur coûteux.
- Les modèles texte de la série Qwen3 prennent en charge 119 langues et dialectes, les versions les plus récentes 201.
- Texte, images, vidéo, audio, synthèse vocale : tout est dans le même écosystème.
Ce que sait faire Qwen en septembre 2026
La gamme Qwen couvre aujourd’hui presque tous les types de tâches qu’une entreprise rencontre :
- Un modèle phare promis en accès ouvert. Qwen3.8-Max (disponibilité générale le 3 août 2026) est un MoE clairsemé de 2,4 billions de paramètres, dont environ 95 milliards actifs à chaque passe. Contexte de 1 million de tokens ; il accepte en entrée texte, images et vidéo. Tarif : 2,00 $/6,00 $ par million de tokens.
- Déploiement local avec vision. Qwen3.8-27B (13–14 août) : un modèle dense de 27–28 milliards de paramètres doté d’un encodeur visuel, contexte de 262 K, licence Apache 2.0 et environ 17 Go en quantification Q4_K_M – une carte graphique, ou un portable avec 16 Go de mémoire.
- Douze fois moins cher. Qwen3.8-Flash-Next (26 août) : une préversion ouverte de l’architecture Qwen4 – 125 milliards de paramètres, 6 milliards actifs par token, environ 0,16 $/0,47 $ par million de tokens.
- Des agents d’un nouveau genre. Qwen 3.7 Max (mai 2026) est conçu comme un « modèle agentique » : il enchaîne en autonomie plus de 1 000 appels d’outils dans une même session sans perte de qualité. Contexte de 1 million de tokens, et le taux d’hallucination le plus bas parmi les modèles phares (22,9 %).
- Un agent multimodal. Qwen 3.7 Plus (disponibilité générale le 1er juin 2026) comprend texte, images et vidéo, voit l’écran et renvoie les coordonnées des éléments d’interface (GUI agent grounding). Contexte de 1 million de tokens.
- Un nouveau cap en programmation. Qwen 4 Coder 32B-A3B (2 juin 2026) est le premier modèle ouvert à atteindre 82 % sur SWE-Verified. Architecture MoE : 32 milliards de paramètres, dont 3 milliards seulement actifs – il tourne sur un Mac doté de 24 Go de mémoire à 58 tokens/s. Licence Apache 2.0.
- Les documents longs. Qwen3.6-Plus garde en mémoire jusqu’à 1 million de tokens, soit environ 2 000 pages A4 en une seule requête. Chargez un rapport annuel complet, une base de tickets clients ou un dépôt de code entier, et interrogez l’ensemble.
- Le raisonnement complexe. Qwen3.7-Max en mode chaîne de raisonnement obtient 92,4 % sur GPQA Diamond – devant Claude Opus 4.6 Max (91,3 %) et K2.6 Thinking (90,5 %). En mathématiques (Apex Math) : 44,5 % contre 34,5 % pour Claude Opus 4.6 Max.
- La programmation agentique. Qwen3.6-35B-A3B fonctionne avec Claude Code, Qwen Code et des outils similaires, et résout des tâches au niveau de Claude Sonnet 4.5 pour un coût bien moindre. Licence ouverte : on peut l’héberger en interne.
- Voix et vidéo dans un même modèle. Qwen3.5-Omni comprend simultanément texte, images, audio et vidéo dans une architecture unique. C’est sur lui que repose l’« Audio-Visual Vibe Coding » : on décrit la tâche à voix haute en montrant son écran, et le modèle génère le code.
- Génération d’images et de voix. Qwen-Image-2512 produit des images photoréalistes avec un rendu fidèle du texte sur plusieurs lignes – une rareté chez les modèles génératifs. Qwen3-TTS synthétise la parole avec clonage de voix, pour la narration et les assistants vocaux.
- Troisième du classement vision de LMArena. Qwen3.8-Max obtient 1 300 ± 8 et ne laisse passer devant lui que deux modèles d’Anthropic. Les intervalles des neuf premiers se chevauchent : c’est un peloton serré, et les premières places se jouent dans la marge d’erreur.
Les principaux modèles Qwen (septembre 2026)
En septembre 2026, Alibaba dispose de l’une des gammes de modèles les plus larges du secteur.
Qwen3.8-Max – le modèle phare qu’Alibaba a promis d’ouvrir (août 2026)
Qwen3.8-Max est passé en disponibilité générale le 3 août 2026, puis a reçu les 2 et 3 septembre une mise à jour de post-entraînement estampillée 0902. Il ne figure pas encore dans notre benchmark : les données ci-dessous viennent de l’éditeur et de plateformes indépendantes.
L’architecture est un mélange d’experts clairsemé : 2,4 billions de paramètres au total, environ 95 milliards actifs à chaque passe. Contexte de 1 million de tokens, réponse maximale de 131 072 tokens. Le modèle accepte texte, images et vidéo, renvoie du texte ; le raisonnement est activé par défaut. Il gère les appels d’outils et la sortie structurée selon un schéma JSON dans response_format. Tarif par million de tokens : 2,00 $ en entrée, 6,00 $ en sortie, 0,25 $ pour la lecture du cache.
Ce qu’annonce Alibaba :
- OSWorld-Verified – 86,1, contre 83,2 pour GPT-5.6 Sol Max, 85,0 pour Claude Fable 5 et 76,2 pour Gemini 3.1 Pro
- PaperBench – 93,0, le meilleur résultat publié sur ce benchmark
Ce sont les chiffres de l’éditeur, obtenus sur ses propres tests : à prendre comme tels.
Les plateformes indépendantes confirment l’essentiel. Sur LMArena, Qwen3.8-Max est troisième du classement vision avec 1 300 ± 8, juste derrière claude-fable-5 (1 313) et claude-opus-4-7-high (1 301). Mais l’intérêt de ce classement est ailleurs : une source secondaire présentait la version Max comme purement textuelle, et le tableau vision règle la question. La mise à jour 0902 a pris la première place de Code Arena WebDev avec 1 691 – trois points devant Claude Opus 5 Max et vingt-deux devant la version 3.8-Max d’origine.
Sur Artificial Analysis, Qwen3.8-Max obtient 47 points à l’indice d’intelligence, pour un prix mixte de 1,19 $ par million de tokens. Gemini 3.8 Flash obtient le même score pour 0,74 $. Un chiffre à retenir : 40 tokens par seconde en sortie, le plus mauvais résultat du top 10 – Gemini 3.8 Flash en produit 334. Le modèle phare de Qwen est lent, et en usage interactif, on le sent sans avoir besoin de benchmark.
Qwen3.8-Flash-Next – douze fois moins cher que le modèle phare (26 août 2026)
Une préversion ouverte de l’architecture Qwen4. 125 milliards de paramètres au total, 6 milliards actifs par token, plus une couche d’embeddings N-gram de 51 milliards de paramètres qui réside en mémoire vive ordinaire et n’occupe pas la mémoire de la carte graphique. C’est en somme un dictionnaire des combinaisons de mots fréquentes : inutile de le garder sur le GPU, d’où l’économie.
Contexte natif de 262 144 tokens, jusqu’à 1 million via YaRN. Tarif : environ 0,16 $ en entrée et 0,47 $ en sortie par million de tokens, l’entrée mise en cache coûtant environ 89 % de moins. C’est à peu près douze fois moins que Qwen3.8-Max.
Le modèle n’est pas dans notre benchmark et, au moment de la rédaction, il n’apparaissait pas non plus sur les plateformes indépendantes. On ne dispose que des chiffres de l’éditeur : DeepSWE 58,7 et SWE-bench Pro 62,5 en code, plus CoWorkBench 73,9 et JobBench 55,7. Alibaba affirme aussi que Flash-Next dépasse Qwen3.7-Plus pour environ un neuvième du coût d’entraînement, et qu’il fait mieux que DeepSeek-V4-Flash (284B) et Claude Opus 4.6 sur la plupart des tâches testées. Impossible de le vérifier pour l’instant : considérez-le comme une promesse.
Les poids sont sur Hugging Face et ModelScope sous Qwen Community License ; l’hébergement passe par l’API QwenCloud.
Poids ouverts et licences
Trois modèles d’une même génération sont sortis sous trois régimes juridiques différents, et pour un manager, c’est plus important que les scores.
- Qwen3.8-27B – Apache 2.0. Aucune condition : on peut l’intégrer à des produits commerciaux, l’affiner, le revendre.
- Qwen3.8-Flash-Next – Qwen Community License. C’est un texte propre à Alibaba, à lire avant tout déploiement.
- Qwen3.8-Max – pour la première fois, un modèle de classe Max est promis en accès ouvert, mais il serait assorti d’une licence maison, restrictive pour les entreprises qui tirent plus de 50 millions de dollars de revenus de services d’IA. Ce n’est pas de l’Apache 2.0.
Et puis il y a la physique. En FP8, Qwen3.8-Max pèse environ 2,5 To de poids : on est au niveau du data center. Pour lui, des poids ouverts signifient la possibilité d’étudier le modèle et, avec le matériel et la licence adéquats, de le déployer.
Un seuil de chiffre d’affaires comme condition de licence n’a rien d’unique : Kimi K3 le fixe à 20 millions de dollars. La conclusion pratique est simple : « modèle à poids ouverts » sans le nom de la licence ne veut rien dire.
Qwen 3.7 Max – le modèle phare agentique (mai 2026)
 Qwen 3.7 MaxComprend les tâches simples
score 5,8/10 rang 48 sur 74 $0,037 par tâche sans VPN
Testé dans le benchmark mysummit.school : mai 2026À propos du modèle →Comparer →
Qwen 3.7 Max (qu’on écrit aussi Qwen3.7-Max) a été annoncé à l’Alibaba Cloud Summit le 20 mai 2026, après une apparition discrète sur LM Arena le 14 mai. La série 3.7 comprend deux modèles : Qwen3.7-Max (modèle phare texte pour le raisonnement et les tâches agentiques) et Qwen3.7-Plus (agent multimodal, disponible depuis le 1er juin 2026).
Caractéristiques clés de Qwen3.7-Max :
- Contexte de 1 million de tokens – contre 256 K pour Qwen 3.6 Max
- Architecture agentique – le modèle peut mener des sessions autonomes de 35 heures, en enchaînant plus de 1 000 appels d’outils successifs sans perte de qualité. Lors de la démonstration au sommet, il a optimisé seul un noyau de calcul : plus d’un millier de modifications de code et une inférence dix fois plus rapide
- Le taux d’hallucination le plus bas parmi les modèles phares – 22,9 %
- Mode « Thinking » – une chaîne de raisonnement activable, visible dans l’interface de Qwen Chat
Résultats sur les benchmarks :
| Benchmark | Qwen3.7-Max | Comparaison |
|---|---|---|
| Intelligence Index v4.0 | 56,6 | 5e mondial, 1er parmi les modèles chinois |
| GPQA Diamond | 92,4 % | Devant Claude Opus 4.6 Max (91,3 %) |
| Apex Math | 44,5 % | Devant Claude Opus 4.6 Max (34,5 %) |
| MRCR-v2 128K (contexte long) | 90,4 % | Devant Qwen3.6-Plus (85,9 %) |
| Terminal-Bench Hard (code) | 50,8 % | – |
Qwen3.7 n’est accessible que par API : la série n’a pas de poids ouverts, et Alibaba n’a donné aucun calendrier de publication. La génération suivante a rompu avec cette logique : 3.8-Max est promis en accès ouvert, et 27B comme Flash-Next sont sortis avec des poids publics.
Qwen 3.7 Plus – l’agent multimodal (disponible depuis le 1er juin 2026)
Qwen 3.7 PlusComprend les tâches simples
score 5,6/10 rang 54 sur 74 $0,006 par tâche sans VPN
Testé dans le benchmark mysummit.school : juillet 2026À propos du modèle →Comparer →
Qwen3.7-Plus est apparu sur LM Arena le 14 mai en préversion, avant de passer en disponibilité générale le 1er juin 2026. C’est la version multimodale de la série 3.7 : le modèle accepte texte, images et vidéo, et renvoie du texte.
Ce qui le distingue de Qwen3.7-Max :
- GUI Agent Grounding – le modèle « voit » une capture d’écran et renvoie les coordonnées exactes, au pixel près, des éléments d’interface. De quoi créer des agents autonomes qui pilotent des applications visuellement, sans API
- Contexte de 1 million de tokens, jusqu’à 65 536 tokens en sortie, budget de raisonnement interne jusqu’à 256 K tokens
- Paramètre
preserve_thinking– conserve l’état du raisonnement entre les appels d’outils dans une boucle agentique - Coût par tâche – dans la fiche ci-dessus ; parmi les modèles multimodaux, Plus est l’une des options les moins chères
Qwen 3.7 Plus est un modèle fermé (API uniquement, sans poids ouverts). Pour un manager, c’est un signal important : les modèles multimodaux les plus capables de la série 3.7 ne sont accessibles que via l’API cloud, sans déploiement local possible. Avec l’arrivée de Qwen3.8-27B, doté de la vision et sous Apache 2.0, cet argument a nettement perdu de son poids.
Qwen3.6-Plus – le modèle phare au contexte de 1 million de tokens
Qwen 3.6 PlusComprend les tâches simples
score 6,1/10 rang 44 sur 74 $0,011 par tâche sans VPN
Testé dans le benchmark mysummit.school : mai 2026À propos du modèle →Comparer →
Sorti en avril 2026 en réponse à Gemini 2.5 et GPT-5. Son architecture hybride combine attention linéaire et mélange d’experts clairsemé, ce qui lui permet de traiter des documents gigantesques sans perdre en vitesse.
- Jusqu’à 1 million de tokens de contexte : un rapport annuel ou un dépôt de code complet passe en une seule requête, sans découpage.
- 78,8 % sur SWE-bench Verified – presque le niveau des modèles phares fermés en programmation.
- Audio-Visual Vibe Coding : décrivez la tâche à voix haute et montrez une maquette à la caméra, le modèle génère le code.
- Licence Apache 2.0 – on peut télécharger les poids et le faire tourner en local.
Qwen3.5 – une famille de modèles multimodaux
Sortie en mars 2026, disponible sur Microsoft Azure. La différence fondamentale : ces modèles « comprennent » texte, images, audio et vidéo comme un tout, dans une architecture unique. Une même question peut renvoyer à la fois à un document chargé, une capture d’écran, un extrait vidéo et un contexte textuel.
La série couvre toute la gamme, de 0,8 milliard de paramètres (tourne sur un smartphone) à 397 milliards (comparable à GPT et Claude) :
- Qwen3.5-4B / 9B – les plus « intelligents » de leur catégorie de poids ; ils tournent sur un portable et battent des modèles deux à trois fois plus gros. Et même sur un téléphone.
- Qwen3.5-27B – respect strict des consignes : rapports structurés, remplissage de formulaires, missions en plusieurs étapes.
- Qwen3.5-35B-A3B – l’équilibre entre qualité et vitesse : 35 milliards de paramètres, dont 3 milliards seulement actifs.
- Qwen3.5-122B-A10B – analyses complexes et grands volumes d’information.
- Qwen3.5-397B-A17B – le modèle phare open source ; sur GDPval-AA, il devance son prédécesseur Qwen3-235B de 361 points. Troisième meilleur modèle open source au monde.
Cet automne, la famille reste pertinente et toujours entièrement sous Apache 2.0, avec la vision sur toutes les versions jusqu’à 27B inclus. Repères matériels : 0,8B tourne sur un portable sans carte graphique et occupe environ 0,6 Go, 2B tient sur une RTX 3060 ou un M1, 9B sur une carte de 16 Go, 27B sur une RTX 4090. Toutes les versions ont 256 K de contexte natif ; les couches hybrides d’attention linéaire suppriment la pénalité habituelle du cache KV. Sur les machines limitées par le processeur ou la bande passante mémoire, 35B-A3B va environ cinq fois plus vite que le 27B dense. 122B-A10B et 397B-A17B sont purement textuels et demandent plusieurs H100.
Points communs à toute la série :
- Environ 400 pages A4 par requête ; si nécessaire, le contexte s’étend jusqu’à l’équivalent d’un petit livre.
- Deux modes – « Réfléchir » (raisonnement pas à pas pour les tâches complexes) et « Ne pas réfléchir » (réponses instantanées pour la routine) – se basculent au sein du même modèle, sans changer de service.
- Prise en charge de 201 langues.
- Sur les tests indépendants, il rivalise avec les meilleurs modèles multimodaux pour un coût bien moindre.
Le basculement entre modes est la vraie trouvaille de Qwen3/3.5. Plus besoin de choisir entre un modèle « intelligent » et un modèle « rapide » : le même s’adapte à la difficulté de la tâche. Raisonnement approfondi pour analyser un rapport financier, réponse instantanée pour « la réunion, c’est à quelle heure ? ».
Qwen3-235B – le modèle phare texte open source
Sorti en avril 2025, entraîné sur deux fois plus de données que la génération précédente. Son architecture spécialisée atteint une qualité de modèle phare pour un coût de calcul nettement inférieur – une différence sensible quand on passe par l’API.
- Modèle ouvert : toute entreprise peut le télécharger et le faire tourner sur ses serveurs. Il faudra un matériel serveur sérieux.
- Le modèle « réfléchit » avant de répondre et vérifie sa logique pas à pas. C’est important pour les calculs complexes, l’analyse juridique, la planification financière.
- Qwen3-Max en est la version cloud via API, pour ceux qui ne veulent pas gérer d’installation serveur.
- Jusqu’à 200 pages A4 par requête ; jusqu’à 400 en mode étendu.
Qwen3-30B – le choix optimal pour un serveur d’entreprise
Un modèle de classe entreprise : rapide et peu coûteux malgré sa taille. Il surpasse des modèles plus anciens qui demandaient trois fois plus de ressources.
- Pour les équipes qui veulent un assistant puissant sur leur propre serveur, sans financer un data center entier.
- Jusqu’à 200 pages A4 par requête.
Qwen3-Coder-Next – un modèle pour les développeurs (février 2026)
Un modèle spécialisé dans l’écriture et la revue de code. Sur les tests indépendants, il bat les modèles de DeepSeek et tient la comparaison avec Claude Sonnet 4.5.
Pour un manager, c’est plutôt un outil pour l’équipe de développement. Le modèle peut garder en mémoire un projet entier, y compris tous les fichiers du dépôt. Le faire tourner sur son propre serveur demande environ 51 Go de RAM.
Qwen 4 Coder – le premier codeur open source à 82 % sur SWE-Verified (juin 2026)
Qwen 4 Coder 32B-A3B, sorti le 2 juin 2026, est le premier modèle qui marque le passage à la quatrième génération de Qwen, et le premier modèle ouvert à franchir 80 % sur SWE-Verified, un benchmark corrélé à la productivité réelle d’un développeur.
- Architecture MoE : 32 milliards de paramètres au total, 3 milliards actifs par token. Contexte de 256 K
- 82 % sur SWE-Verified – devant Devstral, Qwen3.6-Coder et tous les modèles qui tournent sur un portable
- Tourne sur un Mac de 24 Go : 58 tokens/s sur un M4 Pro – utilisable pleinement sans serveur
- Entraîné sur de vrais tests : contrairement à ses prédécesseurs, Qwen 4 Coder a été entraîné par apprentissage par renforcement sur les résultats de tests issus de vrais tickets GitHub
- Licence Apache 2.0 – les mêmes libertés que Qwen3.8-27B : produits commerciaux, affinage, revente
Pour un DSI ou un responsable du développement, Qwen 4 Coder est une bonne raison de revoir le budget d’abonnements : un modèle qui tourne sur le portable d’un développeur traite des tâches au niveau des modèles phares du cloud.
La gamme impressionne, mais choisir le bon modèle n’est qu’une partie du travail. En août, Alibaba a publié trois modèles, chacun avec sa vocation : un modèle phare pour le raisonnement complexe, un modèle compact à faire tourner chez soi et un modèle bon marché pour les flux agentiques à gros volume. Entre « obtenir une réponse » et « obtenir un résultat fiable », la différence tient à la façon de formuler la demande et de vérifier ce qui revient. C’est précisément l’objet de notre module gratuit.
Qwen3-VL – analyse d’images et de documents
Comprend les images, les vidéos (de plus d’une heure), les PDF et l’écriture manuscrite. La reconnaissance de texte fonctionne dans 32 langues : chargez le scan d’un contrat ou la photo du tableau blanc après une réunion, vous obtenez un texte structuré.
Qwen3.5-Omni – la multimodalité native (mars 2026)
Texte, images, audio et vidéo sont traités par une architecture unique, sans encodeurs séparés. Selon les mesures d’Alibaba, il obtient les meilleurs résultats de sa catégorie sur 215 tâches de compréhension audio et audiovisuelle. Il gère l’entrée et la sortie vocales en temps réel, la recherche web intégrée et l’appel d’outils externes. C’est sur Omni que repose l’Audio-Visual Vibe Coding : le développeur décrit ses besoins à voix haute et montre l’interface en vidéo, le modèle écrit le code.
Qwen3-TTS et Qwen-Image-2512 – la voix et l’image
Qwen3-TTS (licence ouverte) assure la synthèse vocale avec clonage de voix et génération en streaming, pour les assistants vocaux et la narration. Qwen-Image-2512 est un modèle de génération d’images mis à jour, avec un rendu photoréaliste et un texte de qualité : inscriptions sur plusieurs lignes, paragraphes, éléments de marque – précisément là où Midjourney et DALL-E échouent.
Les modèles à faire tourner en local
Alibaba propose une gamme de modèles compacts à faire tourner sur votre propre matériel, du portable au serveur d’entreprise :
| Où le faire tourner | Modèle | Document max. | Pour quelles tâches |
|---|---|---|---|
| Smartphone ou tablette | Qwen3-0.6B | ~50 p. | Autocomplétion, suggestions simples |
| Portable standard (4 Go de RAM) | Qwen3-1.7B | ~50 p. | Brouillons d’e-mails, résumés courts |
| Portable puissant (8 Go de RAM) | Qwen3-4B | ~50 p. | Analyse de documents, qualité équivalente aux anciens meilleurs modèles |
| Poste de travail (16 Go de RAM) | Qwen3-8B | ~200 p. | Documents complexes, tableaux, longs échanges |
| Serveur de service (32 Go de RAM) | Qwen3-14B | ~200 p. | Un véritable assistant d’équipe |
| Serveur d’entreprise (48 Go de RAM) | Qwen3-32B | ~200 p. | Qualité proche des meilleurs modèles cloud |
| Grappe de serveurs (140 Go et plus) | Qwen3-235B | ~400 p. | Qualité de modèle phare, rivalise avec GPT et Claude |
Si votre entreprise ne peut pas envoyer ses données vers des serveurs externes – finance, santé, secteur public –, vous pouvez télécharger le modèle voulu et le déployer au sein du réseau de l’entreprise. Les données ne quittent jamais votre périmètre. Impossible avec ChatGPT ou Claude.
Qwen3-4B tient sur un portable ordinaire (à partir de 4 Go de mémoire) et offre une qualité comparable à celle de modèles qui exigeaient naguère une baie de serveurs complète.
Un guide pratique pour choisir le matériel, installer Ollama et comparer les modèles locaux aux modèles cloud : notre guide des LLM locaux pour les managers.
Qwen3.8-27B – un modèle qui tient sur une seule carte graphique
Sortie les 13 et 14 août 2026 – et pour une entreprise, l’événement compte davantage que l’arrivée du modèle phare.
Un modèle dense de 27–28 milliards de paramètres avec encodeur visuel : il comprend nativement images et vidéo et renvoie du texte. Contexte de 262 K. Licence Apache 2.0 – sans réserve liée au chiffre d’affaires ni validation juridique au cas par cas. En quantification Q4_K_M, il pèse environ 17 Go : une seule carte graphique grand public de type RTX 4090, ou un portable doté de 16 Go de mémoire via Ollama ou llama.cpp.
Il ne figure pas encore dans notre benchmark, mais il n’y a guère d’équivalent à comparer : Apache 2.0, vision intégrée et une seule carte graphique – aucun modèle du marché ne réunissait ces trois atouts avant août.
Pour une entreprise qui n’a pas le droit d’envoyer ses données dans le cloud, c’est la première option « tout en interne » qui n’a pas l’air d’un compromis. Qwen3-4B sur un portable était une démonstration de faisabilité. Un 27B avec vision et 262 K de contexte est un véritable outil de travail pour les scans de contrats, les photos de tableaux blancs, les procédures internes et les échanges qu’on ne peut pas confier à un service externe.
À vérifier avant de le déployer :
- La vitesse sur votre matériel. 17 Go, c’est la taille des poids ; cela ne dit rien d’un temps de réponse acceptable. Sur une machine à 16 Go de mémoire, une partie du modèle passera sur le processeur, et la génération ralentira.
- La qualité en français. Il n’existe pas encore de mesures indépendantes : testez-le sur vos propres documents, l’impression laissée par une démo ne prouve rien.
- La maintenance. Un déploiement local, c’est un serveur, des mises à jour de poids, de la supervision et une personne responsable de l’ensemble. Une partie des économies d’API partira dans son salaire.
Qwen face à la concurrence
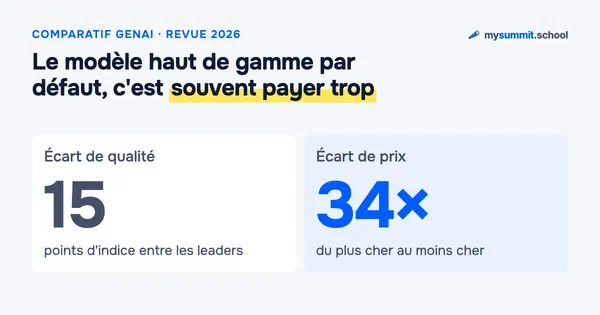
Les plateformes indépendantes dressent un tableau plus modeste que les annonces. Dans l’indice Artificial Analysis de septembre 2026, l’écart entre la première place (Claude Fable 5.1, 57 points) et la dixième (DeepSeek V4 Pro 0813, 42) est de 15 points, tandis que l’écart de prix atteint un facteur 34 : 6,12 $ contre 0,18 $ pour GLM-5.3-Flash. Les 47 points de Qwen3.8-Max, il les partage avec Gemini 3.8 Flash.
Une réserve de méthode. Artificial Analysis publie son indice par versions et recalcule l’échelle d’une version à l’autre : le chiffre cité à la sortie d’un modèle et celui du tableau en ligne ne sont pas sur la même échelle. On ne peut comparer qu’au sein d’un même instantané.
Sur LMArena, les positions un à neuf se chevauchent dans leurs intervalles de confiance sur les deux classements, texte et vision. Formellement, c’est une égalité. Désigner le meilleur modèle à partir d’un tel tableau, c’est le lire trop à la lettre – nous l’expliquons dans un article dédié.
| Critère | Qwen | ChatGPT / Claude | DeepSeek |
|---|---|---|---|
| Qualité du modèle phare | Au plus haut (47 points Artificial Analysis, 1er de Code Arena WebDev) | Au plus haut | Moyenne, pour un prix minimal |
| Accès web gratuit | Oui, chat.qwen.ai sans limite | Limité | Limité |
| Déploiement sur votre propre serveur | Oui – Qwen3.8-27B, Flash-Next, Qwen 4 Coder, séries 3.6 et 3.5 ; la série 3.7 est fermée | Non | En partie |
| Coût de l’API | Le plus bas de sa catégorie : Qwen3.8-Max – 2,00 $/6,00 $, Flash-Next – 0,16 $/0,47 $ | Élevé : GPT-6 Astra – 10 $/50 $ | Bas |
| Images et vidéo | Oui (3.8-Max, 3.8-27B, 3.7 Plus, 3.5-Omni) | Oui | Limité : vision seulement en préversion, sur l’offre bon marché |
Pour la plupart des tâches métier – rédaction, analyse de données, synthèses de documents –, Qwen 3.7 Plus donne des résultats comparables à Claude Sonnet 5, pour un prix nettement inférieur.
Résultats dans notre benchmark (mise à jour de septembre 2026)
Qwen est l’écosystème le plus largement représenté dans notre benchmark : cinq modèles. Les résultats portent sur 80 scénarios de tâches managériales réelles (analyse, planification, communication, gestion d’équipe). La gamme 3.8 n’en fait pas partie : nous n’avons pas encore testé Qwen3.8-Max, 27B ni Flash-Next, et tout ce qui en est dit plus haut s’appuie sur les données de l’éditeur et des plateformes indépendantes.
Les trois modèles phares – Qwen 3.6 Plus, Qwen 3.7 Max et Qwen 3.7 Plus – sont présentés plus haut avec les données récentes du benchmark (rang, score, coût par tâche et date du test dans les fiches sous leurs titres). Restent deux modèles de milieu de gamme :
Qwen 3.6 FlashComprend les tâches simples
score 5,6/10 rang 55 sur 74 $0,008 par tâche sans VPN
Testé dans le benchmark mysummit.school : mai 2026À propos du modèle →Comparer →
Qwen 3.6 27BComprend les tâches simples
score 5,8/10 rang 51 sur 74 $0,017 par tâche sans VPN
Testé dans le benchmark mysummit.school : mai 2026À propos du modèle →Comparer →
Qwen 3.6 Flash devance Gemini 3.5 Flash pour un prix bien moindre ; Qwen 3.6 27B est particulièrement fort en planification. En rapport qualité-prix, Qwen 3.6 Plus est plus convaincant que Claude Sonnet 5 et que GPT-5.4 Mini, tout en coûtant moins cher.
Le grand paradoxe de la gamme : Qwen 3.7 Max coûte plus cher que Qwen 3.6 Plus, mais se classe plus bas au général. Il gagne précisément dans les catégories « planification » et « gestion d’équipe » : si ces tâches sont centrales pour vous, Max se justifie.
- Information search6,0
- Data analysis6,0
- Decisions under uncertainty6,7
- Feedback analysis6,7
- Corporate requirements and risks6,1
- Automation5,6
- People management6,7
- Russia and Kazakhstan specifics4,7
Le profil de Qwen 3.6 Plus sur huit catégories rend l’écart évident : solide sur le texte et l’analyse, en difficulté dès qu’il faut un contexte local.
Toute la gamme Qwen partage les mêmes faiblesses :
- Le droit du travail local – sur les scénarios de notre benchmark, construits autour du droit du travail russe, il invente des articles et des sanctions inexistants. Ne tranchez pas une question juridique critique sans vérification.
- Les calculs financiers – des erreurs d’arithmétique systématiques.
- La connaissance régionale – la catégorie la plus faible de tous les modèles Qwen.
Voici la stratégie d’usage pour l’instant. Qwen 3.6 Plus est le modèle de travail principal. Qwen 3.7 Plus sert aux opérations routinières en volume, quand le budget est serré. Max se justifie là où comptent la planification et la gestion d’équipe : d’après nos mesures, il y est plus fort. Dès que la gamme 3.8 entrera dans le benchmark, il faudra refaire ce calcul.
Résultats interactifs complets ->
Essayez vous-même : planification et droit du travail
Vous
Tu es DRH d'une entreprise du numérique à Lyon. Élabore le plan d'intégration d'un nouveau chef de service pour ses 90 premiers jours.

## Contexte
- Entreprise : 85 personnes, développement produit
- Le nouveau responsable arrive de chez un concurrent et a amené 2 collaborateurs avec lui
- L'équipe compte 12 personnes, dont 3 mécontentes de voir arriver quelqu'un de l'extérieur
- Organisation : hybride (3 jours au bureau, 2 en télétravail)

## Tâche
1. Tiens compte du Code du travail : période d'essai d'un cadre, formalités d'embauche, formations obligatoires à la sécurité
2. Plan d'intégration dans l'équipe – comment gérer les « résistances »
3. KPI à 30/60/90 jours avec des indicateurs concrets
4. Budget d'intégration : 2 500 € – comment le dépenser
5. Risques : ce qui peut mal tourner et comment le repérer

Format : plan structuré avec responsables et échéances.
Qwen produit généralement une excellente structure de plan (la planification est sa catégorie la plus forte), mais dès qu’il cite le Code du travail, il invente souvent des articles et des sanctions qui n’existent pas (la connaissance régionale est sa catégorie la plus faible). DeepSeek a le même problème avec le droit local, et Kimi K2.6, meilleur planificateur des trois, connaît lui aussi mal les réglementations locales.
Usages concrets pour un manager
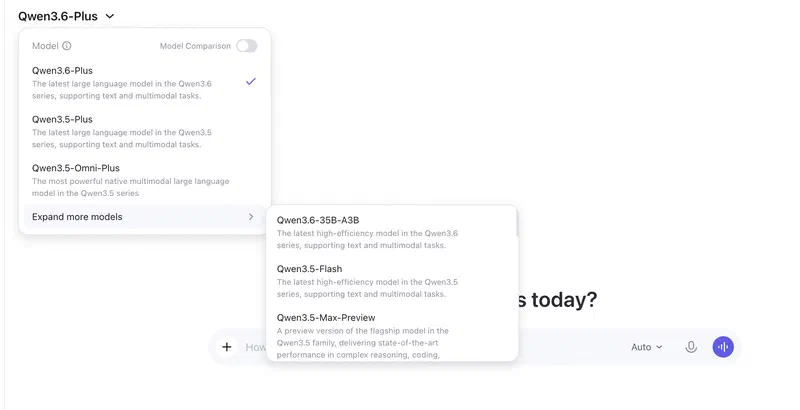
La plupart des managers qui essaient Qwen commencent par Qwen Chat, une interface web gratuite qui donne accès aux modèles actuels. Recherche web, génération d’images et analyse de documents y sont disponibles sans abonnement. Un bon point d’entrée pour évaluer l’outil avant d’en parler à la DSI.
Qwen gère avec aisance les documents difficiles : scans de contrats, notes manuscrites et photos de tableaux blancs ressortent en texte propre et structuré.
Autre cas d’usage : le déploiement en entreprise sans cloud. Pour les sociétés qui n’ont pas le droit de faire sortir leurs données de leur périmètre, Qwen offre ce que ChatGPT et Claude ne proposent pas : on peut télécharger les modèles et les faire tourner sur ses propres serveurs. Depuis août 2026, ce scénario n’impose plus de compromis sur la qualité – Qwen3.8-27B, avec la vision et sous Apache 2.0, le couvre sur une seule carte graphique. C’est la même logique que suivent les États qui construisent des IA souveraines : le contrôle des données passe avant le confort du cloud.
Enfin, Qwen3.5-Omni et Qwen3-TTS permettent de bâtir un assistant vocal de bout en bout – reconnaissance vocale, traitement de la demande, synthèse vocale – dans un même écosystème, sans assembler plusieurs services distincts.
Le revirement : le modèle phare redevient ouvert
Au premier semestre 2026, la proposition de valeur de Qwen a changé. Alibaba a basculé ses modèles phares – Qwen3.7-Max et Qwen3.7-Plus – en format fermé (API uniquement, sans poids ouverts). Cela plaçait Alibaba en concurrence directe avec OpenAI et Anthropic sur les contrats d’API d’entreprise, et ressemblait à un renoncement à ce qui avait fait la croissance de l’écosystème.
Même alors, ce n’était pas un abandon total de l’open source : Qwen3.6-35B-A3B et Qwen 4 Coder sont sortis sous Apache 2.0. Mais les modèles les plus capables étaient fermés, et l’entreprise ne s’engageait sur aucun calendrier d’ouverture de la série 3.7.
En août, la direction a changé. Qwen3.8-Max est le premier modèle phare de classe Max dont Alibaba a promis de publier les poids. Le même mois sont sortis Qwen3.8-27B sous Apache 2.0 et Qwen3.8-Flash-Next, avec des poids sur Hugging Face et ModelScope. La série 3.7, elle, est restée fermée.
Le virage du printemps s’est accompagné de départs clés. En mars 2026, le responsable technique du projet, Lin Junyang, est parti en écrivant sur les réseaux sociaux : « me stepping down. bye my beloved qwen ». Le même jour, Yu Bowen, qui dirigeait le post-entraînement, a démissionné. Hui Binyuan, chercheur principal sur le code, était parti plus tôt. Un collègue de l’équipe a commenté : « Je sais que partir n’était pas ton choix. » L’action Alibaba a perdu 5,3 % ce jour-là.
Pour un manager qui choisit Qwen, le tableau se présente désormais ainsi :
- Les modèles ouverts ont atteint le haut de gamme. 27B et Flash-Next se téléchargent déjà, Max est promis. Si le contrôle des données est critique, il n’y a plus rien à attendre.
- Il faut lire les conditions d’ouverture. Apache 2.0 pour 27B, licence maison pour Flash-Next, seuil de chiffre d’affaires pour Max.
- L’instabilité des équipes n’a pas disparu. Le rythme des sorties n’a pas faibli cet été, mais une seule saison ne suffit pas à dégager une tendance.
Limites et risques
- Licence du modèle phare : l’ouverture de Qwen3.8-Max est promise, mais avec une licence maison et un seuil de chiffre d’affaires. Ne planifiez un déploiement commercial sur vos serveurs qu’après avoir lu le texte.
- Taille du modèle phare : environ 2,5 To de poids en FP8, niveau data center ; en pratique, Qwen3.8-Max reste un modèle cloud, que les poids soient publiés ou non.
- Vitesse : 40 tokens par seconde en sortie selon Artificial Analysis – le plus mauvais résultat du top 10. Cela se ressent en usage interactif comme dans les boucles agentiques à centaines d’appels.
- Départs clés : le départ du responsable technique du projet et de celui du post-entraînement en mars 2026 est un signal sérieux. Alibaba a réorganisé l’équipe en créant une cellule transverse dédiée aux modèles de fondation, mais les conséquences à long terme restent floues.
- Censure et filtres : comme d’autres modèles chinois, Qwen comporte des restrictions intégrées sur certains sujets politiques et historiques. Pour les tâches métier, c’est rarement un problème.
- Risques géopolitiques : le modèle appartient à Alibaba (Chine). Pour certaines organisations, cela peut exclure l’usage de l’API cloud. La parade : le déploiement local des versions ouvertes.
- Qualité en français : malgré plus de 200 langues annoncées, les réponses en français peuvent être en retrait par rapport à l’anglais. Testez sur vos propres tâches.
- Intégrations : les connecteurs prêts à l’emploi vers les services occidentaux – Slack, Notion, Google Workspace – sont bien moins nombreux que pour ChatGPT ou Claude. Qwen est mieux intégré aux outils d’entreprise chinois.
Tarifs et disponibilité
| Option | Coût | Pour qui |
|---|---|---|
| chat.qwen.ai | Gratuit | Essayer Qwen sans compte API |
| Qwen3.8-27B (téléchargement) | Gratuit, Apache 2.0 | Vision, contexte de 262 K, ~17 Go en Q4_K_M – une carte graphique |
| Qwen3.8-Flash-Next (API / poids) | 0,16 $ / 0,47 $ par million en entrée/sortie | Flux agentiques en volume, jusqu’à 1 million de contexte via YaRN |
| Qwen3.8-Max (API) | 2,00 $ / 6,00 $ par million, cache 0,25 $ | Modèle phare : texte, images et vidéo, contexte de 1 million |
| Qwen 4 Coder 32B-A3B (téléchargement) | Gratuit (Apache 2.0) | Code sur un portable, 82 % SWE-Verified |
| Qwen3-0.6B / 4B (téléchargement) | Gratuit | Exécution sur un portable, contrôle total des données |
| Qwen3-235B (téléchargement) | Gratuit | Modèle phare en local, grappe de serveurs nécessaire |
| Qwen3.7-Plus (API, disponibilité générale) | 0,40 $ / 1,60 $ par million en entrée/sortie | Agent multimodal, GUI grounding, contexte de 1 million |
| Qwen3.7-Max (API) | 2,50 $ / 7,50 $ par million en entrée/sortie | Modèle phare texte, scénarios agentiques, contexte de 1 million |
| Qwen3.5-397B-A17B (API) | 0,39 $ / 2,34 $ par million en entrée/sortie | Modèle phare sous licence ouverte |
Pour comparer : analyser un rapport de 100 pages coûte environ 0,35 $ avec GPT-4o, environ 0,55 $ avec Claude Sonnet. Dans le haut de gamme, l’écart se creuse : 10 $/50 $ par million de tokens pour GPT-6 Astra contre 2 $/6 $ pour Qwen3.8-Max.
Qwen offre toujours trois portes d’entrée : le chat gratuit, une API cloud bon marché et le déploiement local. Cet été, c’est la troisième qui a changé : un 27B avec vision et un Max promis en accès ouvert placent désormais le local au plus haut niveau.
Faut-il l’essayer ?
Il y a six mois, l’argument en faveur de Qwen était simple : « tout ce que fait ChatGPT, mais gratuit et ouvert ». Au printemps, il vacillait. En septembre, il est revenu – avec une gamme plus solide.
L’ouvert couvre désormais toute la gamme des besoins. Qwen3.8-27B, sous Apache 2.0, avec la vision et 17 Go de poids, tourne sur une seule carte graphique. Flash-Next, à 0,16 $/0,47 $, encaisse des flux agentiques avec jusqu’à 1 million de tokens de contexte, et Qwen 4 Coder comme la famille Qwen 3.5 restent d’actualité. Pour les entreprises qui ont besoin de garder la main sur leurs données en local, les alternatives restent rares, et celle-ci est la plus solide du moment.
Sur la plupart des tâches, tous les meilleurs modèles donnent aujourd’hui des résultats comparables, et la différence ne saute pas aux yeux au quotidien. Qwen 3.7 Plus couvre l’analyse multimodale, les scénarios agentiques et le travail à l’écran – le même terrain que Claude Sonnet 5, pour plusieurs fois moins cher. Sur des tâches en volume, l’économie est réelle.
Le départ de développeurs clés et la réorganisation de l’équipe sont un risque à surveiller. Le rythme des sorties n’a pas ralenti jusqu’ici, mais ce n’est pas une garantie. Si vous bâtissez des processus critiques sur Qwen, prévoyez une solution de repli – DeepSeek ou des modèles cloud adossés à une structure d’entreprise plus stable.
Cet automne, une chose mérite d’être suivie de près : le texte de la licence de Qwen3.8-Max. La promesse d’ouvrir le modèle phare a été faite ; les conditions auxquelles on pourra l’utiliser, personne ne les a encore vues.
Autres parties de cette série
 Partie 1
ChatGPT en 2026 : ce qui a changé et par où commencer quand on est manager
 Partie 2
Claude d'Anthropic en 2026 : Opus 5, Fable 5.1, Mythos 5.1, Cowork et Chrome – le guide du manager
 Partie 3
Perplexity AI en 2026 : le moteur de recherche intelligent passé au crible pour les managers
 Partie 4
Google Gemini en 2026 : modèles, NotebookLM et intégration Workspace
 Partie 5
Grok de SpaceXAI en 2026 : l'IA d'Elon Musk passée au crible
 Partie 6
YandexGPT en 2026 : revue de l'IA russe de Yandex pour les entreprises
 Partie 7
DeepSeek en 2026 : V4-Pro et V4-Flash après la hausse des prix
 Partie 8
GigaChat en 2026 : revue honnête – vaut-il le coup pour le travail ?
 Partie 10
Comment évaluer la qualité des LLM en 2026 : guide des benchmarks pour managers
 Partie 11
L'IA pour créer du contenu multimédia en 2026 : images, vidéo, musique et présentations
 Partie 12
Comparatif des outils GenAI 2026 : quelle IA choisir quand on est manager ?
 Partie 13
Chat Z.AI (GLM-5) en 2026 : le modèle chinois qui se fait passer pour Claude
 Partie 14
Kimi de Moonshot en 2026 : K3, K2.6, K2.7-Code et agents pour le manager
 Partie 15
GigaChat au travail : tirer le meilleur de l'IA souveraine russe
 Partie 16
Quand les benchmarks IA perdent leur sens : comment choisir un modèle
 Partie 17
Meta Muse Spark : le premier modèle fermé de Meta depuis 2023
 Partie 18
Les modèles Microsoft MAI en 2026 : ce qui est vraiment accessible, et à quel prix
 Partie 19
Agents de code en 2026 : deux formats, le terminal et le bureau
Sources
- Qwen3.8-Max 0902 sur OpenRouter – fiche du modèle : modalités, contexte, tarifs
- Alibaba releases Qwen3.8-Flash-Next – architecture et tarifs de Flash-Next
- Qwen3.8-Max : l’analyse de DataCamp – benchmarks et conditions de licence
- Alibaba releases Qwen3.8-Max – caractéristiques et calendrier de sortie
- Qwen 3.5 : le guide complet – configuration matérielle requise pour la famille ouverte
- Artificial Analysis – classement des modèles – indice d’intelligence, prix mixte, vitesse de sortie
- LMArena (Arena.ai) – classement par préférences – classements texte et vision, septembre 2026
- Qwen Chat – interface web gratuite – le chat officiel d’Alibaba, sans inscription
- Site officiel de Qwen – documentation et description de tous les modèles
- Les modèles Qwen sur Hugging Face – 433 modèles ouverts à télécharger, plus de 300 millions de téléchargements
- Qwen sur GitHub – code source et documentation, plus de 40 dépôts
- API via Alibaba Cloud Model Studio – accès cloud à Qwen-Plus et Qwen-Max

18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.