Comparatif des outils GenAI 2026 : quelle IA choisir quand on est manager ?
Modèles d’IA dans cet article
En septembre 2026, le marché de l’IA générative compte des dizaines d’outils. Chaque éditeur se dit leader, et les supports marketing rivalisent de décibels. Comment un manager choisit-il l’outil qui fait vraiment le travail ?
Cet article rassemble l’essentiel sur les principaux outils GenAI que nous avons analysés en détail dans notre série de revues : tableaux de synthèse, recommandations par cas d’usage et conseils pratiques pour trancher.
Entre la version de juillet et celle de septembre de cette page, presque tous les modèles phares des tableaux ont changé. OpenAI, Anthropic, Google, xAI, Alibaba et Z.ai ont sorti de nouveaux modèles haut de gamme en six semaines. Voici ce qui change réellement la décision d’un manager, et ce qui restera dans les communiqués de presse.
La gamme au 6 septembre 2026
| Éditeur | Modèle phare actuel | Date de sortie | Ce que listait la version de juillet de cet article |
|---|---|---|---|
| OpenAI | GPT-6 Astra | 3 septembre | GPT-5.6 Sol |
| Anthropic | Claude Fable 5.1 ; modèle de travail – Opus 5 | 1er septembre et 24 juillet | Opus 4.6 / 4.8 |
| Gemini 3.8 Flash ; pas de modèle haut de gamme | 2 septembre | Gemini 3.1 Pro | |
| xAI | Grok 4.6 | 12 août | Grok 4.5 |
| Alibaba | Qwen3.8-Max | 3 août | Qwen 3.6 Plus / 3.7 Max |
| Z.ai | GLM-5.3 et GLM-5.3-Flash | 14 et 26 août | GLM-5.1 / 5.2 |
| DeepSeek | V4-Pro, désormais en GA | 13 août | V4-Pro / V4-Flash |
| Moonshot | Kimi K3 | 16 juillet | inchangé |
| Sber | GigaChat 3.5 Ultra, désormais sous MIT | juillet | inchangé |
| Yandex | Alice AI, YandexGPT 5.1 Pro | 28 juillet | inchangé |
Aucun modèle sorti après le 16 juillet ne figure encore dans notre benchmark. Tout ce qui est dit plus bas sur GPT-6 Astra, Claude Fable 5.1 et Opus 5, Gemini 3.8 Flash, Grok 4.6, Qwen3.8 et GLM-5.3 repose sur les données des éditeurs et sur deux plateformes indépendantes, Artificial Analysis et LMArena. Les résultats de notre propre benchmark décrivent la gamme de juillet, et nous le signalons systématiquement.
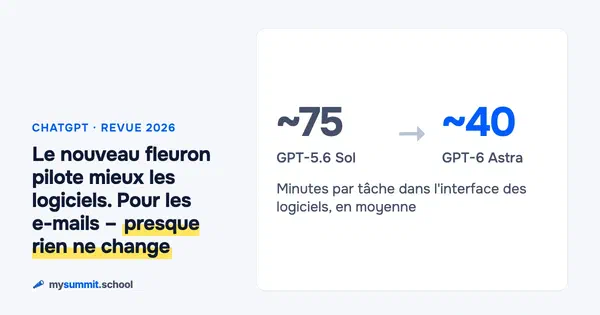
Nous avons retiré la note historique sur GPT-5.4 de la version de mars : en six mois, il a été remplacé par GPT-5.6 Sol, puis par Astra. De cette sortie, il reste une conséquence : le pilotage de l’ordinateur n’a plus rien de rare. Astra pousse justement cet axe : sur OSWorld V2-Offline, le modèle atteint selon OpenAI 72,6 % contre 65,7 % pour GPT-5.6 Sol, et met environ 40 minutes par tâche au lieu de 75. En code, le gain est plus modeste : 74,1 % sur DeepSWE v1.1 contre 72,7 %.
Résultats du benchmark mysummit.school (juillet 2026)
Depuis la première publication, nous, la plateforme de formation mysummit.school, avons mené un benchmark indépendant sur 47 modèles. Les modèles ont traité de vraies tâches de management, et deux modèles juges ont noté les réponses : Claude Opus 4.6 et Gemini 3.1 Pro. La méthode et l’échelle sont décrites sur la page du benchmark.
La frontière est simple : ces résultats sont les nôtres et portent sur les modèles que nous avons testés. Tout ce que les éditeurs ont sorti après le 16 juillet en est absent et n’apparaîtra qu’après la prochaine série de tests.
Les principaux enseignements :
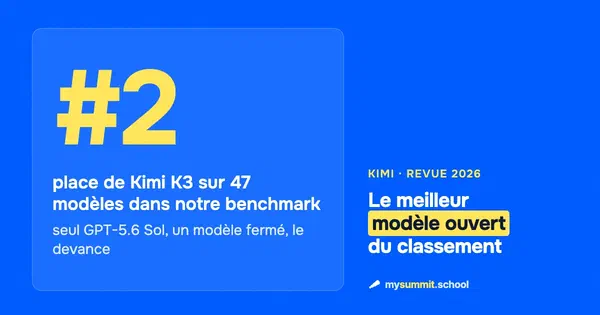
- En tête, GPT-5.6 Sol d’OpenAI et Kimi K3 de Moonshot : première et deuxième places de la série de juillet. Kimi K3 est le modèle non américain le plus performant du classement.
- Les modèles chinois entrent dans le top 10. Outre Kimi K3, on y trouve MiniMax M3 et MiMo v2.5 Pro de Xiaomi. Tous trois coûtent 5 à 10 fois moins cher que leurs équivalents occidentaux.
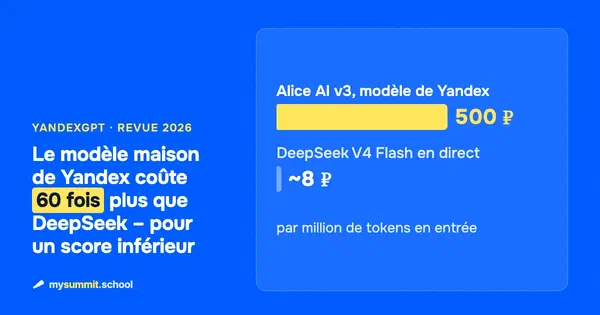
- DeepSeek V4 Flash sur Yandex Cloud, la version hébergée par le cloud russe, coûte 28 à 33 fois plus cher que l’original, pour une qualité légèrement inférieure.
- Le dernier modèle de Sber, GigaChat 3.5 Ultra, a nettement progressé par rapport à GigaChat 2 Max, mais son prix rejoint désormais celui de GPT-4 et il reste loin des leaders.
- Grok 4.5 ferme le top 10 et reste l’un des meilleurs en management d’équipe.
- Qwen place cinq modèles dans le top 30. Qwen 3.6 Plus offre le meilleur rapport qualité-prix.
Les résultats détaillés par outil figurent dans les articles mis à jour de la série, listés plus bas.
Ce qui a changé sur le fond
Sept tendances traversent tous les éditeurs. Mieux vaut les avoir en tête avant d’ouvrir le moindre tableau.
Le modèle bon marché est désormais souvent le meilleur
Gemini 3.8 Flash coûte 0,75 $ par million de tokens en entrée et 3,75 $ par million en sortie : c’est le tarif de lancement de Google. Sur l’indice d’Artificial Analysis, il obtient 47 points, autant que Qwen3.8-Max à 2 $/6 $, et cinq de plus que DeepSeek V4-Pro. Dans le classement texte de LMArena, il est huitième.
Deux réserves changent le calcul. Le tarif de lancement court jusqu’au 31 décembre 2026, et Google n’a pas publié le tarif normal. Et Google prévient elle-même que le coût réel d’une requête dépasse d’environ 40 % le prix affiché, car le modèle génère plus de tokens en sortie et enchaîne davantage d’étapes agentiques.
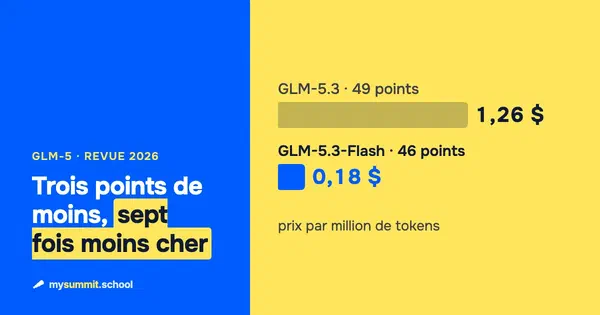
GLM-5.3-Flash coûte 0,15 $/0,50 $ contre 1,40 $/4,40 $ pour le GLM-5.3 complet. Sur l’indice d’Artificial Analysis, il ne lui rend que trois points, 46 contre 49, pour un prix mixte sept fois inférieur. Z.ai publie aussi ses propres comparaisons avec la génération précédente : sur DeepSWE v1.1, Flash obtient 63,4 contre 46,2, sur AutomationBench 48,8 contre 26,2. Trois points d’indice contre une économie d’un facteur sept : c’est un arbitrage à calculer tâche par tâche, pas à accepter sur parole.
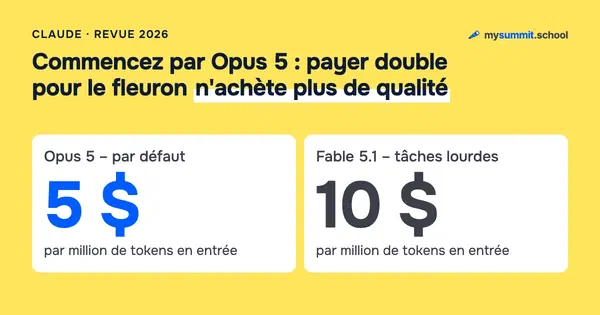
Anthropic a bâti sa gamme sur le même principe. Opus 5, à 5 $/25 $, reste selon Anthropic à 0,5 % du pic de Fable 5 sur CursorBench 3.2, pour un coût par tâche divisé par deux. Fable 5.1, à 10 $/50 $, sert d’escalade pour les problèmes vraiment difficiles, pas de mode de travail par défaut.
En septembre 2026, acheter par défaut le modèle haut de gamme est plus souvent une erreur qu’un bon choix.
Les seuils de prix recalculent toute la requête
GPT-6 Astra, selon la grille d’OpenAI : 10 $ en entrée et 50 $ en sortie par million de tokens, tant que l’entrée ne dépasse pas 272 000 tokens. Au-delà, le tarif d’entrée double à 20 $, celui de sortie passe à 75 $, et c’est toute la requête qui est refacturée, pas seulement les tokens au-dessus du seuil. Un seul long document dans le contexte change le prix de l’appel entier.
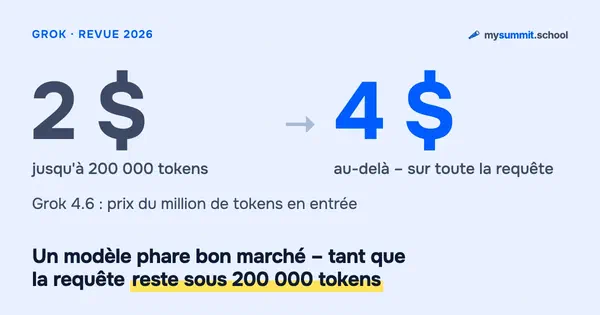
Grok 4.6 fonctionne de la même façon, avec un seuil plus bas, à 200 000 : 2 $/6 $ deviennent 4 $/12 $.
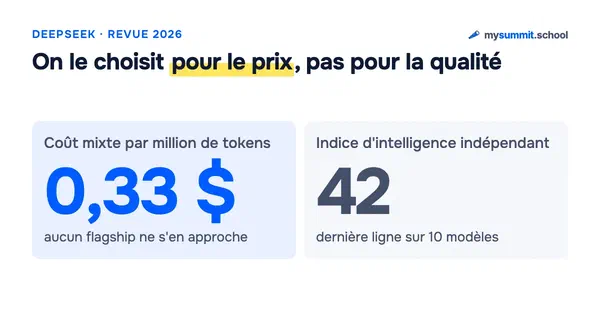
Depuis le 16 août, DeepSeek V4-Pro facture selon des plages de pointe et creuses ; les heures de pointe sont 01:00–04:00 et 06:00–10:00 UTC, et les heures creuses coûtent deux fois moins. Dans le même temps, les tarifs de cache ont augmenté de plus d’un ordre de grandeur par rapport aux prix initiaux de la preview : jusqu’à 1 100 %, d’après le changelog officiel de DeepSeek. Le moins cher de tous, oui. Agressivement bon marché, plus vraiment.
Aucun de ces mécanismes n’apparaît sur la page des tarifs tel que le service financier le découvrira en fin de mois.
La vitesse, la variable que personne ne compare
Artificial Analysis mesure la vitesse de génération en tokens par seconde. Gemini 3.8 Flash en produit 334. Les neuf autres modèles du top 10 vont de 40 à 87 ; les plus lents sont Qwen3.8-Max et Kimi K3, à 40 et 42.
La latence ne figure jamais sur les slides, mais tous ceux qui attendent une réponse plus de deux secondes la ressentent. Dès que le modèle tourne dans l’interface de l’utilisateur – support, analyse de document, brouillon d’e-mail –, un écart de vitesse d’un facteur quatre compte davantage que trois points d’indice.
« Poids ouverts » recouvre désormais quatre réalités différentes
| Ce qui est écrit | Ce que cela permet | Exemples dans la gamme de septembre |
|---|---|---|
| MIT | Disposer des poids sans aucune condition | GLM-5.3-Flash, GigaChat 3.5 Ultra, DeepSeek V4-Pro |
| Apache 2.0 | La même chose, avec une clause explicite sur les brevets | Qwen3.8-27B, toute la famille Qwen 3.5 |
| Licence maison avec seuil de chiffre d’affaires | Libre sous le seuil, contrat avec l’éditeur au-dessus | Qwen3.8-Max (seuil de 50 millions de dollars de revenus issus de services d’IA), Kimi K3 (20 millions) |
| Poids fermés | API ou abonnement uniquement | OpenAI, Anthropic, Google, xAI, Yandex, Meta |
Cette colonne est plus utile que n’importe quelle colonne de benchmark. Le score d’un modèle sera recalculé dans six semaines ; le texte d’une licence, les éditeurs le modifient plus rarement et préviennent à l’avance.
Un mot à part sur Qwen3.8-Max : Alibaba a promis pour la première fois d’ouvrir un modèle Max, mais la licence est, d’après les informations disponibles, une licence maison, qui fait d’un chiffre d’affaires supérieur à 50 millions de dollars une condition de négociation. Vérifiez-la avant d’inscrire l’auto-hébergement dans votre plan.
Héberger soi-même n’est plus un compromis
Qwen3.8-27B est un modèle dense de 27 à 28 milliards de paramètres avec un encodeur visuel, un contexte de 262 000 tokens et une licence Apache 2.0. Quantifié en Q4_K_M, il pèse environ 17 Go : il tient sur une seule carte graphique grand public de type RTX 4090, ou sur un portable de 16 Go via Ollama et llama.cpp.
GLM-5.3-Flash, sous MIT, demande environ 306 Gio en FP8 et une architecture NVIDIA Hopper ou plus récente. On parle déjà d’une entreprise de taille moyenne à grande, mais la licence n’impose strictement aucune condition.
GigaChat 3.5 Ultra est un MoE de 432 milliards de paramètres, lui aussi sous MIT. Qwen3.8-Max pèse environ 2,5 To en FP8 et reste une solution de data center.
Pour une entreprise soumise à des exigences de localisation des données, c’est un éventail d’options réellement nouveau : en juillet encore, « garder en interne » voulait dire choisir un modèle nettement plus faible que ceux du cloud.
La vision est arrivée de façon inégale
D’après sa fiche OpenRouter, Qwen3.8-Max accepte texte, image et vidéo. Le classement vision de LMArena place qwen3.8-max troisième avec 1300±8 : une confirmation indépendante que la multimodalité est bien réelle, à rebours d’une source secondaire qui présentait le niveau Max comme textuel.
GLM-5.3-Flash est le premier modèle nativement multimodal de la gamme GLM-5 : texte, image, vidéo, fichiers.
Son histoire est instructive. Le 29 juin, le fondateur de Zhipu, Jie Tang, a demandé à la communauté ce que devait contenir le prochain GLM. Dans plus de 1 400 réponses, la vision dominait : les développeurs voulaient analyser captures d’écran, PDF, maquettes et messages d’erreur sans modèle intermédiaire. GLM-5.3 est sorti le 14 août sans vision. La vision est arrivée douze jours plus tard, dans une autre gamme de produits.
DeepSeek a répondu le 21 août avec deepseek-v4-flash-vision-exp : images et captures, statiques ou en séquences d’images, mais pas de vraie vidéo ; il est facturé au tarif de V4-Flash et obtient 64,3 sur Chartography. Le suffixe -exp n’est pas décoratif : il est trop tôt pour bâtir de la production dessus.
Google a pris une autre voie. Depuis le 1er septembre, 3.7 Flash, 3.6 Flash et 3.5 Flash-Lite proposent une compréhension vidéo agentique : le modèle parcourt l’enregistrement et va chercher à la demande les transcriptions, images et pistes audio dont il a besoin, au lieu de tout avaler. Sur les longs enregistrements, cela représente jusqu’à 88 % de tokens en moins – une ligne budgétaire directe pour quiconque traite des enregistrements d’appels ou des vidéos de formation.
Pour planifier autour de ces annonces, une seule règle : ne vous appuyez que sur ce qui est déjà sorti.
Google n’a pas de modèle haut de gamme
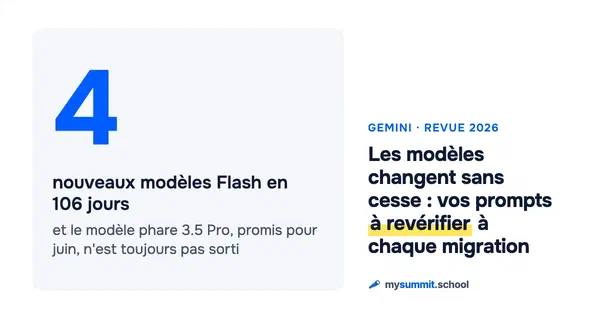
Quatre sorties Flash en 106 jours – 3.5 Flash-Lite, 3.6, 3.7 et 3.8 Flash –, de fin mai au 2 septembre. Sundar Pichai avait promis Gemini 3.5 Pro en juin ; le statut actuel est « bientôt disponible ». Selon le WSJ, les candidats internes au rang de modèle phare ne surpassaient pas suffisamment Flash pour justifier une sortie.
Pour les achats, cela signifie une seule chose : si vous avez besoin d’un modèle de tout premier niveau, Google n’a rien à vous vendre en ce moment.
Il y a aussi un volet opérationnel. Le 21 juillet, Google a déclaré obsolètes temperature, top_p et top_k, changeant les réglages en plein flux de sorties. Les prompts ajustés pour 3.6 Flash ne sont pas garantis sur 3.8 Flash, et quatre changements de modèle en 106 jours représentent un poste de dépense à part entière en tests de non-régression.
Les plateformes indépendantes
Deux plateformes testent tous les modèles dans les mêmes conditions. Quand un article compare des modèles, c’est sur elles qu’il faut s’appuyer, pas sur les chiffres des annonces.
Artificial Analysis, données au 6 septembre 2026
| Modèle | Éditeur | Indice d’intelligence | Prix mixte, $/1M | Sortie, tok/s |
|---|---|---|---|---|
| Claude Fable 5.1 (max, w/ fallback) | Anthropic | 57 | 6,12 $ | 70 |
| GPT-6 Astra (max) | OpenAI | 55 | 2,57 $ | 71 |
| Claude Opus 5 (max) | Anthropic | 54 | 4,21 $ | 58 |
| Muse Spark 1.3 (max) | Meta | 53 | 0,96 $ | 190 |
| GPT-5.6 Sol (max) | OpenAI | 51 | 1,25 $ | 85 |
| Grok 4.6 (high) | xAI | 51 | 1,25 $ | 63 |
| Kimi K3 (max) | Moonshot | 50 | 1,58 $ | 42 |
| GLM-5.3 (max) | Z.ai | 49 | 1,26 $ | 87 |
| Gemini 3.8 Flash (high) | 47 | 0,74 $ | 334 | |
| Qwen3.8 Max | Alibaba | 47 | 1,19 $ | 40 |
| Qwen3.8-Flash-Next | Alibaba | 46 | – | – |
| GLM-5.3-Flash | Z.ai | 46 | 0,18 $ | 48 |
| DeepSeek V4 Pro 0813 (max) | DeepSeek | 42 | 0,33 $ | 71 |
Une réserve sans laquelle mieux vaut ne pas utiliser ce tableau : Artificial Analysis publie son indice par versions et le recalibre d’une version à l’autre. Le « 60 » de l’annonce de Z.ai et le « 49 » du classement en direct désignent le même modèle sur deux échelles différentes. On ne peut comparer qu’au sein d’un même instantané.
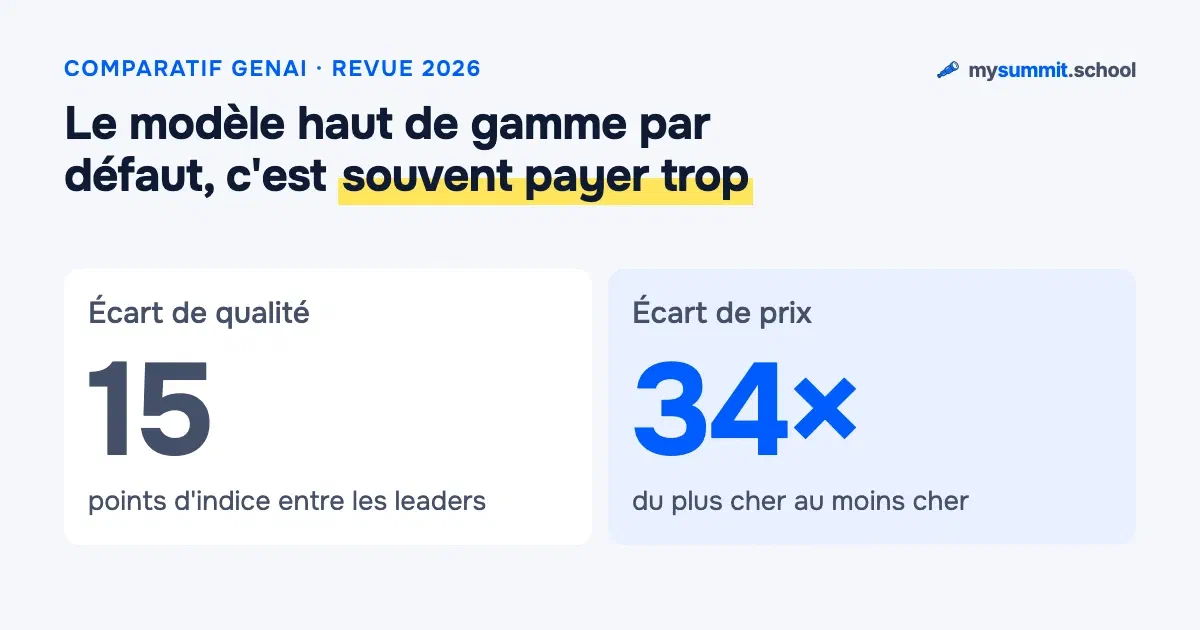
L’écart entre la première et la dernière place du tableau est de 15 points. L’écart de prix est d’un facteur 34 : 6,12 $ contre 0,18 $. La vraie décision se joue entre ces deux chiffres : combien valent quinze points d’indice face à un surcoût d’un facteur trente, sur vos tâches à vous.
LMArena, données au 6 septembre 2026
Texte, les dix premiers :
| # | Modèle | Score |
|---|---|---|
| 1 | claude-fable-5 (Anthropic) | 1507±5 |
| 2 | claude-opus-4-6-high | 1505±4 |
| 3 | claude-fable-5.1-max | 1504±11 |
| 4 | claude-opus-4-7-high | 1502±4 |
| 5 | muse-spark-1.2 xHigh (Meta) | 1499±10 |
| 6 | claude-opus-4-6 | 1498±3 |
| 7 | claude-opus-4-7 | 1494±4 |
| 8 | gemini-3.8-flash-high (Google) | 1494±9 |
| 9 | claude-opus-5-high | 1493±5 |
| 10 | muse-spark-1.1 (Meta) | 1492±5 |
Vision, les dix premiers :
| # | Modèle | Score |
|---|---|---|
| 1 | claude-fable-5 | 1313±8 |
| 2 | claude-opus-4-7-high | 1301±7 |
| 3 | qwen3.8-max (Alibaba) | 1300±8 |
| 4 | claude-opus-4-7 | 1299±7 |
| 5 | claude-opus-4-6-high | 1299±7 |
| 6 | muse-spark (Meta) | 1294±9 |
| 7 | claude-opus-4-6 | 1293±7 |
| 8 | muse-spark-1.2 xHigh (Meta) | 1292±15 |
| 9 | claude-opus-5-high | 1290±8 |
| 10 | gemini-3-pro (Google) | 1289±8 |
Les chiffres de ces deux tableaux proviennent de LMArena et n’ont aucun lien avec notre benchmark.
Les intervalles des positions un à neuf se chevauchent sur les deux classements. Statistiquement, c’est une égalité, et tout texte qui désigne le meilleur modèle sur la foi de LMArena fait dire au classement plus qu’il ne permet. Nous avons détaillé ce mécanisme dans « Les benchmarks d’IA perdent leur sens » ; sur le fonctionnement de la mesure elle-même, voir « Comment évaluer la qualité des LLM ».
Les deux classements divergent de façon révélatrice. Anthropic occupe six des dix premières places à la préférence humaine, tout en se situant au milieu du tableau d’Artificial Analysis. L’un vérifie les réponses selon une grille, l’autre demande aux gens quel texte ils trouvent le plus agréable à lire. Ce sont deux grandeurs différentes, et les confondre est une erreur courante au moment de choisir.
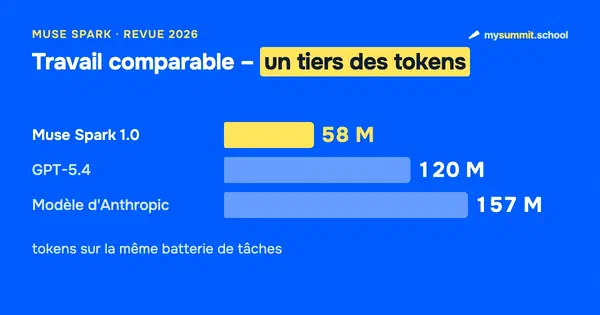
Meta, avec la famille muse-spark, se maintient dans le top 10 des deux classements, et Muse Spark 1.3 figure en quatrième ligne chez Artificial Analysis pour 0,96 $ et 190 tokens par seconde – deux fois plus rapide que tous ceux qui le précèdent. Nous analysons la gamme dans un volet dédié de la série.
Jusqu’ici, il était question de la manière de mesurer les modèles. Et la mesure n’a rien de simple : notre benchmark décrit la gamme de juillet, Artificial Analysis recalibre son échelle entre les versions, et sur LMArena les neuf premiers sont indiscernables. La tâche du manager, elle, ne change pas : il lui faut une réponse qu’il peut mettre dans un rapport ou remettre à un client. Le même modèle, avec deux formulations différentes, produit soit un brouillon à réécrire, soit un résultat qu’il n’est pas nécessaire de retoucher. La différence entre « ça marche » et « ça marche de façon fiable », c’est la compétence de formulation des tâches pour l’IA.
Tableau de synthèse : 13 outils comparés
La troisième colonne indique le modèle de notre série de tests de juillet, pas le modèle phare actuel : nous n’avons encore rien testé de ce qui est sorti après le 16 juillet. Rangs et scores figurent dans le tableau dynamique « Prix et résultat » plus bas, mis à jour à chaque vague du benchmark.
| Outil | Modèle phare au 6 septembre 2026 | Modèle dans notre benchmark | Contexte | Abonnement | Point fort |
|---|---|---|---|---|---|
| ChatGPT | GPT-6 Astra | GPT-5.6 Sol | 1M tokens pour Astra | 20–200 $/mois | Polyvalence, écosystème, pilotage de l’ordinateur |
| Claude | Fable 5.1 ; modèle de travail – Opus 5 | Opus 4.6 | 1M tokens | 20–200 $/mois | Qualité rédactionnelle, planification, navigateur et Cowork |
| Gemini | 3.8 Flash ; pas de modèle haut de gamme | 3.1 Pro | 2M tokens pour 3.1 Pro | 20–250 $/mois | Google Workspace, vitesse de génération |
| Perplexity | Multi-modèles | non testé | Variable | 20 $/mois | Recherche avec sources |
| Grok | 4.6 | 4.5 | 500 000 tokens | 8–35 $/mois | Management d’équipe, scripts de gestion des conflits |
| YandexGPT | Alice AI, YandexGPT 5.1 Pro | Alice AI v3 | 128 000 tokens | Via API | Langue russe, Yandex 360 |
| GigaChat | 3.5 Ultra | 3.5 Ultra | – | Via API | Données hébergées en Russie, poids ouverts sous MIT |
| DeepSeek | V4-Pro (GA) | V4-Pro | 1M tokens | Via API | Prix, plafond de sortie de près de 400 000 tokens |
| Qwen | Qwen3.8-Max | 3.6 Plus | 1M tokens pour Qwen3.8-Max | Via API | 5 modèles dans le top 30, poids ouverts |
| GLM-5 de Z.ai | GLM-5.3 et GLM-5.3-Flash | GLM-5.2 | 1M tokens | Via API | Poids MIT pour Flash, multimodalité |
| Kimi | K3 | K3 | 1M tokens | 19–199 $/mois | Le modèle non américain le plus performant de notre benchmark |
| MiMo (Xiaomi) | v2.5 Pro | v2.5 Pro | – | Via API | Top 10 pour une fraction des prix occidentaux |
| MiniMax | M3 | M3 | – | Via API | Top 10 à petit prix |
Meta et sa famille muse-spark ne figurent pas dans ce tableau, faute d’avoir été intégrés à notre benchmark. L’analyse se trouve dans la revue de la gamme Muse Spark ; les données des plateformes indépendantes sont plus haut.
Prix des sorties de septembre
Chiffres tirés des grilles tarifaires des éditeurs ; ces modèles ne figurent pas dans notre benchmark.
| Modèle | Entrée, $/1M | Sortie, $/1M | À savoir |
|---|---|---|---|
| GPT-6 Astra | 10 $ | 50 $ | Au-delà de 272 000 tokens en entrée : 20 $ et 75 $ sur toute la requête |
| Claude Fable 5.1 | 10 $ | 50 $ | Lecture du cache 0,25 $, 75 % moins cher que Fable 5 |
| Claude Opus 5 | 5 $ | 25 $ | Deux fois moins cher que Fable 5.1 |
| Grok 4.6 | 2 $ | 6 $ | Au-delà de 200 000 : 4 $ et 12 $ |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | Tarif de lancement jusqu’au 31 décembre 2026, tarif normal non annoncé |
| Qwen3.8-Max | 2 $ | 6 $ | Lecture du cache 0,25 $ |
| Qwen3.8-Flash-Next | 0,16 $ | 0,47 $ | Préversion de l’architecture Qwen4, contexte jusqu’à 1M via YaRN |
| GLM-5.3 | 1,40 $ | 4,40 $ | Prix inchangé depuis la génération précédente |
| GLM-5.3-Flash | 0,15 $ | 0,50 $ | Promotion jusqu’au 9 septembre : 0,075 $/0,25 $ |
Chez OpenAI, les modes Batch et Flex coûtent deux fois moins cher, le mode rapide deux fois plus cher pour une vitesse doublée. GPT-6 Astra présente une autre particularité d’accès : c’est le premier modèle à franchir le seuil critique de cybersécurité du Preparedness Framework d’OpenAI. L’API standard refuse les tâches de recherche de vulnérabilités, l’accès complet n’est accordé qu’aux programmes Trusted Access et Daybreak, et les utilisateurs ordinaires, prévient OpenAI, peuvent se heurter à des ralentissements et à des blocages.
Comparaison des coûts
| # | Modèle | Score | Prix /1M (entrée/sortie) | Par test | Depuis la Russie |
|---|---|---|---|---|---|
| 16 | Kimi K3 | 7,4 | $3.00/$15.00 | $0.219 | sans VPN |
| 3 | GPT-5.6 Sol | 8,0 | $5.00/$30.00 | $0.190 | VPN nécessaire |
| 26 | Claude Opus 4.6 | 6,8 | $5.00/$25.00 | $0.216 | VPN nécessaire |
| 41 | MiniMax M3 | 6,2 | $0.30/$1.20 | $0.010 | sans VPN |
| 39 | MiMo v2.5 Pro | 6,2 | $1.00/$3.00 | $0.027 | sans VPN |
| 24 | Grok 4.5 | 6,9 | $2.00/$6.00 | $0.028 | VPN nécessaire |
| 40 | Kimi K2.6 | 6,2 | $0.74/$3.49 | $0.036 | sans VPN |
| 44 | Qwen 3.6 Plus | 6,1 | $0.33/$1.95 | $0.011 | sans VPN |
| 45 | DeepSeek V4 Pro | 6,0 | $0.43/$0.87 | $0.005 | sans VPN |
| 58 | DeepSeek V4 Flash | 5,6 | $0.09/$0.18 | $0.001 | sans VPN |
| 56 | DeepSeek V4 Flash (Yandex Cloud) | 5,6 | $3.00/$5.00 | $0.023 | sans VPN |
| 71 | GigaChat 3.5 Ultra | 5,1 | $1.07/$3.21 | $0.011 | sans VPN |
| 65 | Alice AI LLM (v3) | 5,4 | $4.10/$9.84 | $0.020 | sans VPN |
| 74 | GigaChat 2 Max | 4,5 | $7.22/$7.22 | $0.013 | sans VPN |
| 46 | Gemini 3.1 Pro | 6,0 | $2.00/$12.00 | $0.027 | VPN nécessaire |
Modèles dans le benchmark : 74, données au 2026-11-20 · Classement complet →
Les offres gratuites que le tableau ne montre pas : chat illimité chez Kimi, accès gratuit complet chez Qwen et DeepSeek, interface web pour GigaChat, Alice et Yandex Browser pour Alice AI, et Grok via l’abonnement X Premium.
Le coût par test correspond au coût moyen d’un scénario du benchmark (prompt système + tâche + réponse du modèle, soit en moyenne environ 2 000 tokens en entrée et 1 500 en sortie). Voir la méthodologie du benchmark détaillée.
DeepSeek V4 Flash sur Yandex Cloud coûte 23 fois plus cher que l’original pour une qualité légèrement inférieure – voir la colonne « Coût par test » ci-dessus. Ce que vous payez, c’est l’hébergement des données en Russie et le SLA de Yandex.
Quel outil choisir : 7 cas d’usage
1. Un assistant polyvalent pour le quotidien
ChatGPT dispose de l’écosystème le plus large : génération de texte, images, analyse de données, travail sur fichiers, intégrations via le GPT Store. Avec GPT-6 Astra, le pari s’est déplacé vers le pilotage de l’ordinateur : un contexte d’un peu plus de 1M de tokens, une entrée texte et image, une sortie uniquement textuelle, et pas d’entrée audio. Anthropic propose un choix plus lisible au sein de sa gamme : Opus 5 à 5 $/25 $ pour la plupart des tâches, Fable 5.1 à 10 $/50 $ pour les plus difficiles, et un raisonnement adaptatif (adaptive thinking) toujours actif, qu’il n’est plus nécessaire d’activer à la main.
En septembre, l’actualité produit d’Anthropic est plus intéressante que l’actualité modèles. Claude dans Chrome est disponible pour tous sur l’ensemble des offres payantes, Cowork a reçu un navigateur intégré, et la mémoire est désormais partagée entre le chat et Cowork. Pour un déploiement en entreprise, un détail est à trancher en amont : sur les offres Team et Enterprise, la mémoire est désactivée par défaut.
2. Recherche et vérification des faits
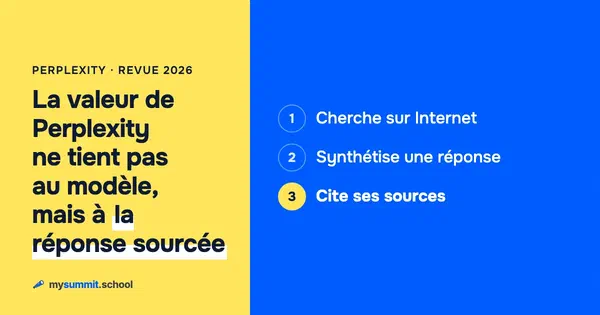
Un outil qui cherche l’information sur le web et affiche les liens vers ses sources. Le mode Deep Research est fait pour les questions complexes.
3. Travailler dans l’écosystème Google
Si votre entreprise utilise Google Workspace, Gemini est intégré à Gmail, Docs, Sheets et Drive. 3.8 Flash a été ajouté à l’application Gemini sur les offres Pro et Ultra, à l’AI Mode de la recherche et à Google Sheets. La fenêtre de contexte de 2 millions de tokens appartient à Gemini 3.1 Pro : c’est ce modèle qui permet d’analyser des documents gigantesques.
Deux éléments à intégrer au plan d’achat. Google n’a pas de modèle haut de gamme en ce moment : si la tâche exige le maximum, il n’y a rien à choisir. Et le tarif de lancement de 3.8 Flash court jusqu’au 31 décembre 2026, sans tarif normal publié : bâtir un budget sur ces 0,75 $ est risqué.
4. Travail en russe et données hébergées en Russie
Ce cas ne concerne que les entreprises présentes en Russie ou qui travaillent sur des contenus en russe : GigaChat (de Sber) et YandexGPT y sont les deux grands modèles nationaux, et tous deux hébergent les données en Russie. GigaChat 3.5 Ultra est le meilleur modèle russe de notre benchmark de juillet, même si aucun modèle ne maîtrise de façon fiable le droit du travail (occidentaux compris). YandexGPT est intégré à l’écosystème Yandex (Yandex 360, Browser, Alice). L’alternative : DeepSeek V4 Flash sur Yandex Cloud, qui devance Alice AI dans la série de juillet et héberge les données en Russie, mais coûte 28 à 33 fois plus cher que l’original.
Deux choses ont changé cet été. Sber a publié GigaChat 3.5 Ultra sous MIT : un MoE de 432 milliards de paramètres à attention linéaire, presque deux fois plus compact que le précédent modèle phare et jusqu’à quatre fois plus rapide sur les textes longs. Selon nos mesures de juillet, il reste loin des leaders, mais la possibilité de le faire tourner en interne change le calcul. Yandex a relancé Alice sur le nouveau Alice AI LLM, à poids fermés, et mis à jour YandexGPT 5.1 Pro. Selon Yandex, la part de bonnes réponses est passée de 60 % à 71 % et les hallucinations ont été divisées par deux, à 16 %. Le prix a été divisé par trois. Depuis le 16 juillet, toute la gamme Alice AI – LLM, ART et VLM – est certifiée ISO/IEC 42001.
5. Budget minimal
DeepSeek V4 Flash revient 130 fois moins cher que Gemini 3.1 Pro, pour une qualité supérieure. Qwen 3.7 Plus, c’est « la planification quasi gratuite ». Les prix par test sont dans le tableau dynamique ci-dessus.
Deux sorties absentes de notre benchmark s’y ajoutent. Qwen3.8-Flash-Next est une préversion ouverte de l’architecture Qwen4 : 125 milliards de paramètres, dont 6 milliards actifs par token. Le contexte de 262 000 tokens s’étend à 1M via YaRN, pour un prix d’environ 0,16 $/0,47 $. Une couche d’embeddings n-gram de 51 milliards de paramètres réside en mémoire vive classique plutôt qu’en mémoire vidéo. Selon Alibaba, il devance DeepSeek-V4-Flash et Claude Opus 4.6 sur la plupart des tâches testées. GLM-5.3-Flash, à 0,15 $/0,50 $, y ajoute la multimodalité et la licence MIT.
Avec une réserve sur DeepSeek : hausse des prix, plages de pointe et cache plus cher signifient que l’ère du « agressivement bon marché » est terminée. Bon marché, il l’est toujours.
6. Confidentialité des données
Qwen, et c’est désormais une vraie réponse.
Qwen3.8-27B : Apache 2.0, encodeur visuel, image et vidéo natives, contexte de 262 000 tokens, environ 17 Go en Q4_K_M. Une seule carte graphique grand public ou un portable de 16 Go via Ollama et llama.cpp. En juillet encore, cette place revenait à des modèles ouverts de génération précédente – utilisables, mais nettement plus faibles que ceux du cloud ; c’est aujourd’hui un modèle que l’on peut confier sereinement à son équipe.
À côté, deux options plus lourdes. GLM-5.3-Flash sous MIT, environ 306 Gio en FP8, NVIDIA Hopper ou plus récent : le seul modèle multimodal de ce niveau que l’on peut légalement déployer sur son propre matériel sans aucune condition de licence. Et GigaChat 3.5 Ultra sous MIT, si un modèle développé sous juridiction russe compte pour vous.
Qwen3.8-Max est lui aussi formellement promis en poids ouverts, mais en pratique cela signifie environ 2,5 To en FP8, un data center et une licence avec seuil de chiffre d’affaires. Pour la plupart des entreprises, ce n’est pas une option d’auto-hébergement.
7. Création de contenus multimédias
ChatGPT et des outils spécialisés.
GPT-6 Astra n’accepte pas l’audio et ne génère pas d’images par lui-même : la génération d’images s’y branche comme un outil. Au cours de l’été, une couche à part s’est développée autour des modèles phares : Gemini Omni Flash génère et monte de la vidéo de 360p à 4K, Lyria 3.5 compose des morceaux complets, Gemini 3.5 Transcribe reconnaît la parole dans plus de 85 langues, distingue les intervenants et horodate chaque mot avec précision, et grok-imagine-video-1.5 produit du 1080p natif.
Une revue détaillée des outils d’IA pour créer des images, des vidéos, de la musique et des présentations fait l’objet d’un article distinct de la série.
Comment comparer les modèles objectivement
Les promesses marketing ne sont pas le meilleur critère de choix. Utilisez des benchmarks indépendants :
- Benchmark mysummit.school – 47 modèles sur de vraies tâches de management, deux modèles juges indépendants
- Artificial Analysis – une échelle unique pour l’intelligence, le prix mixte et la vitesse de génération ; gardez en tête le recalibrage entre versions de l’indice
- LMArena – comparaison anonyme et à l’aveugle des modèles par de vraies personnes ; les neuf premières positions se chevauchent dans leurs intervalles
- SWE-bench – pour évaluer les capacités agentiques d’un modèle
Le mieux reste encore de tester deux ou trois finalistes sur vos vraies tâches.
Conseil pratique : la stratégie « principal + secours »
Ne vous enfermez pas dans un seul outil. La stratégie optimale :
- Outil principal – pour 80 % des tâches quotidiennes (ChatGPT, Claude ou Gemini). D’après le benchmark : Claude Opus 4.6 ou Grok 4.5, et pour une fraction du prix, Kimi K3 et MiMo v2.5 Pro.
- Outil de secours – quand le principal échoue ou n’est pas disponible. DeepSeek V4 Flash et Qwen 3.7 Plus sont gratuits.
- Outil spécialisé – pour des tâches précises : Perplexity pour la recherche, GigaChat 3.5 Ultra pour des données qui doivent rester en Russie, Qwen pour des données confidentielles sur votre propre serveur.
Cette approche offre une marge de sécurité et permet de tirer parti des points forts de chaque outil.
Transposée à la gamme de septembre, la même logique donne : GPT-6 Astra ou Claude Fable 5.1 comme outil principal, Claude Opus 5 comme modèle de travail deux fois moins cher, et GLM-5.3-Flash ou Qwen3.8-Flash-Next comme solution de secours que vous pouvez aussi héberger vous-même. Gemini 3.8 Flash mérite une ligne à part, pour les tâches où la vitesse de réponse compte plus que les trois derniers points de qualité.
Le tableau en tête de cet article est devenu obsolète en six semaines, et le suivant vieillira à peu près aussi vite : Google promet Gemini 3.5 Pro, xAI entraîne Grok 5, et Z.ai garde les poids de GLM-5.3 en revue de sécurité post-lancement. Dans ce genre de tableau, ce sont les scores qui changent le plus vite. La colonne licence est celle qui bouge le moins, et en septembre 2026 c’est elle qu’il faut lire en premier : la licence MIT de GLM-5.3-Flash et l’Apache 2.0 de Qwen3.8-27B survivront à la prochaine sortie comme au prochain recalibrage.
Autres parties de cette série
 Partie 1
ChatGPT en 2026 : ce qui a changé et par où commencer quand on est manager
 Partie 2
Claude d'Anthropic en 2026 : Opus 5, Fable 5.1, Mythos 5.1, Cowork et Chrome – le guide du manager
 Partie 3
Perplexity AI en 2026 : le moteur de recherche intelligent passé au crible pour les managers
 Partie 4
Google Gemini en 2026 : modèles, NotebookLM et intégration Workspace
 Partie 5
Grok de SpaceXAI en 2026 : l'IA d'Elon Musk passée au crible
 Partie 6
YandexGPT en 2026 : revue de l'IA russe de Yandex pour les entreprises
 Partie 7
DeepSeek en 2026 : V4-Pro et V4-Flash après la hausse des prix
 Partie 8
GigaChat en 2026 : revue honnête – vaut-il le coup pour le travail ?
 Partie 9
Qwen d'Alibaba en 2026 : les poids ouverts reviennent au sommet de la gamme
 Partie 10
Comment évaluer la qualité des LLM en 2026 : guide des benchmarks pour managers
 Partie 11
L'IA pour créer du contenu multimédia en 2026 : images, vidéo, musique et présentations
 Partie 13
Chat Z.AI (GLM-5) en 2026 : le modèle chinois qui se fait passer pour Claude
 Partie 14
Kimi de Moonshot en 2026 : K3, K2.6, K2.7-Code et agents pour le manager
 Partie 15
GigaChat au travail : tirer le meilleur de l'IA souveraine russe
 Partie 16
Quand les benchmarks IA perdent leur sens : comment choisir un modèle
 Partie 17
Meta Muse Spark : le premier modèle fermé de Meta depuis 2023
 Partie 18
Les modèles Microsoft MAI en 2026 : ce qui est vraiment accessible, et à quel prix
 Partie 19
Agents de code en 2026 : deux formats, le terminal et le bureau
Toutes les revues de la série
- ChatGPT d’OpenAI – un écosystème universel et le pilotage de l’ordinateur
- Claude d’Anthropic – la meilleure qualité rédactionnelle et la sécurité
- Perplexity AI – un moteur de recherche nouvelle génération
- Gemini de Google – l’intégration à Workspace et quatre sorties Flash en 106 jours
- Grok de xAI – l’IA d’Elon Musk intégrée à X
- YandexGPT – l’IA russe adossée à l’écosystème Yandex
- DeepSeek – le modèle chinois aux prix agressifs
- GigaChat de Sber – l’IA russe pour les entreprises
- Qwen d’Alibaba – le plancher des prix et les poids ouverts
- Comment évaluer la qualité des LLM – les benchmarks pour les managers
- L’IA pour créer des contenus multimédias – images, vidéo, musique
- GLM-5 de Z.ai – un modèle chinois à poids ouverts et multimodal

18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.