DeepSeek en 2026 : V4-Pro et V4-Flash après la hausse des prix
Modèles d’IA dans cet article
DeepSeek (souvent écrit « Deep Seek ») est une start-up chinoise de l’IA qui s’est hissée en deux ans parmi les leaders du secteur. En avril 2026, elle a lancé V4. Le 13 août, V4-Pro est sortie de la bêta, et le 16 août l’entreprise a revu sa grille tarifaire.
La version précédente de cet article présentait DeepSeek comme le flagship économique et promettait des prix 10 à 50 fois inférieurs à ceux de la concurrence. La première affirmation tient toujours. La seconde est à recalculer : DeepSeek a relevé ses tarifs, introduit des créneaux de pointe, et le prix d’un accès au cache a augmenté jusqu’à 1 100 % par rapport aux premiers tarifs de la préversion. L’entreprise y voit le passage au statut de fournisseur de calcul pérenne. Quoi qu’il en soit, un budget établi sur les prix du printemps ne tient plus.
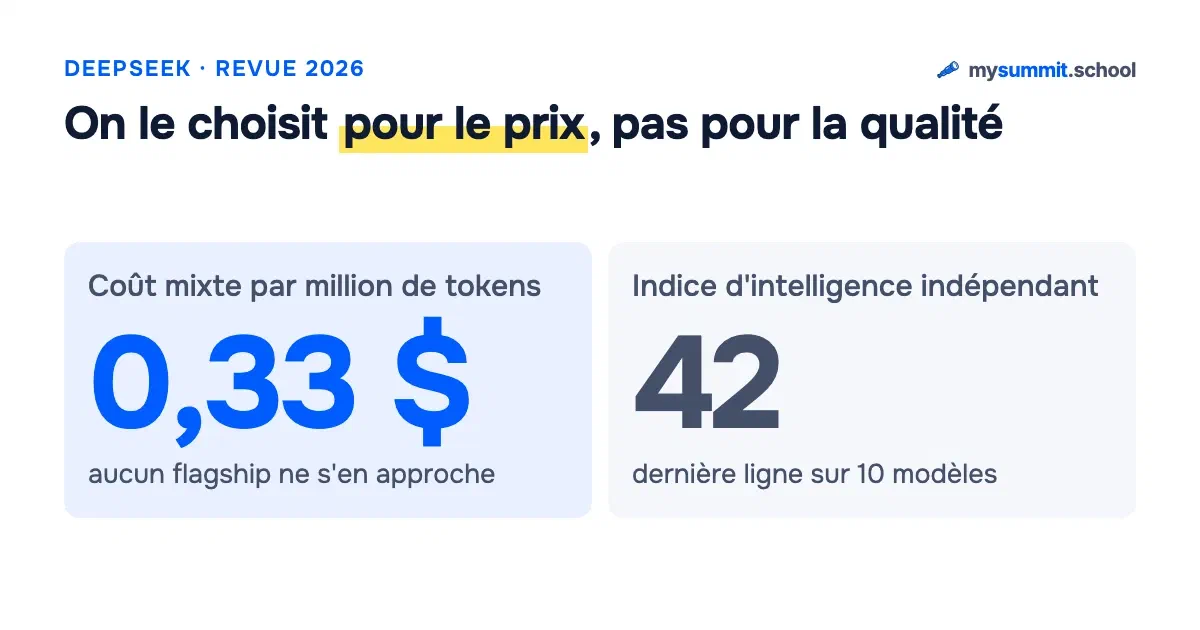
Pour un manager, DeepSeek reste avant tout une question de prix. À 0,33 $ le million de tokens en coût mixte, aucun autre flagship du tableau d’Artificial Analysis ne s’en approche. Mais le prix n’est plus agressif, et cela change la nature de la décision : choisir DeepSeek « parce que c’est le moins cher » doit désormais être un choix réfléchi, en sachant précisément ce que l’on achète.
Tous les modèles sont publiés sous licence MIT : on peut les télécharger et les déployer sur ses propres serveurs. Attention toutefois : l’endpoint public tourne en quantification FP4, si bien que les réponses de l’API et celles d’un modèle déployé en local à partir des poids complets ne coïncident pas forcément.
Qu’est-ce qui distingue DeepSeek ?
V4-Pro est un modèle MoE (mixture of experts) de 1 600 milliards de paramètres, dont 49 milliards actifs à chaque token. Vous payez la partie active : à taille de flagship, la requête reste bon marché. L’attention hybride et la compression du cache KV réduisent le coût sur les longs contextes.
- Une fenêtre de contexte de 1 048 576 tokens – environ 750 000 mots, soit près de 2 500 pages de texte.
- Une sortie plafonnée à 393 216 tokens, la plus élevée de tous les modèles de ce comparatif.
- Trois niveaux d’effort de raisonnement. Dans l’API DeepSeek, ils s’appellent low, high et max ; sur OpenRouter, le même modèle propose high et xhigh. Si vous développez une intégration, vérifiez les noms des modes chez chaque fournisseur : ils ne correspondent pas.
Les principaux modèles DeepSeek (septembre 2026)
DeepSeek V4-Pro
 DeepSeek V4 ProComprend les tâches simples
score 6,0/10 rang 45 sur 74 $0,005 par tâche sans VPN
Testé dans le benchmark mysummit.school : mai 2026À propos du modèle →Comparer →
Le flagship, disponible pour tous depuis le 13 août 2026 dans l’application, sur le web et via l’API. Un assistant polyvalent : rédaction, analyse, code, travail sur les données. Le modèle reste purement textuel – la fiche de Pro ne mentionne aucune entrée image, audio ou vidéo.
Les chiffres de l’éditeur, tirés du rapport accompagnant cette sortie : Terminal Bench 2.1 – 87,9, HLE avec outils – 60,0, DSBench-FullStack – 71,1. Pour la variante V4-Pro-Max, DeepSeek annonce 93,5 sur LiveCodeBench et 80,6 sur SWE-bench Verified, ainsi qu’un classement Codeforces de 3 206 et 83,5 sur MRCR à un million de tokens. Ce sont les évaluations de DeepSeek lui-même ; le tableau indépendant présenté plus bas est plus modeste.
- Contexte de 1 000 000 de tokens en entrée, jusqu’à 393 216 tokens en sortie
- Outils, tool_choice, sortie structurée en JSON
- Poids sous licence MIT, endpoint public en FP4
Le plafond de sortie mérite qu’on s’y arrête. 393 216 tokens, c’est environ 295 000 mots – le rapport annuel d’un grand groupe en une seule passe. Chez les autres modèles du comparatif, ce plafond est plusieurs fois plus bas, et pour quiconque génère de longs documents, c’est la seule caractéristique qu’aucun score d’intelligence ne remplace.
DeepSeek V4-Flash
DeepSeek V4 FlashComprend les tâches simples
score 5,6/10 rang 58 sur 74 $0,001 par tâche sans VPN
Testé dans le benchmark mysummit.school : mai 2026À propos du modèle →Comparer →
Le modèle rapide et bon marché, avec 284 milliards de paramètres. Sa sortie officielle en bêta publique date du 31 juillet 2026 ; l’éditeur a mis en avant les capacités agentiques et la prise en charge de la Responses API pour Codex. Terminal Bench 2.1 – 82,7 selon DeepSeek.
Même contexte d’un million de tokens, mêmes modes de raisonnement. Le modèle est taillé pour les tâches à fort volume : chatbots, traitement de documents, requêtes en masse.
Un point à garder en tête : Qwen3.8-Flash-Next devance V4-Flash sur la plupart des tâches testées, avec nettement moins de paramètres actifs. Au cours de l’été, V4-Flash a cessé d’être le modèle le plus fort de sa catégorie.
Vision : deepseek-v4-flash-vision-exp
Le 21 août 2026, DeepSeek a publié son premier modèle acceptant des images en entrée. Il s’appelle via model='deepseek-v4-flash-vision-exp' et il est facturé aux tarifs de V4-Flash.
Usages annoncés : automatisation d’interfaces et lecture de graphiques. Le modèle accepte des images statiques et des séquences de captures d’écran ; il ne traite pas de véritable flux vidéo. Chartography – 64,3, et l’éditeur affirme que ses capacités agentiques multimodales approchent celles d’Opus 4.8. Les deux chiffres sont les siens.
Le modèle ne figure pas encore dans notre benchmark, et il n’existe pas non plus d’évaluations indépendantes – seulement les données de DeepSeek.
Le suffixe -exp n’est pas là pour décorer. C’est une préversion : impossible d’y adosser un processus en production, comportement et prix pouvant changer à tout moment. La vision est arrivée sur la gamme bon marché – le flagship, lui, reste textuel.
La génération d’images relève toujours de la gamme distincte Janus-Pro-7B : 80 % sur GenEval contre 67 % pour DALL-E 3, avec une résolution limitée à 384×384 px.
Les prompts pour DeepSeek semblent simples : on charge un document, on demande une conclusion. La difficulté commence quand il faut une réponse précise – avec des chiffres qui se recoupent et des risques qui ne se perdent pas en page deux. Entre « le modèle a répondu » et « on peut travailler avec le modèle », il y a une compétence : savoir formuler la tâche.
Face à la concurrence
Ce que disent les classements indépendants
Voici l’instantané de septembre d’Artificial Analysis pour dix modèles de premier plan. Indice d’intelligence, prix mixte au million de tokens et vitesse de génération – tout est mesuré selon une même méthodologie, et c’est ce qui rend le tableau utile.
| Modèle | Éditeur | Intelligence Index | Prix mixte, $/1M | Sortie, tokens/s |
|---|---|---|---|---|
| Claude Fable 5.1 (max) | Anthropic | 57 | 6,12 $ | 70 |
| GPT-6 Astra (max) | OpenAI | 55 | 2,57 $ | 71 |
| Claude Opus 5 (max) | Anthropic | 54 | 4,21 $ | 58 |
| Grok 4.6 (high) | xAI | 51 | 1,25 $ | 63 |
| Kimi K3 (max) | Moonshot | 50 | 1,58 $ | 42 |
| GLM-5.3 (max) | Z.ai | 49 | 1,26 $ | 87 |
| Gemini 3.8 Flash (high) | 47 | 0,74 $ | 334 | |
| Qwen3.8-Max | Alibaba | 47 | 1,19 $ | 40 |
| GLM-5.3-Flash | Z.ai | 46 | 0,18 $ | 48 |
| DeepSeek V4-Pro 0813 (max) | DeepSeek | 42 | 0,33 $ | 71 |
DeepSeek V4-Pro arrive dernier en intelligence dans ce tableau ; seul GLM-5.3-Flash est moins cher, et il joue dans une autre catégorie. Entre la première et la dernière ligne, l’écart est de 15 points d’indice ; entre le prix le plus élevé et le plus bas, il est de 1 à 34. Voilà le positionnement honnête de DeepSeek en septembre 2026 : on le prend pour son prix.
Une réserve sur l’échelle elle-même. Artificial Analysis publie son indice par versions et le recalibre de l’une à l’autre : le « 60 » d’un billet de lancement et le « 42 » de l’instantané actuel relèvent de systèmes de coordonnées différents. La comparaison n’a de sens qu’au sein d’un même instantané. Pour comprendre comment ce type de mesure fonctionne, voir Comment fonctionnent les benchmarks de LLM en 2026.
LMArena offre un second éclairage : DeepSeek n’y figure dans le top 10 ni en texte, ni en vision. Les intervalles de confiance des neuf premières lignes du classement texte se chevauchent – les places un à neuf sont statistiquement indiscernables. Toute conclusion du type « le modèle X est le meilleur » prête à ce classement plus qu’il ne mesure, exactement l’argument que la série a développé dans Les benchmarks IA perdent leur sens.
Les voisins chinois
Kimi K3 est le principal concurrent chinois de DeepSeek sur les tâches agentiques. Dans l’instantané d’Artificial Analysis, il obtient 50 points d’indice pour un prix mixte de 1,58 $ : environ cinq fois plus cher que V4-Pro, pour huit points de plus. K3 ne figure pas encore dans notre propre benchmark ; les données citées ici viennent de la plateforme indépendante.
La ligne la plus gênante pour DeepSeek dans ce même tableau est celle de GLM-5.3-Flash : 46 points d’indice et 0,18 $ de prix mixte. Quatre points de plus que V4-Pro, pour presque deux fois moins cher. L’argument « prenons DeepSeek, c’est moins cher que les autres modèles chinois » ne va plus de soi.
Là où V4-Pro est plus fort
- Une sortie plafonnée à 393 216 tokens, la plus élevée du comparatif. Pour générer de longs documents, personne dans ce tableau n’offre un tel chiffre.
- Un long contexte à un prix raisonnable : un million de tokens en entrée pour environ 0,435 $ le million en accès direct hors pointe.
- Le code, selon l’éditeur : 93,5 sur LiveCodeBench et 80,6 sur SWE-bench Verified pour V4-Pro-Max.
- Des poids sous licence MIT : on peut rapatrier le modèle dans son propre périmètre, ce qui est impossible avec les flagships fermés du haut du tableau.
Là où V4-Pro est en retrait
- L’évaluation indépendante de la qualité. 42 points chez Artificial Analysis, soit la dernière ligne parmi les dix modèles de cet instantané.
- L’écart entre les chiffres de l’éditeur et la vérification indépendante. DeepSeek annonce 87,9 sur Terminal Bench 2.1 et 60,0 sur HLE avec outils, tandis que l’indice indépendant place le modèle en fin de liste. Les deux chiffres sont obtenus honnêtement ; ils répondent simplement à des questions différentes.
- La multimodalité. Le flagship n’en a aucune, et sur Flash elle reste en préversion. Chez Claude, GPT et Gemini, l’analyse d’images est intégrée au modèle principal.
- La communication. D’après nos données, l’un des pires résultats parmi les modèles de tête sur les tâches de formulation de feedback.
Cela dit, changer de modèle n’est pas le seul moyen de réduire l’écart sur les tâches agentiques. En août 2026, l’étude StateM a fait passer DeepSeek-V4 Flash de 82,7 % à 88,1 % sur Terminal-Bench 2.1 sans toucher aux poids – uniquement grâce à l’outillage autour du modèle : runbooks, état persistant et vérification des étapes. Ce qui a été fait exactement, et pourquoi cela compte pour les modèles ouverts à bas coût, est détaillé dans notre analyse des derniers benchmarks de prompt engineering (en russe).
Savoir quel modèle est le moins cher, c’est utile. Savoir expliquer pourquoi, sur votre tâche, le modèle bon marché donne un résultat acceptable et pas sur la tâche d’à côté, c’est plus utile encore.
Usages concrets pour un manager
- « Traduire » du technique en langage clair – condenser un rapport technique dense en une note courte pour la direction.
- Éprouver la logique d’une décision (mode max) – chargez un business plan et demandez-en les points faibles. Le niveau de raisonnement maximal fait ressortir des risques peu évidents.
- Analyse de données – décrivez avec vos mots ce que vous voulez tirer d’un tableau Excel, et DeepSeek écrira les formules ou un script.
- Travail sur de gros documents – chargez un règlement intérieur ou un rapport annuel (jusqu’à ~2 500 pages) et posez vos questions. Un contexte d’un million de tokens contient des bases de code ou des bases de connaissances d’entreprise entières.
- De longs documents en sortie – le plafond de 393 216 tokens permet de demander un texte cohérent de plusieurs centaines de pages en une seule requête, sans recoller des morceaux.
- Accélérer l’équipe IT – écriture de code, revue, tests et documentation.
À vous de tester : analyse d’une décision risquée
Voici un cas de management aux problèmes peu évidents. Cliquez sur « Exécuter » et comparez la façon dont V4-Pro, V4-Flash et Kimi K3 débusquent les risques. Regardez la profondeur du raisonnement et le degré de précision des recommandations.
Vous
Tu es un analyste d'affaires expérimenté. Trouve les risques cachés dans la décision suivante.

## Décision
Une chaîne de 40 cafés à Paris prévoit de convertir en 3 mois toutes ses boutiques à une préparation du café entièrement automatisée (robots-baristas). Budget : 1,2 M€. Économies attendues sur la masse salariale : 80 000 €/mois. Retour sur investissement : 15 mois. Un pilote sur 2 boutiques a montré une hausse de 40 % de la vitesse de service.

## Contexte
- 340 baristas concernés par un licenciement collectif, nécessitant un plan de sauvegarde de l'emploi (PSE) au titre du Code du travail
- Les baux de 60 % des boutiques arrivent à échéance dans 18 mois
- Ticket moyen : 4 €, 70 % du chiffre d'affaires réalisé pendant le coup de feu matinal (7h00–9h30)
- NPS des clients actuels : 72

## Mission
1. Identifie 3 à 5 risques que les auteurs de la décision ont pu négliger
2. Pour chacun : probabilité (élevée/moyenne/faible) et impact potentiel
3. Actions concrètes pour atténuer chaque risque
4. Quelles hypothèses ne sont pas étayées par des données ?
5. Recommandation finale : accepter, retravailler ou rejeter
Ce qu’il faut regarder dans les réponses :
- V4-Pro au niveau de raisonnement maximal construit une chaîne d’analyse et repère plus souvent les liens peu évidents (baux + licenciements = risque d’image ; un pilote sur 2 boutiques n’est pas représentatif pour 40)
- V4-Flash répond plus vite et moins cher, mais manque plus souvent les interactions entre les risques
- Kimi K3 structure en général sa réponse plus en détail, mais peut se montrer redondant
Mise à jour : notre benchmark, les nouveaux prix et les revendeurs (septembre 2026)
Notre benchmark de tâches managériales (42 modèles, 80 scénarios) a testé DeepSeek V4 aux prix du printemps. Les résultats sur la qualité restent valables ; les chiffres de coût, non.
DeepSeek V4-Pro
- Information search5,8
- Data analysis6,3
- Decisions under uncertainty6,6
- Feedback analysis6,5
- Corporate requirements and risks5,8
- Automation5,5
- People management6,5
- Russia and Kazakhstan specifics5,0
Côté prix, c’est la dispersion, et mieux vaut montrer le tableau complet que choisir le chiffre qui arrange. En direct chez DeepSeek, hors pointe, comptez environ 0,435 $ le million de tokens en entrée et 0,87 $ en sortie, l’accès au cache tournant autour de 0,0036 $. Le prix mixte d’OpenRouter sur 16 à 17 fournisseurs est d’environ 0,69 $ et 1,37 $, avec une lecture de cache à 0,057 $. L’écart tient à la fois à la tarification de pointe et à la marge que chaque fournisseur ajoute. Pour votre budget, prenez le canal par lequel votre trafic passera réellement.
Là où le modèle convient, d’après nos scénarios : plans de déploiement de processus, scripts de conversations d’équipe difficiles, correspondance courante en volume. Là où il déçoit systématiquement : ROI et modèles financiers avec erreurs de calcul, argumentaires juridiques, analyse de tarifs SaaS.
DeepSeek V4-Flash
0,09 $/0,18 $ le million de tokens hors pointe : c’est le dernier prix publié du modèle, et il double pendant les créneaux de pointe. Dans notre benchmark, Flash s’est classé au-dessus de Gemini 3.1 Pro pour un prix inférieur de deux ordres de grandeur. Un bon modèle de travail pour les textes et les plans, à condition de répartir vos requêtes selon les créneaux tarifaires.
Convient pour : rapports hebdomadaires, classement des retours clients, plans trimestriels et matrices de risques. Ne convient pas pour : budgets et modèles financiers, droit international et RGPD, code d’automatisation.
Passer par un revendeur : le cas de Yandex Cloud
Un revendeur ajoute sa propre couche tarifaire à celle de DeepSeek. Yandex Cloud, le premier fournisseur cloud russe, commercialise DeepSeek V4 Flash via sa propre API. DeepSeek V4 Flash (Yandex Cloud) est exactement le même modèle, à prix fixe – et depuis les changements d’août, l’ampleur de la marge dépend de l’heure.
| Paramètre | DeepSeek en direct, hors pointe | DeepSeek en direct, en pointe | Yandex Cloud |
|---|---|---|---|
| Entrée par 1M | 0,09 $ | 0,18 $ | 3,00 $ |
| Sortie par 1M | 0,18 $ | 0,36 $ | 5,00 $ |
| Marge du revendeur | ×33 en entrée, ×28 en sortie | ×17 en entrée, ×14 en sortie | – |
Dans la version printanière de cet article, la marge affichée ici était de 28 à 33 fois. Elle n’a pas disparu ; elle n’est simplement plus la seule : les créneaux de pointe réduisent l’écart de moitié.
Ce que paie cette marge est propre à la Russie : un accès sans VPN, un SLA de Yandex, un hébergement des données dans le pays, une fenêtre de contexte d’un million de tokens. Pour une équipe en France, rien de tout cela ne s’applique, mais la leçon reste valable : un prix fixe de revendeur peut se justifier quand on a besoin de son contrat, de son SLA ou de la localisation des données, et la prime se réduit si votre trafic tombe de toute façon en heures de pointe. Si rien de cela ne compte et que vous pouvez sortir le trafic des créneaux de pointe, l’accès direct revient des dizaines de fois moins cher – et, selon notre benchmark, il est même un peu plus précis.
Les générations précédentes
DeepSeek V3.2 (testé auparavant) – un solide niveau moyen-supérieur, particulièrement fort en planification et en résolution de problèmes. Sa vraie faiblesse : la communication, avec l’un des pires résultats parmi tous les modèles testés.
DeepSeek R1 – un niveau comparable. Ses points forts : la recherche d’information et l’analyse, où le raisonnement pas à pas fait la différence.
Résultats interactifs complets ->
L’analyse détaillée par catégorie se trouve dans notre article sur les meilleurs outils IA pour managers.
Limites et risques
- Une multimodalité en préversion – le flagship V4-Pro est textuel ; l’entrée image est arrivée le 21 août, uniquement sur la gamme Flash et avec le suffixe
-exp. Le modèle ne traite pas de vraie vidéo. La génération d’images relève d’une gamme Janus-Pro distincte, en 384×384. Chez Claude, GPT et Gemini, la multimodalité est intégrée au modèle principal. - Sécurité du contenu – les filtres de protection sont plus faibles que ceux de ChatGPT et de Claude. Le modèle se laisse plus facilement « convaincre » de générer du contenu indésirable.
- Confidentialité des données – l’entreprise est basée en Chine. Solution : télécharger le modèle (licence MIT) et le déployer en local – les versions distillées 7B et 14B de DeepSeek tournent sur un ordinateur portable ordinaire. Gardez en tête le FP4 de l’endpoint public : l’API et une installation locale à partir des poids complets ne se comportent pas de la même façon.
- Moins d’intégrations prêtes à l’emploi – pas de plugins officiels pour les CRM ou ERP. Mais le modèle prend en charge les formats d’API d’OpenAI et d’Anthropic : la plupart des outils fonctionnent via un adaptateur.
- Stabilité de l’API – aux heures de pointe, on observe des latences et des échecs. Depuis le 16 août, la pointe est inscrite dans les tarifs, ce qui indique assez bien où la charge est maximale. Pour des systèmes en production, mieux vaut passer par des fournisseurs intermédiaires (DeepInfra, Together.ai, OpenRouter).
- Les anciennes intégrations cassent – les identifiants
deepseek-chatetdeepseek-reasoneront été désactivés le 24 juillet 2026. Si votre intégration n’a pas été mise à jour, elle ne fonctionne déjà plus. - Le chinois d’abord – mais la qualité tient dans les autres langues. Notre benchmark est mené en russe, et selon nos données, DeepSeek V3.2 dépasse tous les modèles russes (dont Alice AI et GigaChat), même sur des tâches propres au contexte russe.
Tarifs et disponibilité
Depuis le 16 août 2026, DeepSeek facture les tokens à deux tarifs. Les créneaux de pointe sont 01h00–04h00 et 06h00–10h00 UTC, et le prix y est doublé. À l’heure de Paris, cela donne 03h00–06h00 et 08h00–12h00 en heure d’été, une heure plus tôt en heure d’hiver.
Le second créneau couvre toute la matinée de travail en France. Tout ce qui tourne en interactif entre 8 h et midi paie le double ; tout ce que l’on peut reporter en traitement de nuit paie moitié moins. L’écart entre ces deux façons de travailler est exactement du simple au double, et vous ne le verrez sur aucune page de tarifs : il dépend de votre planning.
| Canal | Entrée par 1M | Sortie par 1M | Cache |
|---|---|---|---|
| DeepSeek en direct, hors pointe | 0,435 $ | 0,87 $ | ~0,0036 $ |
| DeepSeek en direct, en pointe | ~0,87 $ | ~1,74 $ | deux fois le tarif hors pointe |
| OpenRouter, prix mixte sur 16–17 fournisseurs | ~0,69 $ | ~1,37 $ | 0,057 $ en lecture |
| DeepSeek V4-Flash en direct, hors pointe | 0,09 $ | 0,18 $ | ~0,014 $ |
- Accès gratuit – chat.deepseek.com est utilisable gratuitement, mode de raisonnement approfondi compris.
- Open source (MIT) – tous les modèles peuvent être téléchargés, utilisés commercialement et modifiés sans restriction.
- C’est le cache qui a le plus augmenté – le tarif d’accès au cache de V4-Pro a progressé jusqu’à 1 100 % par rapport aux premiers prix de la préversion. Si vos économies reposaient sur des requêtes répétées avec un long préfixe commun, refaites le calcul.
- La remise de 75 %, annoncée comme temporaire au printemps, est devenue permanente pendant l’été, puis une majoration de pointe s’y est ajoutée en août. Résultat : le prix standard de V4-Pro en sortie est de 0,87 $ hors pointe et d’environ 1,74 $ en pointe.
- Les fournisseurs divergent sur les prix – l’accès direct à DeepSeek est environ une fois et demie moins cher que le prix mixte d’OpenRouter, mais OpenRouter règle la question de la disponibilité et de la tolérance aux pannes.
Pour le budget, le recalcul donne ceci. Une équipe qui traite 100 millions de tokens par mois sur V4-Flash payait environ 18 $ de sortie aux anciens prix. Le même volume en créneau de pointe coûte deux fois plus, et sur V4-Pro en pointe la facture grimpe à plusieurs centaines de dollars. Le seul moyen gratuit de récupérer cet argent : déplacer les traitements batch hors du créneau 8h00–12h00, heure de Paris.
Ce qui a changé entre V3 et V4
| Paramètre | DeepSeek V3.2 | DeepSeek V4-Pro |
|---|---|---|
| Contexte | 128K tokens | 1 000 000 de tokens |
| Paramètres | 671B (37B actifs) | 1,6T (49B actifs) |
| Modes de raisonnement | modèle R1 distinct | intégré (3 niveaux d’effort) |
| Licence | Custom open | MIT |
| Sortie max. | ~8K | 393 216 tokens |
| Entrée image | non | non sur Pro, préversion sur Flash |
| Compatibilité API | format OpenAI | OpenAI + Anthropic |
| Tarification | unique | pointe et hors pointe depuis le 16/08/2026 |
| Puces | Nvidia H800 | Nvidia + Huawei Ascend |
Migrer depuis les anciennes versions
Les identifiants deepseek-chat et deepseek-reasoner ont été désactivés le 24 juillet 2026. Auparavant, ils redirigeaient vers V4-Flash ; désormais, les requêtes échouent tout simplement. Les identifiants actuels sont deepseek/deepseek-v4-flash, deepseek/deepseek-v4-pro et deepseek-v4-flash-vision-exp pour l’entrée image.
Profitez-en pour vérifier les noms des modes de raisonnement : low, high et max sur l’API directe, high et xhigh sur OpenRouter. Une intégration qui transmet consciencieusement reasoning_effort: "max" à un canal peut, sur un autre, retomber silencieusement sur la valeur par défaut.
Liens utiles
- Site officiel de DeepSeek
- DeepSeek Chat – interface web gratuite
- Journal officiel des modifications de l’API
- Documentation de l’API et tarifs
- Modèles sur Hugging Face
- Annonce de V4 (rapport technique)
En quatre mois, DeepSeek a relevé ses prix, introduit des créneaux de pointe, multiplié le coût du cache par dix – et reste le flagship le moins cher du tableau indépendant. L’acheteur qui l’avait choisi au printemps « parce que c’est pas cher » le choisit en septembre pour la même raison, et paie davantage.
Le tableau ne répond pas pour autant à la question essentielle : combien de points d’indice perd votre tâche à vous. On ne peut le vérifier que sur ses propres scénarios – de préférence avant que le modèle soit câblé dans un processus et que le remplacer devienne un projet à part entière.
Cet article fait partie de la série « Revue des outils GenAI 2026 ». Tous les outils sont étudiés avec des exercices pratiques dans le cours mysummit.school.
Autres parties de cette série
 Partie 1
ChatGPT en 2026 : ce qui a changé et par où commencer quand on est manager
 Partie 2
Claude d'Anthropic en 2026 : Opus 5, Fable 5.1, Mythos 5.1, Cowork et Chrome – le guide du manager
 Partie 3
Perplexity AI en 2026 : le moteur de recherche intelligent passé au crible pour les managers
 Partie 4
Google Gemini en 2026 : modèles, NotebookLM et intégration Workspace
 Partie 5
Grok de SpaceXAI en 2026 : l'IA d'Elon Musk passée au crible
 Partie 6
YandexGPT en 2026 : revue de l'IA russe de Yandex pour les entreprises
 Partie 8
GigaChat en 2026 : revue honnête – vaut-il le coup pour le travail ?
 Partie 9
Qwen d'Alibaba en 2026 : les poids ouverts reviennent au sommet de la gamme
 Partie 10
Comment évaluer la qualité des LLM en 2026 : guide des benchmarks pour managers
 Partie 11
L'IA pour créer du contenu multimédia en 2026 : images, vidéo, musique et présentations
 Partie 12
Comparatif des outils GenAI 2026 : quelle IA choisir quand on est manager ?
 Partie 13
Chat Z.AI (GLM-5) en 2026 : le modèle chinois qui se fait passer pour Claude
 Partie 14
Kimi de Moonshot en 2026 : K3, K2.6, K2.7-Code et agents pour le manager
 Partie 15
GigaChat au travail : tirer le meilleur de l'IA souveraine russe
 Partie 16
Quand les benchmarks IA perdent leur sens : comment choisir un modèle
 Partie 17
Meta Muse Spark : le premier modèle fermé de Meta depuis 2023
 Partie 18
Les modèles Microsoft MAI en 2026 : ce qui est vraiment accessible, et à quel prix
 Partie 19
Agents de code en 2026 : deux formats, le terminal et le bureau

18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.