33 modeles IA pour les managers : pourquoi nous avons besoin de vos evaluations
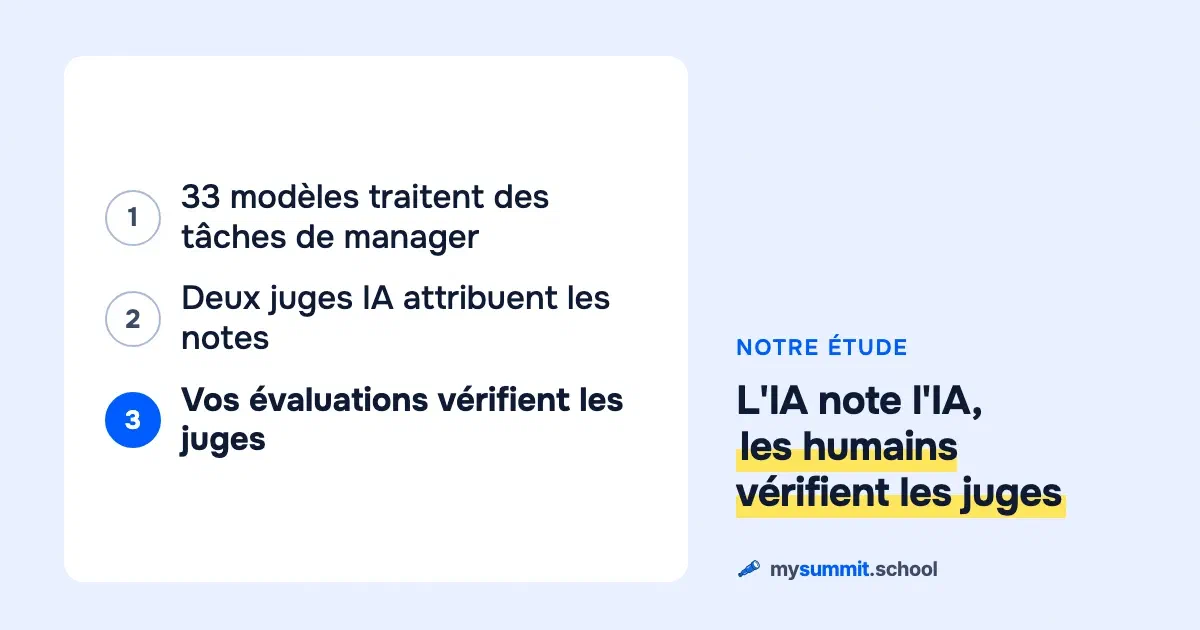
Au cours de l’annee ecoulee, 33 nouveaux modeles IA sont apparus sur le marche, chacun revendiquant le titre de “meilleur assistant du manager”. ChatGPT a ete mis a jour vers GPT-5.2, Claude a lance Opus 4.5, Gemini a ajoute une nouvelle version Pro, Yandex et Sber ont annonce de nouvelles ameliorations, et les modeles chinois sont passes en OpenSource. Comment choisir un outil quand chacun promet une revolution de la productivite ? Nous avons decide de mener une etude comparative a grande echelle – mais nous avons rencontre un probleme qui peut sembler paradoxal.
Le probleme de l’objectivite dans l’evaluation de l’IA
Imaginez : vous demandez a trois modeles IA de preparer un plan pour un entretien individuel avec un employe dont les performances sont en baisse. ChatGPT fournit une liste detaillee de 12 questions avec des explications de techniques psychologiques. Claude propose une structure concise en 5 points axee sur l’empathie. YandexGPT redige un plan tenant compte des normes RH russes et de l’ethique d’entreprise.
Quelle reponse est la meilleure ?
Ce n’est pas un cas ou l’on peut verifier l’exactitude par le calcul – comme en mathematiques. Il n’existe pas de plan unique et correct pour un entretien individuel. La qualite depend du contexte : l’experience du manager, la personnalite de l’employe, la culture d’entreprise et l’urgence du probleme. Un manager appreciera le detail de ChatGPT, un autre preferera la concision de Claude, un troisieme choisira YandexGPT pour sa specificite locale.
De maniere surprenante, meme en testant 33 modeles sur 32 scenarios reels (plus de 1 000 reponses), une question fondamentale demeure : qui determine ce qui constitue une “bonne” reponse ?
Pourquoi nous testons ces 33 modeles specifiques
La liste n’est pas aleatoire. Nous avons selectionne les modeles selon trois criteres : la disponibilite en Russie, la pertinence pour le management et la representation de differentes gammes de prix.
Leaders mondiaux (8 modeles) :
- OpenAI : GPT-5.2-Pro, GPT-4o, GPT-4o-mini (payants et API)
- Anthropic : Claude Opus 4.5, Sonnet 4.5, Haiku 4.5 (trois niveaux de performance)
- Google : Gemini 2.5 Pro, Gemini 3.0 Flash (dernieres versions)
Disponibles en Russie sans VPN (6 modeles) :
- Yandex : AliceLLM, YandexGPT 5 Pro, YandexGPT 5 Lite
- Sber : GigaChat Pro, GigaChat
- DeepSeek, Qwen, Xiaomi (modeles chinois en pleine croissance)
Specialises et de niche (19 modeles) :
- Meta Llama 3.3 70B, Mistral Large, Qwen 2.5 et autres solutions open-source
- Modeles optimises pour le raisonnement (DeepSeek R1, OpenAI o1-mini)
- Modeles legers pour les taches de base (Phi-4 Mini, Gemma 3)
Pourquoi autant ? Parce que dans notre cours, nous enseignons comment choisir le bon outil pour une tache specifique. Un scenario necessite une analyse approfondie (un modele couteux comme GPT-5.2 Pro convient), un autre necessite une generation rapide de texte (le gratuit Gemini 3.0 Flash suffit). Un troisieme necessite de travailler sans VPN (uniquement des modeles russes). Un quatrieme implique le traitement de grands volumes de donnees (les tokens et le cout sont critiques).
Dans le module ouvert, vous pouvez deja decouvrir ce materiel – il contient 12 lecons avec des scenarios pratiques. L’etude nous fournira des donnees concretes : quel modele est le meilleur pour l’analyse d’equipe, lequel pour la preparation de presentations, lequel pour la redaction de feedback. Les etudiants recevront non pas des conseils abstraits comme “utilisez l’IA”, mais un tableau avec les resultats des tests.
La methodologie du “Manager naif”
C’est ici que commence une decision methodologique importante. Nous ne cherchons deliberement pas a optimiser les prompts. Nous n’utilisons pas le chain-of-thought, les few-shot examples, et ne decoupons pas la tache en sous-taches. Les prompts sont formules comme les ecrirait un manager ordinaire sans experience en ingenierie de prompts.
Pourquoi ? Parce que c’est la realite. La plupart des utilisateurs d’IA ecrivent leurs requetes en langage naturel :
“Aide-moi a preparer une reunion avec le directeur au sujet du budget du projet”
Et non pas ainsi :
“Tu es un consultant experimente en finance d’entreprise. Utilise un raisonnement etape par etape. Analyse le contexte suivant : [details du projet]. Propose trois options d’argumentation pour defendre le budget, chacune avec une justification quantitative du ROI…”
Le premier prompt est ce que 90 % des utilisateurs tapent. Le second est le resultat d’une formation en ingenierie de prompts. Nous testons les modeles avec la premiere option parce que nous voulons comprendre : quel outil fonctionne le mieux avec un utilisateur “naif” ?
Cela reflete le probleme reel de l’adoption de l’IA dans les entreprises. On peut enseigner aux employes a ecrire des prompts parfaits, mais cela demande du temps et de la discipline. En pratique, les gens veulent poser une question comme a un collegue – et obtenir une reponse utile. Quel modele gere cela le mieux ?
Dual LLM-as-Judge : quand l’IA evalue l’IA
Avec les mille reponses dont nous disposons, un probleme d’echelle se pose. Un humain ne peut pas evaluer objectivement mille textes en un temps raisonnable. Meme en passant 5 minutes par reponse, cela represente 88 heures de travail – plus de deux semaines ouvrees. Au fil du temps, les standards d’evaluation deriveront inevitablement : ce qui semblait etre une bonne reponse en debut de semaine peut paraitre mediocre face a de nouveaux exemples.
La solution consiste a utiliser le LLM-as-Judge : un modele IA evalue les reponses des autres modeles. C’est une approche populaire dans la recherche en IA, mais elle presente un probleme de biais. Un modele peut mieux noter les reponses d’un style “similaire” au sien ou gonfler inconsciemment les notes pour certaines approches.
Nous utilisons un Dual Judge – deux modeles juges differents :
Juge A : Claude Opus 4.5 – evalue les nuances, le ton et la prise en compte du contexte regional. Claude comprend bien l’empathie, les differences culturelles et les aspects ethiques. Il remarquera si un modele a donne un conseil inapplicable dans la culture d’entreprise russe.
Juge B : Gemini 3 Pro – evalue la structure du raisonnement, la precision des donnees et le format de la reponse. Gemini est plus fort en analytique, dans la verification des chaines logiques et l’identification des erreurs factuelles.
Chaque reponse recoit deux notes independantes sur une echelle de 0 a 5. La note finale est la moyenne arithmetique. Si les juges divergent de plus de 0,75 point (par exemple, l’un donne 2,0 et l’autre 3,0), la reponse est signalee pour revision humaine.
Pourquoi ces modeles juges specifiques ? Claude Opus 4.5 et Gemini 3 Pro sont les meilleurs dans leurs categories respectives, mais ils ont des “philosophies” differentes. Claude tend vers des reponses detaillees et empathiques. Gemini tend vers des reponses structurees et factuelles. En utilisant les deux modeles, nous equilibrons l’evaluation entre “l’humanite” et “l’analyticite” de la reponse.
Calibration avec l’opinion humaine : pourquoi nous avons besoin de votre aide
Ici se pose une question critique : comment savons-nous que les juges evaluent correctement ?
Un modele juge peut etre coherent – attribuant toujours des notes similaires a des reponses similaires. Mais la coherence ne garantit pas l’alignement avec les preferences humaines. Si Claude Opus 4.5 sous-evalue systematiquement les reponses breves (parce qu’il est enclin au detail), il sera injuste envers les modeles au style concis.
La solution est l’Audit humain : un humain evalue des reponses aleatoires sur la meme echelle de 0 a 5. C’est ce qu’on appelle un “Gold Set” – des evaluations de reference auxquelles nous comparons le travail des juges.
Statistiquement, la correlation entre les notes du LLM-Judge et celles des humains doit etre > 0,60 pour que l’evaluation automatisee soit valide. Si la correlation est inferieure, les juges sont peu fiables et leurs notes ne peuvent pas servir au classement des modeles.
Pourquoi des evaluations humaines supplementaires sont-elles necessaires ?
Premierement, pour une verification independante de la fiabilite des juges. Un echantillon de 5 % suffit pour la validation statistique, mais plus il y a d’evaluations humaines, plus la calibration est precise. Si 10 personnes differentes notent la meme reponse, nous verrons la dispersion des avis et comprendrons a quel point l’evaluation de la “qualite” est subjective pour un scenario donne.
Deuxiemement, pour detecter les erreurs systematiques. Si un juge attribue constamment des notes elevees aux reponses avec beaucoup de puces, mais que les humains preferent les reponses concises – c’est un signal pour recalibrer le prompt du juge.
Troisiemement, pour comprendre ce qui compte pour les managers. Peut-etre les professionnels noteront-ils une reponse plus haut si elle contient des metriques specifiques. Ou au contraire – prefereront-ils un ton empathique aux chiffres. Ce sont des insights qualitatifs impossibles a obtenir a partir d’evaluations automatisees.
Ce que nous publierons le mois prochain
Fevrier 2026 – publication des resultats complets de l’etude.
Ce que vous verrez dans le rapport :
- Classement mondial – top 33 des modeles par note moyenne sur tous les scenarios
- Classement des modeles disponibles en Russie – quels outils sont les meilleurs pour ceux qui travaillent sans VPN
- Gagnants par categorie – le meilleur modele pour l’analyse de donnees, la communication, la prise de decision et le travail textuel
- Russia Availability Gap – une evaluation quantitative de l’ecart entre le meilleur modele mondial et le meilleur modele disponible en Russie
- Rapport qualite/prix – quels modeles offrent le meilleur ROI
- Fiabilite des modeles – taux de refus pour les taches professionnelles legitimes
- Analyse des preferences humaines – comment les evaluations humaines correlent avec les notes des juges IA
Pourquoi est-ce important pour le cours ?
Le module “Choix des outils IA” de notre cours ouvert recevra des donnees concretes au lieu de recommandations generales. Les etudiants ne verront pas “ChatGPT est bon pour l’analyse”, mais “ChatGPT GPT-4o a obtenu une note moyenne de 4,2/5 dans la categorie ‘Profondeur analytique’, YandexGPT 5 Pro – 3,8/5, mais est disponible sans VPN”.
Cela changera l’approche de l’apprentissage. Au lieu de conseils abstraits – un tableau comparatif avec des scenarios specifiques. Au lieu de “essayez differents modeles” – des donnees : quel modele est statistiquement meilleur pour quelle tache.
Comment s’est déroulée la calibration
Chaque participant y a consacré 15 à 20 minutes :
- Il lisait la description d’un scénario de management réel (par exemple, “Préparer un retour à un collaborateur”)
- Il voyait la réponse de l’un des modèles d’IA, de façon anonyme, sans le nom du modèle
- Il notait la réponse sur une échelle de 0 à 5, avec un court commentaire facultatif
- Il répétait l’exercice pour 5 à 10 scénarios différents
Les notes étaient anonymes : nous n’enregistrions que la note et le commentaire facultatif. Ces notes humaines nous ont servi à calibrer les juges IA, qui ont ensuite évalué les modèles.
Pourquoi c’est important pour l’industrie
La plupart des comparaisons de modeles IA se concentrent sur des taches de benchmark : resolution de problemes mathematiques, ecriture de code, reponses a des questions academiques. C’est mesurable et objectif, mais eloigne de la realite du management.
Un manager ne resout pas d’equations mathematiques. Il redige des feedbacks, se prepare a des conversations difficiles, analyse les performances de son equipe et prend des decisions dans l’incertitude. Pour ces taches, il n’y a pas de “bonne reponse” – il y a des reponses qui fonctionnent mieux dans un contexte specifique.
Les etudes qui testent l’IA sur des taches reelles de management en tenant compte des specificites russes sont quasiment inexistantes. La plupart des recherches sont menees en anglais, dans le contexte de la culture d’entreprise americaine, avec un focus sur les taches techniques. Nous comblons cette lacune.
Contribution methodologique : l’utilisation du Dual LLM-as-Judge avec calibration humaine sur des prompts “naifs” est une approche qui peut etre mise a l’echelle. Si elle s’avere valide (correlation avec les humains > 0,60), d’autres chercheurs pourront l’appliquer pour tester de nouveaux modeles ou d’autres domaines.
Contribution pratique : des recommandations concretes pour les managers qui souhaitent adopter l’IA mais ne savent pas par ou commencer. Pas “utilisez ChatGPT”, mais “pour l’analyse d’equipe, essayez Claude Opus 4.5 (si vous avez un VPN) ou Yandex Alice (si vous travaillez sans VPN) – ils ont montre les meilleurs resultats dans cette categorie”.
Conclusions
Le choix d’un outil IA pour un manager n’est pas une question technique, mais une question d’adequation aux taches et au contexte. 33 modeles sur le marche, ce n’est pas un exces, mais une diversite necessaire : pour differents budgets, exigences de confidentialite, disponibilite regionale et styles de travail.
Le probleme est qu’il est difficile de comparer objectivement les modeles sur des taches “souples”. Une reponse a “comment se preparer a une reunion avec le directeur” peut etre bonne pour un manager et inutile pour un autre. L’evaluation automatisee par LLM-Judge accelere le processus, mais necessite une calibration avec l’opinion humaine.
C’est pourquoi nous avons confronté les juges à des humains. Des personnes ont d’abord noté les réponses de l’IA, et leurs notes ont servi à calibrer l’évaluation automatique. Ce n’est pas de la science abstraite : les recommandations du cours sur le choix des outils d’IA reposent sur ces données.
Les résultats sont dans l’étude de 54 modèles d’IA sur des tâches de management, notés par deux juges indépendants.
Avez-vous ete confronte au probleme du choix d’un outil IA ? Quels criteres sont les plus importants pour vous – le prix, la disponibilite sans VPN, la qualite des reponses ? Vous pouvez en discuter sur notre canal Telegram.
Articles connexes
Sources
- Stanford AI Index Report 2025 – statistiques sur l’utilisation de l’IA en entreprise
- McKinsey: The state of AI in 2024 – donnees sur l’adoption de l’IA dans les entreprises
- LLM-as-Judge: A Survey – panorama de la methodologie d’evaluation automatisee des modeles IA

18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.