GenAI tööriistade võrdlus 2026: millise tehisintellekti peaks juht valima?
Selles artiklis mainitud AI-mudelid
- aasta septembriks on generatiivse tehisintellekti turul kümneid tööriistu. Iga tootja nimetab end liidriks ja turundus läheb iga väljalaskega valjemaks. Kuidas valida juhina tööriist, mis päriselt tööd ära teeb?
Selles artiklis on koos peamiste GenAI-tööriistade olulisemad omadused, mida oleme oma ülevaatesarjas põhjalikult käsitlenud: koondtabelid, soovitused kasutusolukordade kaupa ja praktilised nõuanded valiku tegemiseks.
Selle lehe juuli- ja septembriversiooni vahel vahetus peaaegu iga tabelis olnud lipulaev. OpenAI, Anthropic, Google, xAI, Alibaba ja Z.ai tõid kuue nädalaga välja uued tippmudelid. Allpool on kirjas, mis neist muudab juhi otsust ja mis jääb pressiteadetesse.
Mudelivalik 6. septembri 2026 seisuga
| Tootja | Praegune lipulaev | Väljalaske kuupäev | Mis oli selle artikli juuliversioonis |
|---|---|---|---|
| OpenAI | GPT-6 Astra | 3. september | GPT-5.6 Sol |
| Anthropic | Claude Fable 5.1, igapäevane töömudel – Opus 5 | 1. september ja 24. juuli | Opus 4.6 / 4.8 |
| Gemini 3.8 Flash; tippmudelit pole | 2. september | Gemini 3.1 Pro | |
| xAI | Grok 4.6 | 12. august | Grok 4.5 |
| Alibaba | Qwen3.8-Max | 3. august | Qwen 3.6 Plus / 3.7 Max |
| Z.ai | GLM-5.3 ja GLM-5.3-Flash | 14. ja 26. august | GLM-5.1 / 5.2 |
| DeepSeek | V4-Pro, nüüd GA staatuses | 13. august | V4-Pro / V4-Flash |
| Moonshot | Kimi K3 | 16. juuli | muutusteta |
| Sber | GigaChat 3.5 Ultra, nüüd MIT-litsentsiga | juuli | muutusteta |
| Yandex | Alice AI, YandexGPT 5.1 Pro | 28. juuli | muutusteta |
Ükski pärast 16. juulit välja tulnud mudel ei ole veel meie võrdlustestis. Kõik, mis allpool on öeldud GPT-6 Astra, Claude Fable 5.1 ja Opus 5, Gemini 3.8 Flashi, Grok 4.6, Qwen3.8 ja GLM-5.3 kohta, põhineb tootjate andmetel ja kahel sõltumatul platvormil – Artificial Analysis ja LMArena. Meie enda võrdlustesti tulemused kirjeldavad juulikuist mudelivalikut ja märgime selle igal pool ära.
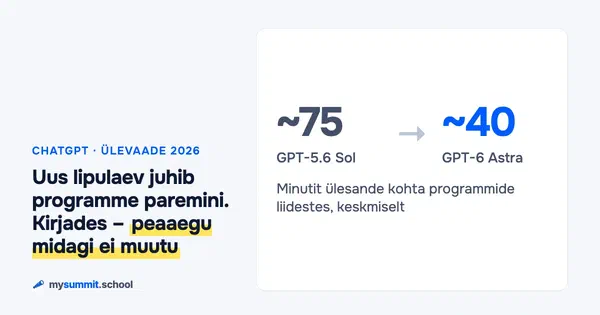
Märtsiversioonis olnud ajaloolise ülevaate GPT-5.4 kohta võtsime välja: poole aastaga asendas selle GPT-5.6 Sol ja nüüd Astra. Tollest väljalaskest jäi alles üks tagajärg – arvuti juhtimine ei ole enam haruldus. Astra arendab just seda edasi: OSWorld V2-Offline’is saab mudel OpenAI andmetel 72,6% (GPT-5.6 Solil 65,7%) ja kulutab ülesandele umbes 40 minutit 75 asemel. Koodis on edasiminek tagasihoidlikum – DeepSWE v1.1 testis 74,1% vs. 72,7%.
mysummit.school’i võrdlustesti tulemused (juuli 2026)
Pärast artikli esmaavaldamist viisime meie, haridusplatvorm mysummit.school, läbi sõltumatu võrdlustesti 47 mudeliga. Mudelid lahendasid päris juhtimisülesandeid ja vastuseid hindasid kaks kohtunikumudelit – Claude Opus 4.6 ja Gemini 3.1 Pro. Metoodika ja skaala on kirjeldatud võrdlustesti lehel.
Piir on lihtne: need tulemused on meie omad ja käivad mudelite kohta, mida me testisime. Kõike, mida tootjad on pärast 16. juulit välja lasknud, seal ei ole – need lisanduvad alles järgmise testiringi järel.
Peamised leiud:
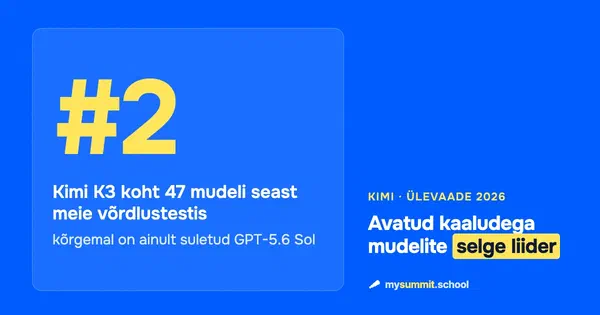
- Tipus on OpenAI GPT-5.6 Sol ja Moonshoti Kimi K3 – juulikuise testiringi esimene ja teine koht. Kimi K3 on edetabeli tugevaim mitte-USA mudel.
- Hiina mudelid on esikümnes. Lisaks Kimi K3-le on seal MiniMax M3 ja Xiaomi MiMo v2.5 Pro. Kõik kolm on 5–10 korda odavamad kui nende lääne analoogid.
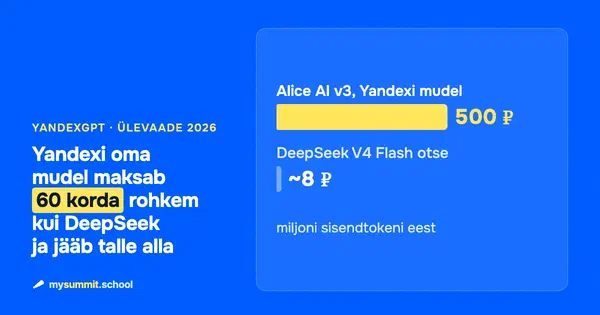
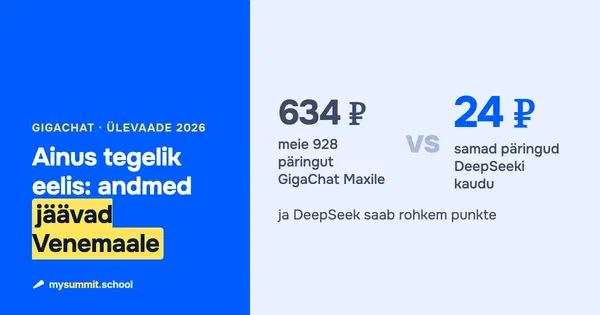
- DeepSeek V4 Flash Yandex Cloudis, ehk Venemaa pilves majutatud versioon, on originaalist 28–33 korda kallim ja pisut nõrgem.
- Sberi uusim mudel GigaChat 3.5 Ultra on GigaChat 2 Maxiga võrreldes märgatavalt paranenud, kuid hinnalt jõudis see GPT-4 tasemele ja liidritest on see endiselt kaugel.
- Grok 4.5 sulgeb esikümne ja on jätkuvalt üks parimaid meeskonna juhtimises.
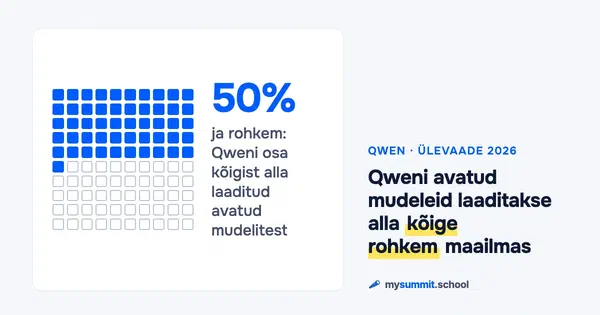
- Qwenil on 30 parema hulgas viis mudelit. Qwen 3.6 Plus pakub parimat hinna ja kvaliteedi suhet.
Iga tööriista üksikasjalikud tulemused leiate sarja uuendatud artiklitest allpool.
Mis sisuliselt muutus
Seitse suundumust, mis läbivad kõiki tootjaid. Neid tasub meeles pidada enne, kui ühtki tabelit avate.
Odav mudel on nüüd sageli parim
Gemini 3.8 Flash maksab 0,75 $ miljoni sisendtokeni ja 3,75 $ miljoni väljundtokeni eest – see on Google’i tutvustushind. Artificial Analysise indeksis saab see 47 punkti, sama palju kui Qwen3.8-Max hinnaga 2 $/6 $, ja viis punkti rohkem kui DeepSeek V4-Pro. LMArena tekstitabelis on see kaheksas.
Kaks reservatsiooni muudavad arvutust. Tutvustushind kehtib 31. detsembrini 2026 ja tavahinda pole Google avaldanud. Ning Google ise hoiatab, et päringu tegelik hind tuleb hinnakirjast umbes 40% kõrgem, sest mudel toodab rohkem väljundtokeneid ja teeb rohkem agendisamme.
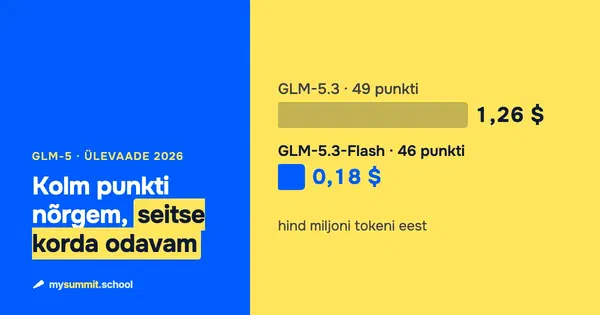
GLM-5.3-Flash maksab 0,15 $/0,50 $, täismahus GLM-5.3 aga 1,40 $/4,40 $. Artificial Analysise indeksis jääb Flash sellest kolme punktiga maha – 46 vs. 49 –, kusjuures kombineeritud hinnas on vahe seitsmekordne. Z.ai avaldab ka oma võrdlused eelmise põlvkonnaga: DeepSWE v1.1 testis on Flashil 63,4 vs. 46,2 ja AutomationBenchis 48,8 vs. 26,2. Kolm indeksipunkti seitsmekordse kokkuhoiu eest on tehing, mida arvutatakse konkreetse ülesande jaoks, mitte ei võeta usu peale.
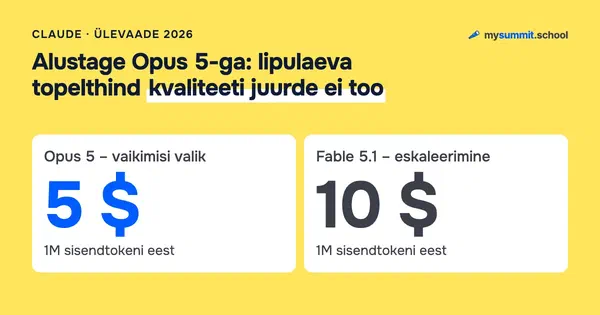
Anthropic on oma mudelivaliku üles ehitanud sama põhimõtte järgi. Opus 5 hinnaga 5 $/25 $ jääb Anthropicu andmetel CursorBench 3.2 testis Fable 5 tipptulemusest 0,5% kaugusele, kuid ülesande hind on poole väiksem. Fable 5.1 hinnaga 10 $/50 $ on eskalatsioon tõeliselt raskete ülesannete jaoks, mitte igapäevane töörežiim.
- aasta septembris on tippmudeli vaikimisi ostmine sagedamini viga kui õige otsus.
Hinnalävi arvutab ümber kogu päringu
GPT-6 Astra OpenAI hinnakirja järgi: 10 $ sisend ja 50 $ väljund miljoni tokeni eest seni, kuni sisend jääb alla 272 000 tokeni. Sealt edasi kahekordistub sisendi hind 20 dollarini, väljundi oma tõuseb 75 dollarini ning ümber arvutatakse kogu päring, mitte ainult piiri ületavad tokenid. Üksainus pikk dokument kontekstis muudab kogu pöördumise hinda.
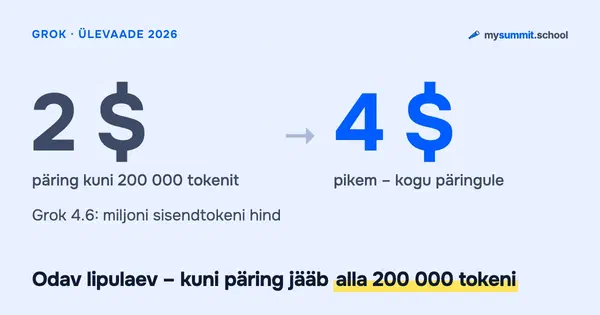
Grok 4.6 toimib samamoodi, lävi on madalamal, 200 000 juures: 2 $/6 $ muutuvad 4 $/12 $-ks.
DeepSeek V4-Pro arveldab alates 16. augustist tipp- ja väljaspool tipptunde ajavahemike järgi; tipptunnid on 01:00–04:00 ja 06:00–10:00 UTC ning väljaspool neid on hind poole väiksem. Samal ajal tõusid vahemälutabamuste hinnad esialgsete eelversiooni hindadega võrreldes rohkem kui suurusjärgu võrra – DeepSeeki ametliku muudatuslogi järgi kuni 1100%. Kõige odavam – jah. Agressiivselt odav – enam mitte.
Ükski neist mehhanismidest ei paista hinnalehelt nii, nagu finantsosakond selle kuu lõpus arvel näeb.
Kiirus on muutuja, mida keegi ei võrdle
Artificial Analysis mõõdab väljundi kiirust tokenites sekundis. Gemini 3.8 Flashil on see 334. Ülejäänud üheksal esikümne mudelil 40 kuni 87; kõige aeglasemad on Qwen3.8-Max ja Kimi K3, vastavalt 40 ja 42.
Latentsust slaidile ei panda, kuid seda tunneb igaüks, kes ootab vastust kauem kui paar sekundit. Kus mudel töötab kasutaja liideses – klienditugi, dokumendi läbitöötamine, kirja mustand –, seal on neljakordne kiirusevahe märgatavam kui kolm indeksipunkti.
„Avatud kaalud“ tähendab nüüd nelja eri asja
| Mis on kirjas | Mida see annab | Näited septembri mudelivalikust |
|---|---|---|
| MIT | Kaaludega võib teha mida tahes, tingimusteta | GLM-5.3-Flash, GigaChat 3.5 Ultra, DeepSeek V4-Pro |
| Apache 2.0 | Sama, lisaks selgesõnaline patendiklausel | Qwen3.8-27B, kogu Qwen 3.5 perekond |
| Oma litsents käibeläviga | Lävest allpool vaba, üle selle leping tootjaga | Qwen3.8-Max (lävi 50 mln $ TI-teenuste tulu), Kimi K3 (20 mln $) |
| Suletud kaalud | Ainult API või tellimus | OpenAI, Anthropic, Google, xAI, Yandex, Meta |
See veerg on kasulikum kui ükski võrdlustesti veerg. Mudeli hinne arvutatakse kuue nädala pärast ümber, litsentsi teksti muudavad tootjad harvem ja teatavad sellest ette.
Eraldi Qwen3.8-Maxi kohta: Alibaba lubas esimest korda avada Max-mudeli, kuid litsents on teadaolevalt oma, ja üle 50 mln $ käive on tingimus läbirääkimisteks. Kontrollige see üle enne, kui panete oma serveris majutamise plaani.
Oma serveris majutamine ei ole enam kompromiss
Qwen3.8-27B on 27–28 miljardi parameetriga tihe mudel nägemiskodeerijaga, kontekstiga 262 000 tokenit ja Apache 2.0 litsentsiga. Q4_K_M kvantimisega on see umbes 17 GB: mahub ühele RTX 4090 taseme tarbijagraafikakaardile või 16 GB mäluga sülearvutisse Ollama ja llama.cpp abil.
MIT-litsentsiga GLM-5.3-Flash vajab FP8-s umbes 306 GiB ning NVIDIA Hopperit või uuemat. See on juba keskmise ja suure ettevõtte mastaap, kuid litsentsis pole tingimusi üldse.
GigaChat 3.5 Ultra on 432B MoE, samuti MIT-litsentsiga. Qwen3.8-Max kaalub FP8-s umbes 2,5 TB ja jääb andmekeskuse lahenduseks.
Andmete asukohanõuetega ettevõttele on see päriselt uus valikute kogum: veel juulis tähendas vastus „hoiame majas“ seda, et tuli valida pilvemudelitest selgelt nõrgem mudel.
Nägemisvõime saabus ebaühtlaselt
OpenRouteri kaardi järgi võtab Qwen3.8-Max vastu teksti, pilte ja videot. LMArena nägemistabel paneb qwen3.8-max kolmandale kohale tulemusega 1300±8 – sõltumatu kinnitus, et multimodaalsus on päris, vastupidiselt ühele teisesele allikale, mis nimetas Max-taset puhtalt tekstimudeliks.
GLM-5.3-Flash on GLM-5 sarja esimene loomult multimodaalne mudel: tekst, pilt, video, failid.
Selle sünnilugu on õpetlik. 29. juunil küsis Zhipu asutaja Jie Tang kogukonnalt, mis peaks järgmises GLM-is olema. Enam kui 1400 vastusest domineeris nägemisvõime – arendajad tahtsid ekraanipilte, PDF-e, makette ja veateateid läbi töötada ilma vahepealse mudelita. GLM-5.3 tuli välja 14. augustil ilma nägemisvõimeta. See ilmus kaksteist päeva hiljem, teises tooteliinis.
DeepSeek vastas 21. augustil mudeliga deepseek-v4-flash-vision-exp: pildid ja ekraanipildid, staatilised või kaadrijadana, kuid päris videot mitte; hinnastus käib V4-Flashi hindade järgi ja Chartography testis saab see 64,3. Järelliide -exp on siin sisuline, mitte dekoratiivne – sellele toodangut ehitada on vara.
Google tegi teisiti. Alates 1. septembrist toetavad 3.7 Flash, 3.6 Flash ja 3.5 Flash-Lite agentset videomõistmist: mudel liigub salvestuses ringi ja võtab vajaduse järgi välja just need transkriptsioonid, kaadrid ja heli, mida vaja, selle asemel et kõik korraga alla neelata. Pikkade salvestuste puhul tähendab see kuni 88% vähem tokeneid – otsene eelarverida igaühele, kes töötleb kõnesalvestusi või koolitusvideoid.
Nende lugude ümber planeerides kehtib üks reegel: toetuda saab sellele, mis on juba välja tulnud.
Google’il pole tippmudelit
Neli Flashi väljalaset 106 päevaga – 3.5 Flash-Lite, 3.6, 3.7 ja 3.8 Flash, mai lõpust 2. septembrini. Gemini 3.5 Pro lubas Sundar Pichai juunis; praegune staatus on „tuleb varsti“. WSJ teatel ei edestanud sisemised lipulaevakandidaadid Flashi piisavalt, et väljalaset õigustada.
Hanke jaoks tähendab see üht: kui vajate tipptaseme mudelit, ei ole Google’il praegu midagi müüa.
On ka operatiivne pool. 21. juulil kuulutas Google parameetrid temperature, top_p ja top_k aegunuks – muutis seadeid keset väljalasete voogu. 3.6 Flashi jaoks häälestatud promptide toimimine 3.8 Flashil ei ole garanteeritud ning neli mudelivahetust 106 päevaga on omaette kulurida regressioonitestimisele.
Sõltumatud platvormid
Kaks platvormi testivad kõiki samadel tingimustel. Kui artikkel mudeleid võrdleb, tuleb toetuda neile, mitte väljakuulutuste numbritele.
Artificial Analysis, andmed 6. septembri 2026 seisuga
| Mudel | Tootja | Intellektiindeks | Kombineeritud hind, $/1M | Väljund, tok/s |
|---|---|---|---|---|
| Claude Fable 5.1 (max, w/ fallback) | Anthropic | 57 | 6,12 $ | 70 |
| GPT-6 Astra (max) | OpenAI | 55 | 2,57 $ | 71 |
| Claude Opus 5 (max) | Anthropic | 54 | 4,21 $ | 58 |
| Muse Spark 1.3 (max) | Meta | 53 | 0,96 $ | 190 |
| GPT-5.6 Sol (max) | OpenAI | 51 | 1,25 $ | 85 |
| Grok 4.6 (high) | xAI | 51 | 1,25 $ | 63 |
| Kimi K3 (max) | Moonshot | 50 | 1,58 $ | 42 |
| GLM-5.3 (max) | Z.ai | 49 | 1,26 $ | 87 |
| Gemini 3.8 Flash (high) | 47 | 0,74 $ | 334 | |
| Qwen3.8 Max | Alibaba | 47 | 1,19 $ | 40 |
| Qwen3.8-Flash-Next | Alibaba | 46 | – | – |
| GLM-5.3-Flash | Z.ai | 46 | 0,18 $ | 48 |
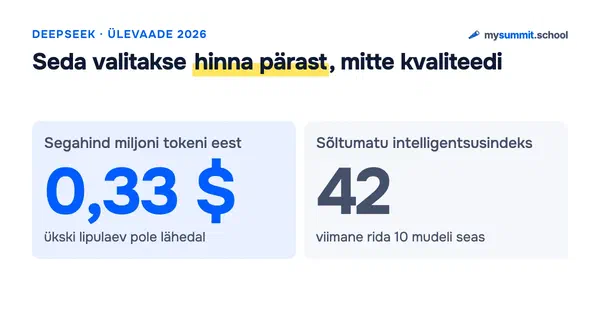
| DeepSeek V4 Pro 0813 (max) | DeepSeek | 42 | 0,33 $ | 71 |
Reservatsioon, ilma milleta on parem tabelit mitte kasutada: Artificial Analysis avaldab indeksit versioonide kaupa ja skaleerib seda versioonide vahel ümber. „60“ Z.ai väljakuulutuses ja „49“ elavas tabelis on sama mudel eri skaalal. Võrrelda saab ainult ühe hetkeseisu piires.
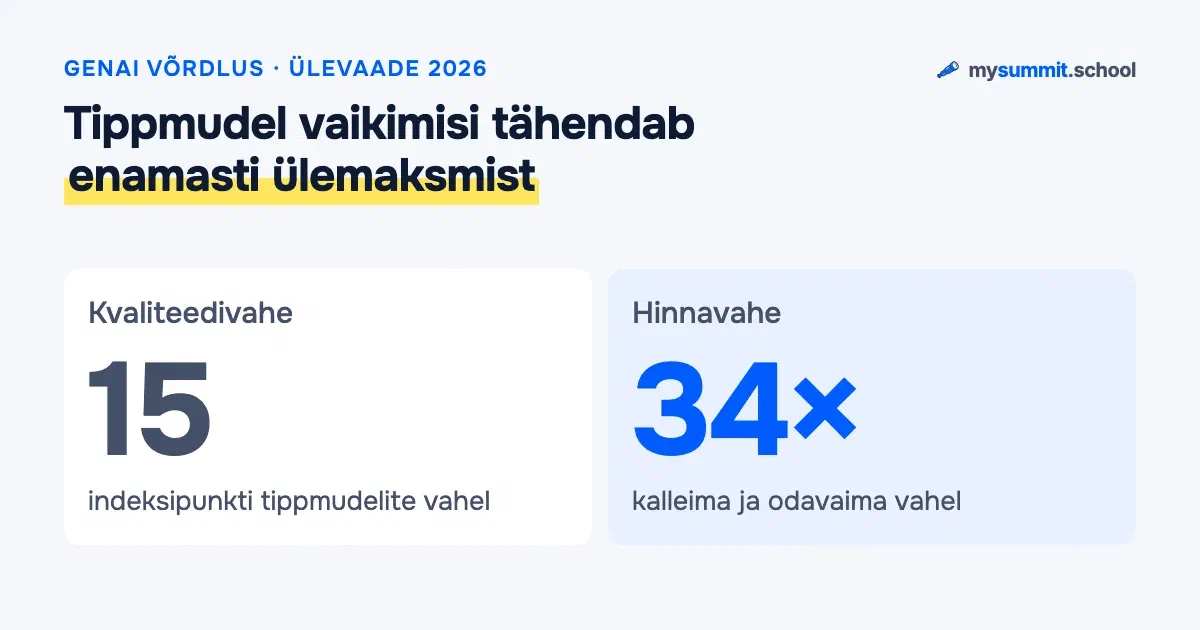
Tabeli esimese ja viimase koha vahe on 15 punkti. Hinnavahe on 34-kordne, 6,12 $ vs. 0,18 $. Nende kahe numbri vahel ongi päris otsus: kui palju on viisteist indeksipunkti väärt kolmekümnekordse ülemaksmise kõrval just teie ülesannetel.
LMArena, andmed 6. septembri 2026 seisuga
Tekst, esikümme:
| # | Mudel | Reiting |
|---|---|---|
| 1 | claude-fable-5 (Anthropic) | 1507±5 |
| 2 | claude-opus-4-6-high | 1505±4 |
| 3 | claude-fable-5.1-max | 1504±11 |
| 4 | claude-opus-4-7-high | 1502±4 |
| 5 | muse-spark-1.2 xHigh (Meta) | 1499±10 |
| 6 | claude-opus-4-6 | 1498±3 |
| 7 | claude-opus-4-7 | 1494±4 |
| 8 | gemini-3.8-flash-high (Google) | 1494±9 |
| 9 | claude-opus-5-high | 1493±5 |
| 10 | muse-spark-1.1 (Meta) | 1492±5 |
Nägemine, esikümme:
| # | Mudel | Reiting |
|---|---|---|
| 1 | claude-fable-5 | 1313±8 |
| 2 | claude-opus-4-7-high | 1301±7 |
| 3 | qwen3.8-max (Alibaba) | 1300±8 |
| 4 | claude-opus-4-7 | 1299±7 |
| 5 | claude-opus-4-6-high | 1299±7 |
| 6 | muse-spark (Meta) | 1294±9 |
| 7 | claude-opus-4-6 | 1293±7 |
| 8 | muse-spark-1.2 xHigh (Meta) | 1292±15 |
| 9 | claude-opus-5-high | 1290±8 |
| 10 | gemini-3-pro (Google) | 1289±8 |
Nende kahe tabeli numbrid on LMArenast ja meie võrdlustestiga pole neil midagi pistmist.
Kohtade 1–9 usaldusvahemikud kattuvad mõlemas tabelis. Statistiliselt on see viik ning iga tekst, mis LMArena põhjal parima mudeli välja kuulutab, loeb tabelist välja rohkem, kui see lubab. Seda mehhanismi analüüsisime lähemalt artiklis „TI võrdlustestid kaotavad mõtte“; sellest, kuidas mõõtmine ise toimib, kirjutasime artiklis „Kuidas LLM-ide kvaliteeti hinnatakse“.
Kaks tabelit lähevad lahku kõnekalt. Anthropic hoiab inimeste eelistuste järgi kümnest kohast kuut ja on samal ajal Artificial Analysise tabeli keskel. Üks tabel kontrollib vastuseid hindamisjuhendi järgi, teine küsib inimestelt, millist teksti on neil meeldivam lugeda. Need on eri suurused ja nende segiajamine on valiku tegemisel tavaline viga.
Meta püsib muse-spark perekonnaga mõlema tabeli esikümnes ning Muse Spark 1.3 on Artificial Analysises neljandal real hinnaga 0,96 $ ja kiirusega 190 tokenit sekundis – kaks korda kiirem kui kõik temast eespool. Mudelivaliku analüüs on sarja eraldi osas.
Seni oli jutt sellest, kuidas mudeleid mõõta. Mõõtmisega pole lihtne: meie võrdlustest kirjeldab juulikuist mudelivalikut, Artificial Analysis skaleerib versioonide vahel ümber ja LMArenas ei ole esimest üheksat kohta võimalik eristada. Juhi ülesanne sellest ei muutu – tal on vaja vastust, mille saab panna aruandesse või anda kliendile. Sama mudel annab kahe eri sõnastuse peale kas mustandi, mida tuleb ümber kirjutada, või tulemuse, mida ümber kirjutada ei ole vaja. Vahe „töötab“ ja „töötab usaldusväärselt“ vahel on oskus TI-le ülesandeid sõnastada.
Koondtabel: 13 tööriista võrdluses
Kolmas veerg on meie juulikuise testiringi mudel, mitte praegune lipulaev: kõike, mis tuli välja pärast 16. juulit, me veel testinud ei ole. Kohad ja punktid on allpool elavas tabelis „Hind ja tulemus“, mis uueneb iga võrdlustesti lainega.
| Tööriist | Lipulaev 6. septembri 2026 seisuga | Mudel meie võrdlustestis | Kontekst | Tellimus | Tugevus |
|---|---|---|---|---|---|
| ChatGPT | GPT-6 Astra | GPT-5.6 Sol | Astral 1M tokenit | 20–200 $/kuu | Mitmekülgsus, ökosüsteem, arvuti juhtimine |
| Claude | Fable 5.1, töömudel – Opus 5 | Opus 4.6 | 1M tokenit | 20–200 $/kuu | Teksti kvaliteet, planeerimine, brauser ja Cowork |
| Gemini | 3.8 Flash; tippmudelit pole | 3.1 Pro | 3.1 Prol 2M tokenit | 20–250 $/kuu | Google Workspace, väljundi kiirus |
| Perplexity | Mitu mudelit | ei testitud | Erinev | 20 $/kuu | Otsing koos allikatega |
| Grok | 4.6 | 4.5 | 500 000 tokenit | 8–35 $/kuu | Meeskonna juhtimine, konfliktistsenaariumid |
| YandexGPT | Alice AI, YandexGPT 5.1 Pro | Alice AI v3 | 128 000 tokenit | API kaudu | Vene keel, Yandex 360 |
| GigaChat | 3.5 Ultra | 3.5 Ultra | – | API kaudu | Andmed Venemaal, avatud kaalud MIT-litsentsiga |
| DeepSeek | V4-Pro (GA) | V4-Pro | 1M tokenit | API kaudu | Hind, väljundi lagi ligi 400 000 tokenit |
| Qwen | Qwen3.8-Max | 3.6 Plus | Qwen3.8-Maxil 1M tokenit | API kaudu | 5 mudelit 30 parema seas, avatud kaalud |
| GLM-5 (Z.ai) | GLM-5.3 ja GLM-5.3-Flash | GLM-5.2 | 1M tokenit | API kaudu | Flashil MIT-kaalud, multimodaalsus |
| Kimi | K3 | K3 | 1M tokenit | 19–199 $/kuu | Meie võrdlustesti tugevaim mitte-USA mudel |
| MiMo (Xiaomi) | v2.5 Pro | v2.5 Pro | – | API kaudu | Esikümne tulemus murdosa eest lääne hinnast |
| MiniMax | M3 | M3 | – | API kaudu | Esikümne tulemus madala hinnaga |
Meta muse-spark perekond sellesse tabelisse ei jõudnud, sest meie võrdlustestis seda ei ole. Analüüs on Muse Sparki mudelivaliku ülevaates, sõltumatute platvormide andmed on toodud eespool.
Septembri väljalasete hinnad
Numbrid on tootjate hinnakirjadest, meie võrdlustestis neid mudeleid ei ole.
| Mudel | Sisend, $/1M | Väljund, $/1M | Mida on oluline teada |
|---|---|---|---|
| GPT-6 Astra | 10 $ | 50 $ | Üle 272 000 sisendtokeni – 20 $ ja 75 $ kogu päringule |
| Claude Fable 5.1 | 10 $ | 50 $ | Vahemälu lugemine 0,25 $, 75% odavam kui Fable 5-l |
| Claude Opus 5 | 5 $ | 25 $ | Poole odavam kui Fable 5.1 |
| Grok 4.6 | 2 $ | 6 $ | Üle 200 000 – 4 $ ja 12 $ |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | Tutvustushind kuni 31. detsembrini 2026, tavahinda pole välja kuulutatud |
| Qwen3.8-Max | 2 $ | 6 $ | Vahemälu lugemine 0,25 $ |
| Qwen3.8-Flash-Next | 0,16 $ | 0,47 $ | Qwen4 arhitektuuri eelvaade, kontekst kuni 1M YaRN-i abil |
| GLM-5.3 | 1,40 $ | 4,40 $ | Hind on eelmise põlvkonnaga võrreldes sama |
| GLM-5.3-Flash | 0,15 $ | 0,50 $ | Kampaania 9. septembrini – 0,075 $/0,25 $ |
OpenAI Batch ja Flex on poole odavamad, kiirrežiim kaks korda kallim kahekordse kiiruse eest. GPT-6 Astral on veel üks juurdepääsu eripära: see on esimene mudel, mis ületas OpenAI Preparedness Frameworkis kriitilise küberturbe läve. Tavaline API keeldub haavatavuste otsimise ülesannetest, täielik juurdepääs on ainult programmidel Trusted Access ja Daybreak ning tavakasutajad võivad OpenAI hoiatuse järgi kohata aeglustusi ja blokeeringuid.
Võrdlus hinna järgi
| # | Mudel | Punktid | Hind /1M (sisend/väljund) | Testi kohta | Venemaalt |
|---|---|---|---|---|---|
| 16 | Kimi K3 | 7,4 | $3.00/$15.00 | $0.219 | VPN-ita |
| 3 | GPT-5.6 Sol | 8,0 | $5.00/$30.00 | $0.190 | vajab VPN-i |
| 26 | Claude Opus 4.6 | 6,8 | $5.00/$25.00 | $0.216 | vajab VPN-i |
| 41 | MiniMax M3 | 6,2 | $0.30/$1.20 | $0.010 | VPN-ita |
| 39 | MiMo v2.5 Pro | 6,2 | $1.00/$3.00 | $0.027 | VPN-ita |
| 24 | Grok 4.5 | 6,9 | $2.00/$6.00 | $0.028 | vajab VPN-i |
| 40 | Kimi K2.6 | 6,2 | $0.74/$3.49 | $0.036 | VPN-ita |
| 44 | Qwen 3.6 Plus | 6,1 | $0.33/$1.95 | $0.011 | VPN-ita |
| 45 | DeepSeek V4 Pro | 6,0 | $0.43/$0.87 | $0.005 | VPN-ita |
| 58 | DeepSeek V4 Flash | 5,6 | $0.09/$0.18 | $0.001 | VPN-ita |
| 56 | DeepSeek V4 Flash (Yandex Cloud) | 5,6 | $3.00/$5.00 | $0.023 | VPN-ita |
| 71 | GigaChat 3.5 Ultra | 5,1 | $1.07/$3.21 | $0.011 | VPN-ita |
| 65 | Alice AI LLM (v3) | 5,4 | $4.10/$9.84 | $0.020 | VPN-ita |
| 74 | GigaChat 2 Max | 4,5 | $7.22/$7.22 | $0.013 | VPN-ita |
| 46 | Gemini 3.1 Pro | 6,0 | $2.00/$12.00 | $0.027 | vajab VPN-i |
Mudeleid võrdlustestis: 74, andmed seisuga 2026-11-20 · Kogu edetabel →
Tasuta tasemed, mida tabel ei näita: Kimil piiramatu vestlus, Qwenil ja DeepSeekil täielik tasuta juurdepääs, GigaChatil veebiliides, Alice AI-l Alice ja Yandex Browser ning Grok X Premiumi tellimuse kaudu.
Testi hind on ühe võrdlustesti stsenaariumi keskmine maksumus (süsteemiprompt + ülesanne + mudeli vastus, keskmiselt umbes 2000 sisend- ja 1500 väljundtokenit). Vaadake ka võrdlustesti metoodikat.
DeepSeek V4 Flash Yandex Cloudis on 23 korda kallim kui originaal ja veidi nõrgema kvaliteediga – vt ülal veergu „Testi hind“. Maksate selle eest, et andmed jäävad Venemaale, ja Yandexi SLA eest.
Millist tööriista valida: 7 olukorda
1. Universaalne abiline igapäevatööks
ChatGPT-l on kõige laiem ökosüsteem: teksti loomine, pildid, andmeanalüüs, failidega töö, integratsioonid GPT Store’i kaudu. GPT-6 Astraga nihkus rõhk arvuti juhtimisele: kontekst veidi üle 1M tokeni, sisend tekstina ja pildina, väljund ainult tekstina, heli mudel vastu ei võta. Anthropic pakub oma mudelivalikus selgemat valikut: Opus 5 hinnaga 5 $/25 $ enamiku ülesannete jaoks, Fable 5.1 hinnaga 10 $/50 $ raskete jaoks ning alati sisse lülitatud kohanduv mõtlemine (adaptive thinking), mida ei pea enam käsitsi lülitama.
Anthropicu tootepool on septembris huvitavam kui mudelipool. Claude Chrome’is on kõigil tasulistel pakettidel üldkasutuses, Cowork sai sisseehitatud brauseri ja mälu on nüüd vestluse ja Coworki vahel ühine. Ettevõttes juurutamisel tuleb üks detail eelnevalt otsustada: Team- ja Enterprise-pakettidel on mälu vaikimisi välja lülitatud.
2. Uurimistöö ja faktikontroll
Tööriist, mis otsib infot internetist ja näitab linke allikatele. Deep Research režiim on keerukate küsimuste jaoks.
3. Töö Google’i ökosüsteemis
Kui teie ettevõte kasutab Google Workspace’i, on Gemini integreeritud Gmaili, Docsi, Sheetsi ja Drive’i. 3.8 Flash lisati Gemini rakendusse Pro- ja Ultra-pakettidel, otsingu AI Mode’i ja Google Sheetsi. 2 miljoni tokeni suurune kontekstiaken on Gemini 3.1 Prol – just see mudel võimaldab analüüsida hiiglaslikke dokumente.
Hankeplaani jaoks kaks asjaolu. Google’il pole praegu tippmudelit, nii et kui ülesanne nõuab maksimumi, pole valida midagi. 3.8 Flashi tutvustushind kehtib 31. detsembrini 2026 ja tavahinda pole avaldatud – tutvustushinna 0,75 $ eelarvesse panemine on riskantne.
4. Venekeelne töö ja andmete hoidmine Venemaal
See olukord puudutab teid ainult siis, kui tegutsete Venemaal või töötate venekeelse sisuga: GigaChat (Sber) ja YandexGPT on seal kaks peamist kodumaist mudelit ning mõlemad hoiavad andmeid Venemaal. GigaChat 3.5 Ultra on meie juulikuise võrdlustesti parim Venemaa mudel, kuid tööõigusega ei tule usaldusväärselt toime ükski mudel (ka lääne omad mitte). YandexGPT on integreeritud Yandexi ökosüsteemiga (Yandex 360, Browser, Alice). Alternatiiv on DeepSeek V4 Flash Yandex Cloudis: juulikuises testiringis edestab see Alice AI-d ja hoiab andmeid Venemaal, kuid on originaalist 28–33 korda kallim.
Suve jooksul muutus siin kaks asja. Sber andis välja GigaChat 3.5 Ultra MIT-litsentsiga – 432B MoE lineaarse tähelepanuga, eelmisest lipulaevast peaaegu poole kompaktsem ja pikkadel tekstidel kuni neli korda kiirem. Meie juulikuiste mõõtmiste järgi on see liidritest kaugel, kuid võimalus seda oma serveris käitada muudab arvutust. Yandex käivitas Alice’i uuesti uuel suletud kaaludega Alice AI LLM-il ja uuendas YandexGPT 5.1 Pro’t. Yandexi andmetel kasvas heade vastuste osakaal 60%-lt 71%-le ja hallutsinatsioonid vähenesid poole võrra, 16%-le. Hind langes kolm korda. Kogu Alice AI mudelivalik – LLM, ART ja VLM – on alates 16. juulist sertifitseeritud standardi ISO/IEC 42001 järgi.
5. Minimaalne eelarve
DeepSeek V4 Flash on 130 korda odavam kui Gemini 3.1 Pro ja seejuures kvaliteetsem. Qwen 3.7 Plus on „planeerimine peaaegu tasuta“. Testihinnad on ülal elavas tabelis.
Neile lisandus kaks väljalaset, mida meie võrdlustestis ei ole. Qwen3.8-Flash-Next on Qwen4 arhitektuuri avatud eelvaade: 125B parameetrit, millest tokeni kohta on aktiivsed 6B. Kontekst 262 000 tokenit laieneb YaRN-i abil 1M-ni, hind on umbes 0,16 $/0,47 $. 51 miljardi parameetriga n-grammi manustuste kiht elab tavalises operatiivmälus, mitte videomälus. Alibaba andmetel edestab see enamikus testitud ülesannetes DeepSeek-V4-Flashi ja Claude Opus 4.6-t. GLM-5.3-Flash hinnaga 0,15 $/0,50 $ lisab sellele multimodaalsuse ja MIT-litsentsi.
DeepSeeki puhul üks reservatsioon: hinnatõus, tipptundide aknad ja kallim vahemälu tähendavad, et „agressiivselt odav“ on läbi. Odav on alles.
6. Andmete konfidentsiaalsus
Qwen – ja nüüd on see sisuline vastus.
Qwen3.8-27B: Apache 2.0, nägemiskodeerija, loomulik pildi- ja videotugi, kontekst 262 000 tokenit, Q4_K_M kujul umbes 17 GB. Üks tarbijagraafikakaart või 16 GB mäluga sülearvuti Ollama ja llama.cpp abil. Veel juulis olid sel kohal eelmise põlvkonna avatud mudelid – kasutatavad, kuid pilvemudelitest selgelt nõrgemad; nüüd on see mudel, mille võib rahulikult meeskonnale kasutada anda.
Kõrval on kaks suuremat varianti. GLM-5.3-Flash MIT-litsentsiga, FP8-s umbes 306 GiB, NVIDIA Hopper või uuem – ainus sellel tasemel multimodaalne mudel, mida saab seaduslikult oma riistvarale paigaldada ilma litsentsitingimusteta. GigaChat 3.5 Ultra MIT-litsentsiga, kui on oluline, et mudel on arendatud Venemaa jurisdiktsioonis.
Qwen3.8-Max on formaalselt samuti lubatud avatud kaaludega, kuid praktikas tähendab see FP8-s umbes 2,5 TB, andmekeskust ja käibeläviga litsentsi. Enamikule ettevõtetest ei ole see oma serveris majutamise variant.
7. Meediasisu loomine
ChatGPT koos spetsiaalsete tööriistadega.
GPT-6 Astra ise heli vastu ei võta ega pilte ei loo – piltide genereerimine on ühendatud tööriistana. Suve jooksul kasvas lipulaevade ümber eraldi kiht: Gemini Omni Flash loob ja monteerib videot 360p-st 4K-ni, Lyria 3.5 kirjutab täispikki lugusid, Gemini 3.5 Transcribe tunneb kõnet ära enam kui 85 keeles, eristab kõnelejaid ja paneb täpsed sõnade ajatemplid ning grok-imagine-video-1.5 annab natiivset 1080p videot.
Üksikasjalik ülevaade TI-tööriistadest piltide, video, muusika ja esitluste loomiseks on sarja eraldi artiklis.
Kuidas mudeleid objektiivselt võrrelda
Turundusväited ei ole parim valikukriteerium. Kasutage sõltumatuid võrdlusteste:
- mysummit.school’i võrdlustest – 47 mudelit päris juhtimisülesannetel, kaks sõltumatut kohtunikumudelit
- Artificial Analysis – ühtne skaala intellekti, kombineeritud hinna ja väljundi kiiruse jaoks; pidage meeles ümberskaleerimist indeksi versioonide vahel
- LMArena – mudelite anonüümne pimevõrdlus päris inimeste poolt; esimese üheksa koha usaldusvahemikud kattuvad
- SWE-bench – mudeli agendivõimekuse hindamiseks
Kõige parem on aga testida kaht-kolme finalisti oma päris tööülesannetel.
Praktiline nõuanne: strateegia „põhitööriist + varu“
Ärge siduge end ühe tööriistaga. Optimaalne strateegia:
- Põhitööriist – 80% igapäevastest ülesannetest (ChatGPT, Claude või Gemini). Võrdlustesti järgi Claude Opus 4.6 või Grok 4.5 ning murdosa hinna eest Kimi K3 ja MiMo v2.5 Pro.
- Varu – juhuks, kui põhitööriist ei saa hakkama või pole kättesaadav. DeepSeek V4 Flash ja Qwen 3.7 Plus on tasuta.
- Eritööriist – konkreetsete ülesannete jaoks: Perplexity uurimistööks, GigaChat 3.5 Ultra andmetele, mis peavad jääma Venemaale, Qwen konfidentsiaalsetele andmetele teie enda serveris.
Selline lähenemine annab varu ja võimaldab kasutada iga tööriista tugevusi.
Kui sama loogika septembri mudelivalikule üle kanda, saame: põhitööriistaks GPT-6 Astra või Claude Fable 5.1, töömudeliks poole odavam Claude Opus 5 ning varuks GLM-5.3-Flash või Qwen3.8-Flash-Next, mida saab ka ise majutada. Gemini 3.8 Flash väärib eraldi rida – ülesanneteks, kus vastuse kiirus on olulisem kui viimased kolm kvaliteedipunkti.
Selle artikli alguses olev tabel vananes kuue nädalaga ja järgmine vananeb umbes sama kiiresti: Google lubab Gemini 3.5 Pro’t, xAI treenib Grok 5-t, Z.ai hoiab GLM-5.3 kaalusid väljalaskejärgsel turvakontrollil. Sellistes tabelites muutuvad kõige kiiremini hinded. Litsentsiveerg muutub kõige aeglasemalt ja 2026. aasta septembris tasub lugeda esmalt just seda: GLM-5.3-Flashi MIT ja Qwen3.8-27B Apache 2.0 elavad üle nii järgmise väljalaske kui ka järgmise skaala ümberarvutuse.
Selle sarja teised osad
 Osa 1
ChatGPT 2026. aastal: mis on muutunud ja kust juhil alustada
 Osa 2
Anthropicu Claude 2026. aastal: Opus 5, Fable 5.1, Mythos 5.1, Cowork ja Chrome – ülevaade juhtidele
 Osa 3
Perplexity AI 2026: nutika otsingumootori ülevaade juhtidele
 Osa 4
Google Gemini 2026. aastal: mudelid, NotebookLM ja Workspace'i integratsioon
 Osa 5
SpaceXAI Grok 2026. aastal: Elon Muski tehisintellekti ülevaade
 Osa 6
YandexGPT 2026. aastal: Yandexi Venemaa tehisintellekti ülevaade ettevõtetele
 Osa 7
DeepSeek 2026: V4-Pro ja V4-Flash pärast hinnatõusu
 Osa 8
GigaChat 2026. aastal: aus ülevaade – kas tasub tööks kasutada?
 Osa 9
Alibaba Qwen 2026. aastal: avatud kaalud jõudsid tagasi lipulaevadesse
 Osa 10
Kuidas hinnatakse LLM-ide kvaliteeti 2026. aastal: juhend AI-mudelite võrdlusuuringutele juhtidele
 Osa 11
Tehisintellekt meediasisu loomiseks 2026. aastal: pildid, video, muusika ja esitlused
 Osa 13
Chat Z.AI (GLM-5) 2026: Hiina mudel, mis teeskleb end Claude'i olevat
 Osa 14
Kimi Moonshotilt 2026: K3, K2.6, K2.7-Code ja agendid juhile
 Osa 15
GigaChat tööl: kuidas Venemaa suveräänsest TI-st maksimum võtta
 Osa 16
AI-võrdlusuuringud kaotavad mõtte – kuidas siis mudelit valida
 Osa 17
Meta Muse Spark – Meta esimene suletud mudel alates 2023. aastast
 Osa 18
Microsofti MAI mudelid 2026. aastal: mida saab päriselt kasutada ja mis see maksab
 Osa 19
Kodeerimisagendid 2026: kaks vormi – terminal ja töölaud
Kõik sarja ülevaated
- OpenAI ChatGPT – universaalne ökosüsteem ja arvuti juhtimine
- Anthropicu Claude – parim teksti kvaliteet ja turvalisus
- Perplexity AI – uue põlvkonna otsingumootor
- Google’i Gemini – Workspace’i integratsioon ja neli Flashi väljalaset 106 päevaga
- xAI Grok – Elon Muski TI X-i integratsiooniga
- YandexGPT – Venemaa TI Yandexi ökosüsteemiga
- DeepSeek – agressiivse hinnaga Hiina mudel
- Sberi GigaChat – Venemaa TI ettevõtetele
- Alibaba Qwen – hinnapõrand ja avatud kaalud
- Kuidas LLM-ide kvaliteeti hinnatakse – võrdlustestid juhile
- TI meediasisu loomiseks – pildid, video, muusika
- Z.ai GLM-5 – avatud kaalude ja multimodaalsusega Hiina mudel

18 aastat insenerimeeskondade juhtimist. mysummit.school asutaja. 700+ lopetajat Yandex Practicumis ja Stratoplanis.