Qwen de Alibaba en 2026: los pesos abiertos vuelven a los modelos insignia
Modelos de IA en este artículo
Mientras los managers pagan ChatGPT Plus y Claude Pro, Alibaba ha construido uno de los ecosistemas de IA más grandes del mundo: chat gratuito, modelos abiertos y precios de API varias veces por debajo de la competencia. Qwen (se pronuncia “chuén”, de 通义千问 – “Mil preguntas”) superó a mediados de 2026 en descargas a todos sus rivales occidentales y se convirtió en una herramienta que todo manager debería conocer. En primavera parecía que el ecosistema giraba hacia el modelo de OpenAI y Anthropic: los modelos insignia de la serie 3.7 salieron cerrados y varios desarrolladores clave se marcharon. En agosto, Alibaba lanzó tres modelos y dio media vuelta. Para el modelo insignia, Qwen3.8-Max, se han prometido pesos abiertos, y Qwen3.8-27B, con licencia Apache 2.0, funciona en una sola tarjeta gráfica de consumo.
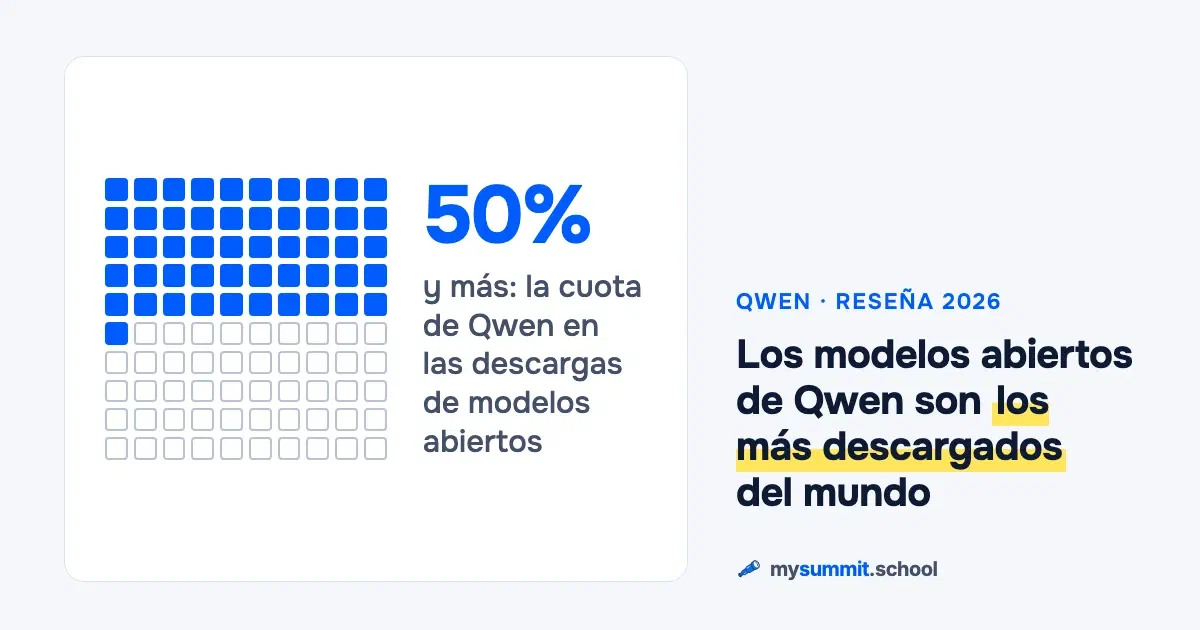
Para un manager, el atractivo de Qwen es sencillo: es un asistente de IA completo y gratuito a través de Qwen Chat, sin suscripción y sin límite de consultas. En abril de 2026, los modelos Qwen rozaban los 1.000 millones de descargas: la familia acapara más del 50% de todas las descargas de modelos abiertos del mundo. La app de consumo supera los 200 millones de usuarios activos mensuales, tercera del mundo detrás de ChatGPT y DouBao.
¿Qué hace diferente a Qwen?
Lo que separa a Qwen de la mayoría de sus competidores es la escala y la flexibilidad. Alibaba publica en abierto en Hugging Face buena parte de sus modelos: cualquier empresa puede descargarlos y desplegarlos en sus propios servidores. Uno de los proyectos construidos sobre Qwen es Oylan, el modelo de lenguaje nacional de Kazajistán. Este verano, los pesos abiertos dejaron de ser cosa de la gama media: Alibaba anunció que también publicará los de su modelo insignia, Qwen3.8-Max. La serie 3.7, en cambio, sigue cerrada y solo está disponible por API.
- La mayoría de los modelos Qwen están disponibles para descargarlos y ejecutarlos en tu propio servidor. Para empresas con requisitos estrictos de seguridad de datos, los modelos abiertos – Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen 4 Coder y toda la familia Qwen 3.5 – siguen estando entre los mejores del mundo.
- Los modelos insignia funcionan por especialización: cada consulta la atiende solo el grupo de expertos adecuado, una pequeña parte activa del modelo. En la práctica, un modelo que corre en un portátil da hoy respuestas que antes exigían hardware de servidor caro.
- Los modelos de texto de la serie Qwen3 admiten 119 idiomas y dialectos; las versiones más recientes, 201.
- Texto, imágenes, vídeo, audio y generación de voz: todo en un mismo ecosistema.
Qué sabe hacer Qwen en septiembre de 2026
La gama Qwen cubre hoy prácticamente todos los tipos de tareas con los que se encuentra una empresa:
- Un modelo insignia con pesos prometidos. Qwen3.8-Max (disponible desde el 3 de agosto de 2026) es un MoE disperso de 2,4 billones de parámetros, de los que unos 95.000 millones están activos en cada pasada. Contexto de 1 millón de tokens; acepta texto, imagen y vídeo. Precio: $2,00/$6,00 por millón de tokens.
- Despliegue local con visión. Qwen3.8-27B (13–14 de agosto): un modelo denso de 27–28.000 millones de parámetros con codificador visual, contexto de 262K, licencia Apache 2.0 y unos 17 GB en cuantización Q4_K_M. Basta una tarjeta gráfica o un portátil con 16 GB de memoria.
- Doce veces más barato. Qwen3.8-Flash-Next (26 de agosto) es una vista previa abierta de la arquitectura Qwen4: 125.000 millones de parámetros, 6.000 millones activos por token, unos $0,16/$0,47 por millón de tokens.
- Agentes de nueva generación. Qwen 3.7 Max (mayo de 2026) está diseñado como “modelo agéntico”: ejecuta de forma autónoma cadenas de más de 1.000 llamadas a herramientas en una sola sesión sin perder calidad. Contexto de 1 millón de tokens y la tasa de alucinaciones más baja entre los modelos insignia (22,9%).
- Un agente multimodal. Qwen 3.7 Plus (disponible desde el 1 de junio de 2026) entiende texto, imágenes y vídeo, ve la pantalla y devuelve las coordenadas de los elementos de la interfaz (GUI agent grounding). Contexto de 1 millón de tokens.
- Programación a otro nivel. Qwen 4 Coder 32B-A3B (2 de junio de 2026) es el primer modelo abierto que alcanza el 82% en SWE-Verified. Arquitectura MoE: 32.000 millones de parámetros, de los que solo 3.000 millones están activos. Corre en un Mac con 24 GB de memoria a 58 tokens/s. Licencia Apache 2.0.
- Documentos largos. Qwen3.6-Plus retiene hasta 1 millón de tokens, unas 2.000 páginas A4 en una sola consulta. Puedes cargar un informe anual completo, un histórico de incidencias de clientes o un repositorio de código entero y preguntar sobre todo el conjunto.
- Razonamiento complejo. Qwen3.7-Max en modo de cadena de razonamiento obtiene un 92,4% en GPQA Diamond, por encima de Claude Opus 4.6 Max (91,3%) y K2.6 Thinking (90,5%). En matemáticas (Apex Math), un 44,5% frente al 34,5% de Claude Opus 4.6 Max.
- Programación agéntica. Qwen3.6-35B-A3B funciona junto a Claude Code, Qwen Code y herramientas similares, y resuelve tareas al nivel de Claude Sonnet 4.5 por una fracción del precio. Licencia abierta: se puede desplegar dentro de la empresa.
- Voz y vídeo en un solo modelo. Qwen3.5-Omni entiende a la vez texto, imágenes, audio y vídeo dentro de una arquitectura única. Sobre él funciona el “Audio-Visual Vibe Coding”: describes la tarea de viva voz mostrando la pantalla y el modelo genera el código.
- Generación de imágenes y voz. Qwen-Image-2512 crea imágenes fotorrealistas con un renderizado preciso de texto en varias líneas, algo poco común en los modelos generativos. Qwen3-TTS sintetiza voz con clonación para locuciones y asistentes de voz.
- Tercer puesto en la tabla de visión de LMArena. Qwen3.8-Max obtiene 1.300±8 y solo tiene por delante dos modelos de Anthropic. Los intervalos de los nueve primeros se solapan: es un pelotón apretado, y las primeras posiciones se deciden dentro del margen de error.
Principales modelos de Qwen (septiembre de 2026)
En septiembre de 2026, Alibaba cuenta con una de las gamas de modelos más amplias del sector.
Qwen3.8-Max: el modelo insignia que Alibaba prometió abrir (agosto de 2026)
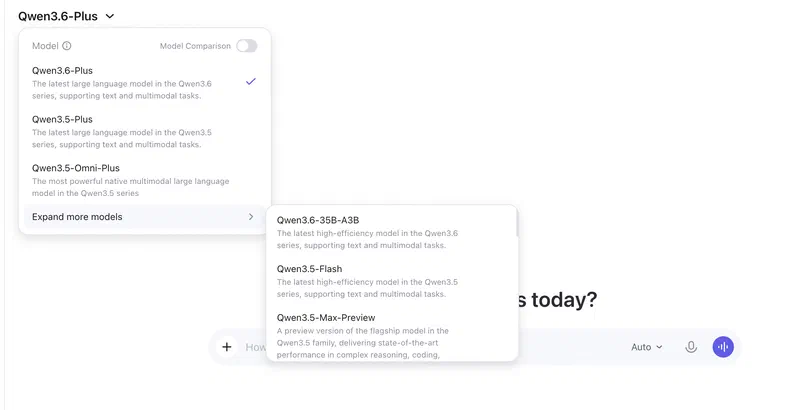
Qwen3.8-Max pasó a disponibilidad general el 3 de agosto de 2026 y el 2–3 de septiembre recibió una actualización de post-entrenamiento con la etiqueta 0902. Todavía no está en nuestro benchmark: los datos de abajo son del fabricante y de plataformas independientes.
La arquitectura es una mezcla de expertos dispersa: 2,4 billones de parámetros en total, unos 95.000 millones activos en cada pasada. Contexto de 1 millón de tokens y respuesta máxima de 131.072 tokens. Acepta texto, imagen y vídeo y devuelve texto; el razonamiento viene activado por defecto. Admite llamadas a herramientas y salida estructurada según un esquema JSON en response_format. Precio por millón de tokens: $2,00 de entrada, $6,00 de salida y $0,25 por lectura de caché.
Lo que afirma la propia Alibaba:
- OSWorld-Verified: 86,1, frente a 83,2 de GPT-5.6 Sol Max, 85,0 de Claude Fable 5 y 76,2 de Gemini 3.1 Pro
- PaperBench: 93,0, el mejor resultado publicado en este benchmark
Son cifras del fabricante, obtenidas en sus propias pruebas, y hay que tratarlas como tales.
Las plataformas independientes confirman lo principal. En LMArena, Qwen3.8-Max es tercero en la tabla de visión con 1.300±8, justo detrás de claude-fable-5 (1.313) y claude-opus-4-7-high (1.301). Pero lo relevante de ese puesto es otra cosa: una fuente secundaria describía la versión Max como solo de texto, y la tabla de visión zanja la cuestión. La actualización 0902 subió al primer puesto de Code Arena WebDev con 1.691, tres puntos por encima de Claude Opus 5 Max y veintidós por encima de la versión 3.8-Max original.
En Artificial Analysis, Qwen3.8-Max obtiene 47 puntos en el índice de inteligencia con un precio combinado de $1,19 por millón de tokens. Gemini 3.8 Flash saca los mismos puntos y cuesta $0,74. Una cifra que conviene recordar: 40 tokens por segundo de salida, el peor dato del top 10; Gemini 3.8 Flash llega a 334. El insignia de Qwen es lento, y en el trabajo interactivo se nota sin necesidad de benchmarks.
Qwen3.8-Flash-Next: doce veces más barato que el insignia (26 de agosto de 2026)
Una vista previa abierta de la arquitectura Qwen4. 125.000 millones de parámetros en total, 6.000 millones activos por token, más una capa de embeddings N-gram de 51.000 millones de parámetros que vive en la RAM normal y no ocupa memoria de la tarjeta gráfica. En el fondo es un diccionario de combinaciones de palabras frecuentes, y no hace falta tenerlo en la GPU: de ahí el ahorro.
Contexto nativo de 262.144 tokens, hasta 1 millón con YaRN. Precio: unos $0,16 de entrada y $0,47 de salida por millón de tokens, con la entrada en caché un 89% más barata aproximadamente. Es unas doce veces menos que Qwen3.8-Max.
El modelo no está en nuestro benchmark y, al cierre de este artículo, tampoco había aparecido en plataformas independientes. Lo único disponible son datos del fabricante: DeepSWE 58,7 y SWE-bench Pro 62,5 en código, además de CoWorkBench 73,9 y JobBench 55,7. Alibaba sostiene también que Flash-Next supera a Qwen3.7-Plus con aproximadamente una novena parte del coste de entrenamiento y que es más fuerte que DeepSeek-V4-Flash (284B) y Claude Opus 4.6 en la mayoría de las tareas probadas. De momento no hay dónde comprobarlo, así que tómalo como una promesa.
Los pesos están en Hugging Face y ModelScope bajo la Qwen Community License; el alojamiento, a través de la API de QwenCloud.
Pesos abiertos y licencias
Tres modelos de la misma generación han salido con tres regímenes legales distintos, y para un manager eso pesa más que las puntuaciones.
- Qwen3.8-27B: Apache 2.0. Sin condiciones: se puede integrar en productos comerciales, ajustar y revender.
- Qwen3.8-Flash-Next: Qwen Community License. Es un texto propio de Alibaba y hay que leerlo antes de implantarlo.
- Qwen3.8-Max: por primera vez se promete abrir un modelo de clase Max, pero se habla de una licencia propia con restricciones para empresas que facturen más de 50 millones de dólares con servicios de IA. No es Apache 2.0.
Y luego está la física. Qwen3.8-Max en FP8 ocupa unos 2,5 TB de pesos: nivel de centro de datos. En su caso, pesos abiertos significa poder estudiar el modelo y, con el hardware y la licencia adecuados, desplegarlo.
Un umbral de facturación como condición de licencia no es algo único: Kimi K3 lo fija en 20 millones de dólares. La conclusión práctica es una: “modelo con pesos abiertos” sin el nombre de la licencia no dice nada.
Qwen 3.7 Max: el insignia agéntico (mayo de 2026)
 Qwen 3.7 MaxEntiende tareas simples
puntuación 5,8/10 puesto 48 de 74 $0,037 por tarea sin VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Qwen 3.7 Max (también escrito Qwen3.7-Max) se presentó en el Alibaba Cloud Summit el 20 de mayo de 2026, tras aparecer discretamente en LM Arena el 14 de mayo. La serie 3.7 incluye dos modelos: Qwen3.7-Max (el insignia de texto para razonamiento y tareas agénticas) y Qwen3.7-Plus (el agente multimodal, disponible desde el 1 de junio de 2026).
Características clave de Qwen3.7-Max:
- Contexto de 1 millón de tokens, frente a 256K en Qwen 3.6 Max
- Arquitectura agéntica: el modelo puede trabajar en sesiones autónomas de hasta 35 horas, encadenando más de 1.000 llamadas a herramientas consecutivas sin perder calidad. En la demo del congreso, optimizó por su cuenta un kernel: más de mil cambios de código y una inferencia diez veces más rápida
- La tasa de alucinaciones más baja entre los modelos insignia: 22,9%
- Modo “Thinking”: una cadena de razonamiento activable, visible en la interfaz de Qwen Chat
Resultados en benchmarks:
| Benchmark | Qwen3.7-Max | Comparación |
|---|---|---|
| Intelligence Index v4.0 | 56,6 | 5.º del mundo, 1.º entre los modelos chinos |
| GPQA Diamond | 92,4% | Por encima de Claude Opus 4.6 Max (91,3%) |
| Apex Math | 44,5% | Por encima de Claude Opus 4.6 Max (34,5%) |
| MRCR-v2 128K (contexto largo) | 90,4% | Por encima de Qwen3.6-Plus (85,9%) |
| Terminal-Bench Hard (código) | 50,8% | – |
Qwen3.7 solo está disponible por API: la serie no tiene pesos abiertos y Alibaba no ha dado fechas para publicarlos. La generación siguiente rompió esa lógica: 3.8-Max se ha prometido en abierto, y 27B y Flash-Next salieron con los pesos públicos.
Qwen 3.7 Plus: el agente multimodal (disponible desde el 1 de junio de 2026)
Qwen 3.7 PlusEntiende tareas simples
puntuación 5,6/10 puesto 54 de 74 $0,006 por tarea sin VPN
Probado en el benchmark de mysummit.school: julio 2026Sobre el modelo →Comparar →
Qwen3.7-Plus apareció en LM Arena el 14 de mayo como versión preliminar y pasó a disponibilidad general el 1 de junio de 2026. Es la versión multimodal de la serie 3.7: recibe texto, imágenes y vídeo y devuelve texto.
En qué se diferencia de Qwen3.7-Max:
- GUI Agent Grounding: el modelo “ve” una captura de pantalla y devuelve las coordenadas exactas en píxeles de los elementos de la interfaz. Eso permite crear agentes autónomos que manejan aplicaciones de forma visual, sin API
- Contexto de 1 millón de tokens, hasta 65.536 tokens de salida y un presupuesto interno de razonamiento de hasta 256K tokens
- Parámetro
preserve_thinking: conserva el estado del razonamiento entre llamadas a herramientas en un bucle agéntico - Coste por tarea: en la ficha de arriba; entre los modelos multimodales, Plus es una de las opciones más baratas
Qwen 3.7 Plus es un modelo cerrado (solo API, sin pesos abiertos). Para un manager es una señal importante: los modelos multimodales más capaces de la serie 3.7 solo están disponibles a través de la API en la nube, sin opción de despliegue local. Con la llegada de Qwen3.8-27B, con visión y Apache 2.0, este argumento ha perdido bastante fuerza.
Qwen3.6-Plus: el insignia con contexto de 1 millón de tokens
Qwen 3.6 PlusEntiende tareas simples
puntuación 6,1/10 puesto 44 de 74 $0,011 por tarea sin VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Lanzado en abril de 2026 como respuesta a Gemini 2.5 y GPT-5. Su arquitectura híbrida combina atención lineal y mezcla de expertos dispersa, lo que le permite trabajar con documentos enormes sin perder velocidad.
- Hasta 1 millón de tokens de contexto: un informe anual o un repositorio de código completo cabe en una sola consulta, sin trocearlo.
- 78,8% en SWE-bench Verified, casi el nivel de los insignia cerrados en programación.
- Audio-Visual Vibe Coding: describe la tarea de viva voz y enseña un boceto a la cámara; el modelo genera el código.
- Licencia Apache 2.0: se pueden descargar los pesos y ejecutarlo en local.
Qwen3.5: una familia de modelos multimodales
Lanzada en marzo de 2026 y disponible en Microsoft Azure. La diferencia de fondo es que estos modelos “entienden” texto, imágenes, audio y vídeo como un todo dentro de una sola arquitectura. Una misma pregunta puede referirse a la vez a un documento cargado, una captura de pantalla, un fragmento de vídeo y un contexto de texto.
La serie cubre todo el rango, de 800 millones de parámetros (funciona en un smartphone) a 397.000 millones (comparable a GPT y Claude):
- Qwen3.5-4B / 9B: los más “listos” de su categoría de peso; corren en un portátil y superan a modelos dos o tres veces más grandes. Incluso en un móvil.
- Qwen3.5-27B: seguimiento estricto de instrucciones; informes estructurados, rellenado de formularios, encargos de varios pasos.
- Qwen3.5-35B-A3B: equilibrio entre calidad y velocidad; 35.000 millones de parámetros, pero solo 3.000 millones activos.
- Qwen3.5-122B-A10B: análisis complejos y grandes volúmenes de información.
- Qwen3.5-397B-A17B: el insignia de código abierto; en GDPval-AA supera a su predecesor Qwen3-235B por 361 puntos. Tercer mejor modelo open source del mundo.
En otoño, la familia sigue vigente y sigue entera bajo Apache 2.0, con visión en todas las versiones hasta 27B inclusive. Referencias de hardware: 0,8B funciona en un portátil sin tarjeta gráfica y ocupa unos 0,6 GB; 2B cabe en una RTX 3060 o un M1; 9B, en una tarjeta de 16 GB; 27B, en una RTX 4090. Todas las versiones tienen 256K de contexto nativo, y las capas híbridas de atención lineal eliminan la penalización habitual de la caché KV. En máquinas limitadas por la CPU o por el ancho de banda de la memoria, 35B-A3B va unas cinco veces más rápido que el 27B denso. 122B-A10B y 397B-A17B son solo de texto y requieren varias H100.
Lo común a toda la serie:
- Unas 400 páginas A4 por consulta; si hace falta, el contexto se amplía hasta el equivalente de un libro corto.
- Dos modos – “Pensar” (razonamiento paso a paso para tareas complejas) y “No pensar” (respuestas inmediatas para la rutina) – que se alternan dentro del mismo modelo, sin cambiar de servicio.
- Compatibilidad con 201 idiomas.
- En pruebas independientes compite con los principales modelos multimodales a un coste mucho menor.
El cambio de modo es el gran acierto de Qwen3/3.5. No hay que elegir entre un modelo “listo” y uno “rápido”: el mismo se adapta a la dificultad de la tarea. Razonamiento profundo para analizar un informe financiero; respuesta inmediata para “¿a qué hora es la reunión?”.
Qwen3-235B: el insignia de texto de código abierto
Lanzado en abril de 2025 y entrenado con el doble de datos que la generación anterior. Su arquitectura especializada alcanza calidad de insignia con un coste de cómputo mucho menor, una diferencia que se nota al trabajar por API.
- Modelo abierto: cualquier empresa puede descargarlo y ejecutarlo en sus servidores. Hará falta hardware de servidor serio.
- El modelo “piensa” antes de responder y revisa su lógica paso a paso. Importa en cálculos complejos, análisis jurídico y planificación financiera.
- Qwen3-Max es la versión en la nube por API, para quien no quiera ocuparse de instalar un servidor.
- Hasta 200 páginas A4 por consulta; en modo ampliado, hasta 400.
Qwen3-30B: la opción óptima para un servidor corporativo
Un modelo de clase empresarial: rápido y barato pese a su tamaño. En calidad supera a modelos más antiguos que necesitaban el triple de recursos.
- Para equipos que quieren un asistente potente en su propio servidor sin pagar un centro de datos entero.
- Hasta 200 páginas A4 por consulta.
Qwen3-Coder-Next: un modelo para desarrolladores (febrero de 2026)
Un modelo especializado en escribir y revisar código. En pruebas independientes supera a los modelos de DeepSeek y se mantiene al nivel de Claude Sonnet 4.5.
Para un manager, lo más probable es que sea una herramienta del equipo de desarrollo. El modelo puede retener en memoria un proyecto completo, con todos los archivos del repositorio. Ejecutarlo en un servidor propio requiere unos 51 GB de RAM.
Qwen 4 Coder: el primer codificador open source con un 82% en SWE-Verified (junio de 2026)
Qwen 4 Coder 32B-A3B, lanzado el 2 de junio de 2026, es el primer modelo que marca el paso a la cuarta generación de Qwen y el primer modelo abierto que supera el 80% en SWE-Verified, un benchmark que se correlaciona con la productividad real de un desarrollador.
- Arquitectura MoE: 32.000 millones de parámetros en total, 3.000 millones activos por token. Contexto de 256K
- 82% en SWE-Verified: por encima de Devstral, Qwen3.6-Coder y todos los modelos que corren en un portátil
- Funciona en un Mac con 24 GB: 58 tokens/s en un M4 Pro, uso completo sin servidor
- Entrenado con pruebas reales: a diferencia de sus predecesores, Qwen 4 Coder se entrenó con aprendizaje por refuerzo sobre los resultados de pruebas de incidencias reales de GitHub
- Licencia Apache 2.0: las mismas libertades que Qwen3.8-27B; productos comerciales, ajuste fino y reventa
Para un CTO o un responsable de desarrollo, Qwen 4 Coder es un motivo para revisar el gasto en suscripciones: un modelo que corre en el portátil de trabajo de un desarrollador resuelve tareas al nivel de los insignia en la nube.
La gama impresiona, pero elegir el modelo adecuado es solo una parte del trabajo. En agosto, Alibaba sacó tres lanzamientos, cada uno con su propósito: un insignia para razonamiento complejo, un modelo compacto para ejecutar en casa y uno barato para flujos agénticos de gran volumen. La diferencia entre “obtener una respuesta” y “obtener un resultado fiable” está en saber formular las peticiones y verificar lo que sale. De eso trata precisamente nuestro módulo gratuito.
Qwen3-VL: análisis de imágenes y documentos
Entiende imágenes, vídeos (de más de una hora), PDF y texto manuscrito. El reconocimiento de texto funciona en 32 idiomas: sube el escaneo de un contrato o la foto de la pizarra al acabar una reunión y obtendrás texto estructurado.
Qwen3.5-Omni: multimodalidad nativa (marzo de 2026)
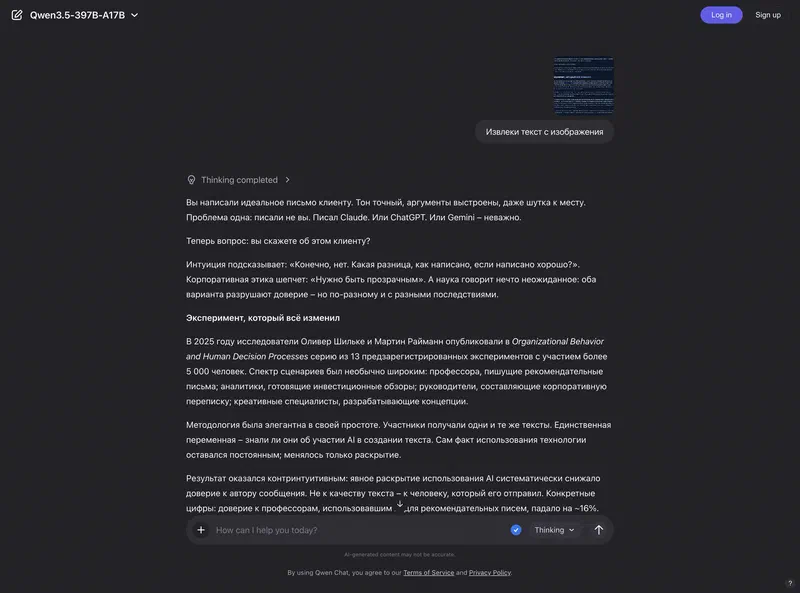
Texto, imágenes, audio y vídeo se procesan con una sola arquitectura, sin codificadores separados. Según las mediciones de Alibaba, logra los mejores resultados de su clase en 215 tareas de comprensión de audio y contenido audiovisual. Admite entrada y salida de voz en tiempo real, búsqueda web integrada y llamadas a herramientas externas. Sobre Omni funciona el Audio-Visual Vibe Coding: el desarrollador describe los requisitos de viva voz y muestra la interfaz en vídeo, y el modelo escribe el código.
Qwen3-TTS y Qwen-Image-2512: voz e imágenes
Qwen3-TTS (licencia abierta) sintetiza voz con clonación y generación en streaming para asistentes de voz y locuciones. Qwen-Image-2512 es un modelo de generación de imágenes renovado, con detalle fotorrealista y buen renderizado de texto: rótulos de varias líneas, párrafos, elementos de marca, justo donde fallan Midjourney y DALL-E.
Modelos para ejecutar en local
Alibaba ofrece una gama de modelos compactos que se pueden ejecutar en hardware propio, desde un portátil hasta un servidor corporativo:
| Dónde ejecutarlo | Modelo | Documento máx. | Para qué tareas |
|---|---|---|---|
| Smartphone o tablet | Qwen3-0.6B | ~50 págs. | Autocompletado, sugerencias sencillas |
| Portátil normal (4 GB de RAM) | Qwen3-1.7B | ~50 págs. | Borradores de correos, resúmenes breves |
| Portátil potente (8 GB de RAM) | Qwen3-4B | ~50 págs. | Análisis de documentos, calidad al nivel de los antiguos modelos top |
| PC de trabajo (16 GB de RAM) | Qwen3-8B | ~200 págs. | Documentos complejos, tablas, conversaciones largas |
| Servidor de departamento (32 GB de RAM) | Qwen3-14B | ~200 págs. | Un asistente de equipo completo |
| Servidor corporativo (48 GB de RAM) | Qwen3-32B | ~200 págs. | Calidad cercana a los mejores modelos en la nube |
| Clúster de servidores (desde 140 GB) | Qwen3-235B | ~400 págs. | Calidad de insignia, compite con GPT y Claude |
Si tu empresa no puede enviar datos a servidores externos – finanzas, sanidad, sector público –, puedes descargar el modelo que necesites y desplegarlo dentro de la red corporativa. Los datos nunca salen de tu perímetro. Eso no se puede hacer con ChatGPT ni con Claude.
Qwen3-4B cabe en un portátil corriente (desde 4 GB de memoria) y ofrece una calidad comparable a la de modelos que antes exigían un rack de servidores completo.
Una guía práctica para elegir hardware, instalar Ollama y comparar modelos locales con los de la nube está en nuestra guía de LLM locales para managers.
Qwen3.8-27B: un modelo que cabe en una sola tarjeta gráfica
Lanzado el 13–14 de agosto de 2026 y, para una empresa, un acontecimiento más relevante que la salida del insignia.
Un modelo denso de 27–28.000 millones de parámetros con codificador visual: entiende de forma nativa imágenes y vídeo y devuelve texto. Contexto de 262K. Licencia Apache 2.0, sin salvedades sobre facturación ni revisión jurídica aparte para cada caso de uso. En cuantización Q4_K_M ocupa unos 17 GB, es decir, una tarjeta gráfica de consumo tipo RTX 4090 o un portátil con 16 GB de memoria mediante Ollama o llama.cpp.
Todavía no está en nuestro benchmark, pero tampoco hay mucho con qué compararlo: Apache 2.0, visión de serie y una sola tarjeta gráfica. Hasta agosto, esa combinación no existía en el mercado.
Para una empresa que no puede enviar datos a la nube, es la primera opción “todo en casa” que no parece un compromiso. Qwen3-4B en un portátil era una demostración de lo posible. Un 27B con visión y 262K de contexto es una herramienta de trabajo para escaneos de contratos, fotos de pizarras, normativas internas y correspondencia que no se puede enseñar a un servicio externo.
Qué conviene comprobar antes de implantarlo:
- La velocidad en tu hardware. 17 GB es el tamaño de los pesos; no dice nada del tiempo de respuesta aceptable. En una máquina con 16 GB de memoria, parte del modelo pasará a la CPU y la generación se ralentizará.
- La calidad en español. Todavía no hay mediciones independientes, así que hay que probarlo con tus propios documentos; la impresión de una demo no es un argumento.
- El mantenimiento. Un despliegue local implica un servidor, actualizaciones de pesos, monitorización y una persona responsable de todo ello. Parte del ahorro en API se irá en su sueldo.
Cómo se ve Qwen frente a la competencia
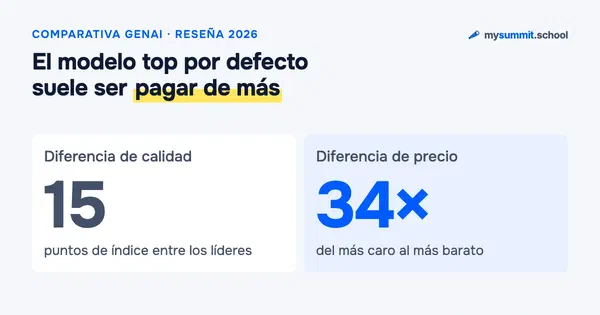
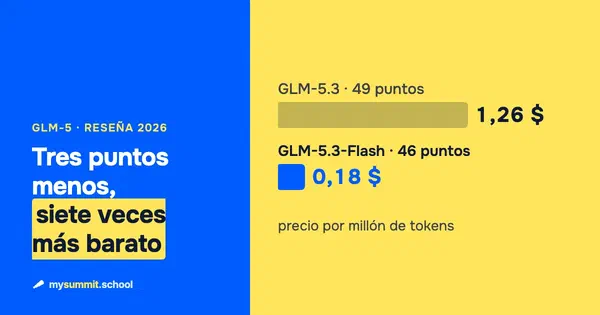
Las plataformas independientes dibujan un panorama más modesto que los anuncios. En el índice de Artificial Analysis de septiembre de 2026, la distancia entre el primer puesto (Claude Fable 5.1, 57 puntos) y el décimo (DeepSeek V4 Pro 0813, 42) es de 15 puntos, mientras que la diferencia de precio es de 34 veces: $6,12 frente a $0,18 de GLM-5.3-Flash. Los 47 puntos de Qwen3.8-Max los comparte con Gemini 3.8 Flash.
Una salvedad de metodología. Artificial Analysis publica su índice por versiones y recalcula la escala entre ellas, de modo que la cifra del anuncio de un modelo y la de la tabla en vivo pertenecen a escalas distintas. Solo se puede comparar dentro de un mismo corte.
En LMArena, los puestos del primero al noveno se solapan dentro de sus intervalos de confianza en ambas tablas, la de texto y la de visión. Formalmente es un empate. Quien proclama el mejor modelo a partir de una tabla así la está leyendo demasiado al pie de la letra; lo explicamos en un análisis aparte.
| Criterio | Qwen | ChatGPT / Claude | DeepSeek |
|---|---|---|---|
| Calidad del insignia | Máxima (47 puntos en Artificial Analysis, 1.º en Code Arena WebDev) | Máxima | Media a un precio mínimo |
| Acceso web gratuito | Sí, chat.qwen.ai sin límites | Limitado | Limitado |
| Se puede ejecutar en un servidor propio | Sí: Qwen3.8-27B, Flash-Next, Qwen 4 Coder, series 3.6 y 3.5; la serie 3.7 es cerrada | No | En parte |
| Coste de la API | El más bajo de su clase: Qwen3.8-Max – $2,00/$6,00, Flash-Next – $0,16/$0,47 | Alto: GPT-6 Astra – $10/$50 | Bajo |
| Imágenes y vídeo | Sí (3.8-Max, 3.8-27B, 3.7 Plus, 3.5-Omni) | Sí | Limitado: visión solo en vista previa en el plan barato |
Para la mayoría de las tareas de negocio – redacción, análisis de datos, resúmenes de documentos –, Qwen 3.7 Plus da resultados comparables a Claude Sonnet 5 a un precio bastante más bajo.
Resultados en nuestro benchmark (actualización de septiembre de 2026)
Qwen es el ecosistema con más presencia en nuestro benchmark: cinco modelos. Los resultados se basan en 80 escenarios de tareas reales de manager (análisis, planificación, comunicación, gestión de equipos). La gama 3.8 no está entre ellos: aún no hemos probado Qwen3.8-Max, 27B ni Flash-Next, y todo lo dicho sobre ellos más arriba se apoya en datos del fabricante y de plataformas independientes.
Los tres insignia – Qwen 3.6 Plus, Qwen 3.7 Max y Qwen 3.7 Plus – se analizan más arriba con datos recientes del benchmark (puesto, puntuación, coste por tarea y fecha de la prueba en las fichas bajo sus títulos). Quedan dos modelos de gama media:
Qwen 3.6 FlashEntiende tareas simples
puntuación 5,6/10 puesto 55 de 74 $0,008 por tarea sin VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Qwen 3.6 27BEntiende tareas simples
puntuación 5,8/10 puesto 51 de 74 $0,017 por tarea sin VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Qwen 3.6 Flash supera a Gemini 3.5 Flash por una fracción del precio; Qwen 3.6 27B destaca especialmente en planificación. En relación calidad-precio, Qwen 3.6 Plus resulta más convincente que Claude Sonnet 5 y que GPT-5.4 Mini, y sale más barato.
La gran paradoja de la gama: Qwen 3.7 Max cuesta más que Qwen 3.6 Plus, pero queda por debajo en la clasificación general. Gana concretamente en las categorías “planificación” y “gestión de equipos”: si esas tareas son clave para ti, Max está justificado.
- Information search6,0
- Data analysis6,0
- Decisions under uncertainty6,7
- Feedback analysis6,7
- Corporate requirements and risks6,1
- Automation5,6
- People management6,7
- Russia and Kazakhstan specifics4,7
El perfil de Qwen 3.6 Plus en ocho categorías muestra la brecha con claridad: fuerte en texto y análisis, flojo allí donde hace falta contexto local.
Toda la gama Qwen comparte las mismas debilidades:
- Legislación laboral local: en los escenarios de nuestro benchmark, construidos sobre el derecho laboral ruso, se inventa artículos y sanciones que no existen. Las cuestiones jurídicas críticas no se pueden resolver sin verificación.
- Cálculos financieros: errores aritméticos sistemáticos.
- Conocimiento regional: la categoría más débil de todos los modelos Qwen.
La estrategia de uso, por ahora, es esta. Qwen 3.6 Plus es el modelo principal de trabajo. Qwen 3.7 Plus, para operaciones rutinarias masivas cuando el presupuesto aprieta. Max se justifica donde lo que cuenta es la planificación y la gestión de equipos: según nuestras mediciones, ahí es más fuerte. En cuanto la gama 3.8 entre en el benchmark, habrá que rehacer estas cuentas.
Resultados interactivos completos ->
Pruébalo tú mismo: planificación y derecho laboral
Tú
Eres el director de RR. HH. de una empresa tecnológica en Madrid. Elabora un plan de onboarding para los primeros 90 días de un nuevo responsable de departamento.

## Contexto
- Empresa: 85 personas, desarrollo de producto
- El nuevo responsable viene de la competencia y se ha traído a 2 colaboradores
- El equipo tiene 12 personas, 3 de ellas molestas con la llegada de alguien de fuera
- Formato: híbrido (3 días en oficina, 2 en remoto)

## Tarea
1. Ten en cuenta el Estatuto de los Trabajadores: periodo de prueba para un puesto directivo, alta y trámites de contratación, formación obligatoria en prevención de riesgos laborales
2. Plan de integración en el equipo: cómo gestionar la "resistencia"
3. KPI a 30/60/90 días con métricas concretas
4. Presupuesto de incorporación: 2.500 € – en qué gastarlo
5. Riesgos: qué puede salir mal y cómo detectarlo

Formato: plan estructurado con responsables y plazos.
Qwen suele entregar una estructura de plan excelente (la planificación es su categoría más fuerte), pero cuando cita el Estatuto de los Trabajadores a menudo se inventa artículos y sanciones que no existen (el conocimiento regional es su categoría más débil). DeepSeek tiene el mismo problema con la legislación local, y Kimi K2.6 es el mejor planificador, pero también conoce mal la normativa local.
Aplicación práctica para un manager
La mayoría de los managers que prueban Qwen empiezan por Qwen Chat, una interfaz web gratuita con acceso a los modelos actuales. Incluye búsqueda web, generación de imágenes y análisis de documentos sin suscripción alguna. Es un buen punto de partida para evaluar la herramienta antes de hablar con el departamento de TI.
Qwen se maneja con soltura con documentos difíciles: escaneos de contratos, notas manuscritas y fotos de pizarras salen convertidos en texto limpio y estructurado.
Otro escenario es el despliegue corporativo sin nube. Para empresas que no pueden sacar datos de su perímetro, Qwen ofrece lo que ChatGPT y Claude no tienen: los modelos se pueden descargar y ejecutar en servidores propios. Desde agosto de 2026, este escenario ya no exige renunciar a calidad: Qwen3.8-27B, con visión y Apache 2.0, lo resuelve con una sola tarjeta gráfica. Es la misma lógica que siguen los Estados al construir sistemas de IA soberana: el control de los datos pesa más que la comodidad de la nube.
Por último, Qwen3.5-Omni y Qwen3-TTS permiten montar un asistente de voz completo – reconocimiento de voz, procesamiento de la petición, síntesis de voz – dentro de un mismo ecosistema, sin tener que encadenar varios servicios distintos.
Media vuelta: el insignia vuelve a ser abierto
En el primer semestre de 2026 cambió la propuesta de valor central de Qwen. Alibaba pasó sus modelos insignia – Qwen3.7-Max y Qwen3.7-Plus – a formato cerrado (solo API, sin pesos abiertos). Eso la ponía en competencia directa con OpenAI y Anthropic por los contratos corporativos de API y parecía una renuncia a aquello sobre lo que había crecido el ecosistema.
Ni siquiera entonces fue un abandono total del open source: Qwen3.6-35B-A3B y Qwen 4 Coder salieron con licencia Apache 2.0. Pero los modelos más capaces quedaron cerrados, y la empresa no se comprometió a ninguna fecha para abrir la serie 3.7.
En agosto cambió el rumbo. Qwen3.8-Max es el primer insignia de clase Max cuyos pesos Alibaba ha prometido publicar. Ese mismo mes salieron Qwen3.8-27B bajo Apache 2.0 y Qwen3.8-Flash-Next, con pesos en Hugging Face y ModelScope. La serie 3.7 siguió cerrada.
El giro de primavera coincidió con la salida de figuras clave del equipo. En marzo de 2026 se marchó el responsable técnico del proyecto, Lin Junyang, que escribió en redes sociales: “me stepping down. bye my beloved qwen”. Ese mismo día dimitió Yu Bowen, que dirigía el post-entrenamiento. Antes ya se había ido Hui Binyuan, investigador principal de código. Un compañero del equipo comentó: “Sé que irte no fue decisión tuya”. Las acciones de Alibaba cayeron un 5,3% ese día.
Para un manager que elige Qwen, el panorama queda así:
- Los modelos abiertos han llegado a la gama alta. 27B y Flash-Next ya se pueden descargar y Max está prometido. Si el control de los datos es crítico, ya no hay nada que esperar.
- Hay que leer las condiciones. Apache 2.0 en el 27B, licencia propia en Flash-Next y umbral de facturación en Max.
- La inestabilidad en el equipo no ha desaparecido. El ritmo de lanzamientos no bajó en verano, pero una sola temporada no basta para hablar de tendencia.
Limitaciones y riesgos
- Licencia del insignia: la apertura de Qwen3.8-Max está prometida, pero con una licencia propia y un umbral de facturación. Solo conviene planificar un despliegue comercial en servidores propios después de leer el texto.
- Tamaño del insignia: unos 2,5 TB de pesos en FP8, nivel de centro de datos; en la práctica, Qwen3.8-Max sigue siendo un modelo en la nube, se publiquen o no los pesos.
- Velocidad: 40 tokens por segundo de salida según Artificial Analysis, el peor dato del top 10. Se nota en el trabajo interactivo y en los bucles agénticos con cientos de llamadas.
- Bajas en el equipo: la salida del responsable técnico del proyecto y del responsable de post-entrenamiento en marzo de 2026 es una señal seria. Alibaba reorganizó el equipo y creó una unidad transversal para el desarrollo de modelos base, pero las consecuencias a largo plazo aún no están claras.
- Censura y filtros: como otros modelos chinos, Qwen tiene restricciones integradas para hablar de ciertos temas políticos e históricos. En tareas de negocio rara vez es un problema.
- Riesgos geopolíticos: el modelo pertenece a Alibaba (China). Para algunas organizaciones esto puede descartar el uso de la API en la nube. La solución es el despliegue local de las versiones abiertas.
- Calidad en español: pese a admitir más de 200 idiomas, las respuestas en español pueden quedar por debajo de las de inglés. Pruébalo con tus propias tareas.
- Integraciones: hay muchos menos conectores listos para servicios occidentales – Slack, Notion, Google Workspace – que en ChatGPT o Claude. Qwen está mejor integrado con herramientas corporativas chinas.
Precios y disponibilidad
| Opción | Coste | Para quién |
|---|---|---|
| chat.qwen.ai | Gratis | Probar Qwen sin cuenta de API |
| Qwen3.8-27B (descarga) | Gratis, Apache 2.0 | Visión, contexto de 262K, ~17 GB en Q4_K_M: una tarjeta gráfica |
| Qwen3.8-Flash-Next (API / pesos) | $0,16 / $0,47 por millón entrada/salida | Flujos agénticos masivos, hasta 1 millón de contexto con YaRN |
| Qwen3.8-Max (API) | $2,00 / $6,00 por millón, caché $0,25 | Insignia: texto, imagen y vídeo, contexto de 1 millón |
| Qwen 4 Coder 32B-A3B (descarga) | Gratis (Apache 2.0) | Programar en un portátil, 82% en SWE-Verified |
| Qwen3-0.6B / 4B (descarga) | Gratis | Ejecución en portátil, control total de los datos |
| Qwen3-235B (descarga) | Gratis | Insignia en local, requiere un clúster de servidores |
| Qwen3.7-Plus (API, GA) | $0,40 / $1,60 por millón entrada/salida | Agente multimodal, GUI grounding, contexto de 1 millón |
| Qwen3.7-Max (API) | $2,50 / $7,50 por millón entrada/salida | Insignia de texto, escenarios agénticos, contexto de 1 millón |
| Qwen3.5-397B-A17B (API) | $0,39 / $2,34 por millón entrada/salida | Insignia con licencia abierta |
Para comparar: analizar un informe de 100 páginas con GPT-4o cuesta unos $0,35; con Claude Sonnet, unos $0,55. En la gama alta la brecha es mayor: $10/$50 por millón de tokens en GPT-6 Astra frente a $2/$6 en Qwen3.8-Max.
Qwen sigue teniendo tres puertas de entrada: el chat gratuito, una API en la nube barata y el despliegue local. En verano cambió la tercera: un 27B con visión y un Max prometido en abierto ya son gama alta.
¿Vale la pena probarlo?
Hace medio año, el argumento a favor de Qwen era sencillo: “lo mismo que ChatGPT, pero gratis y abierto”. En primavera se tambaleó. En septiembre ha vuelto, y con una gama más sólida.
El código abierto cubre ahora todo el abanico de tareas. Qwen3.8-27B, con Apache 2.0, visión y 17 GB de pesos, corre en una sola tarjeta gráfica. Flash-Next, a $0,16/$0,47, aguanta flujos agénticos con hasta 1 millón de tokens de contexto, y Qwen 4 Coder y la familia Qwen 3.5 siguen plenamente vigentes. Para las empresas que necesitan control local de sus datos sigue habiendo pocas alternativas, y esta es la más sólida disponible.
En la mayoría de las tareas, todos los modelos top dan hoy resultados comparables, y la diferencia no es evidente en el trabajo diario. Qwen 3.7 Plus cubre análisis multimodal, flujos agénticos y trabajo con la pantalla, lo mismo que Claude Sonnet 5, pero varias veces más barato. En tareas masivas, el ahorro se nota.
La salida de desarrolladores clave y la reorganización del equipo son un riesgo que conviene vigilar. De momento el ritmo de lanzamientos no ha bajado, pero eso no es una garantía. Si construyes procesos críticos sobre Qwen, ten un plan B: DeepSeek o modelos en la nube con una estructura corporativa más estable.
Este otoño hay una cosa que seguir de cerca: el texto de la licencia de Qwen3.8-Max. La promesa de abrir el insignia ya está hecha; las condiciones para usarlo todavía no las ha visto nadie.
Otras partes de esta serie
 Parte 1
ChatGPT en 2026: qué ha cambiado y por dónde empezar si eres manager
 Parte 2
Claude de Anthropic en 2026: Opus 5, Fable 5.1, Mythos 5.1, Cowork y Chrome – guía para managers
 Parte 3
Perplexity AI en 2026: el buscador inteligente que todo manager debería probar
 Parte 4
Google Gemini en 2026: modelos, NotebookLM e integración con Workspace
 Parte 5
Grok de SpaceXAI en 2026: análisis de la IA de Elon Musk
 Parte 6
YandexGPT en 2026: análisis de la IA rusa de Yandex para empresas
 Parte 7
DeepSeek en 2026: análisis de V4-Pro y V4-Flash tras la subida de precios
 Parte 8
GigaChat en 2026: análisis honesto – ¿vale la pena usarlo para el trabajo?
 Parte 10
Cómo se evalúa la calidad de los LLM en 2026: guía de benchmarks para managers
 Parte 11
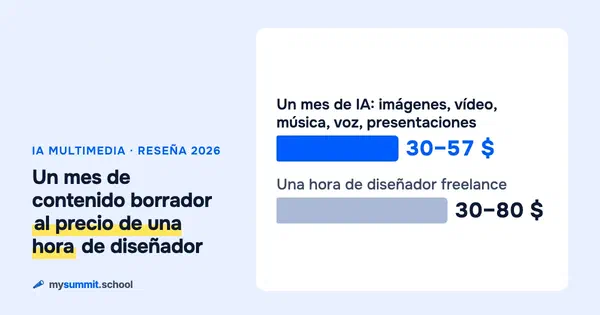
IA para crear contenido multimedia en 2026: imágenes, vídeo, música y presentaciones
 Parte 12
Comparativa de herramientas GenAI 2026: ¿qué IA debe elegir un manager?
 Parte 13
Chat Z.AI (GLM-5) en 2026: el modelo chino que finge ser Claude
 Parte 14
Kimi de Moonshot en 2026: K3, K2.6, K2.7-Code y agentes
 Parte 15
GigaChat en el trabajo: cómo sacar el máximo a la IA soberana rusa
 Parte 16
Los benchmarks de IA pierden sentido: ¿cómo elegir un modelo entonces?
 Parte 17
Meta Muse Spark: el primer modelo cerrado de Meta desde 2023
 Parte 18
Modelos MAI de Microsoft en 2026: qué se puede usar de verdad y cuánto cuesta
 Parte 19
Agentes de código en 2026: dos formatos, el terminal y el escritorio
Fuentes
- Qwen3.8-Max 0902 en OpenRouter – ficha del modelo: modalidades, contexto, precios
- Alibaba releases Qwen3.8-Flash-Next – arquitectura y precios de Flash-Next
- Qwen3.8-Max: análisis de DataCamp – benchmarks y condiciones de licencia
- Alibaba releases Qwen3.8-Max – especificaciones y calendario de lanzamiento
- Qwen 3.5: guía completa – requisitos de hardware de la familia abierta
- Artificial Analysis – tabla de modelos – índice de inteligencia, precio combinado, velocidad de salida
- LMArena (Arena.ai) – ranking de preferencias – tablas de texto y visión, septiembre de 2026
- Qwen Chat – interfaz web gratuita – chat oficial de Alibaba, funciona sin registro
- Sitio oficial de Qwen – documentación y descripción de todos los modelos
- Modelos Qwen en Hugging Face – 433 modelos abiertos para descargar, más de 300 millones de descargas
- Qwen en GitHub – código fuente y documentación, más de 40 repositorios
- API a través de Alibaba Cloud Model Studio – acceso en la nube a Qwen-Plus y Qwen-Max

18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.