Comparativa de herramientas GenAI 2026: ¿qué IA debe elegir un manager?
Modelos de IA en este artículo
En septiembre de 2026 el mercado de la IA generativa reúne decenas de herramientas. Cada fabricante se proclama líder y los materiales de marketing compiten por ver quién grita más. ¿Cómo elige un manager la herramienta que de verdad resuelve el trabajo?
Este artículo reúne los datos clave de las principales herramientas GenAI que hemos analizado a fondo en nuestra serie de reseñas: tablas resumen, recomendaciones por escenario y consejos prácticos para decidir.
Entre la versión de julio y la de septiembre de esta página ha cambiado casi cada buque insignia de las tablas. OpenAI, Anthropic, Google, xAI, Alibaba y Z.ai lanzaron nuevos modelos de gama alta en seis semanas. A continuación, qué cambia realmente la decisión de un manager y qué se quedará en los comunicados de prensa.
El catálogo a 6 de septiembre de 2026
| Proveedor | Modelo insignia actual | Fecha de lanzamiento | Qué figuraba en la versión de julio de este artículo |
|---|---|---|---|
| OpenAI | GPT-6 Astra | 3 de septiembre | GPT-5.6 Sol |
| Anthropic | Claude Fable 5.1; modelo de trabajo – Opus 5 | 1 de septiembre y 24 de julio | Opus 4.6 / 4.8 |
| Gemini 3.8 Flash; sin modelo de gama alta | 2 de septiembre | Gemini 3.1 Pro | |
| xAI | Grok 4.6 | 12 de agosto | Grok 4.5 |
| Alibaba | Qwen3.8-Max | 3 de agosto | Qwen 3.6 Plus / 3.7 Max |
| Z.ai | GLM-5.3 y GLM-5.3-Flash | 14 y 26 de agosto | GLM-5.1 / 5.2 |
| DeepSeek | V4-Pro, ya en GA | 13 de agosto | V4-Pro / V4-Flash |
| Moonshot | Kimi K3 | 16 de julio | sin cambios |
| Sber | GigaChat 3.5 Ultra, ahora con licencia MIT | julio | sin cambios |
| Yandex | Alice AI, YandexGPT 5.1 Pro | 28 de julio | sin cambios |
Ningún modelo lanzado después del 16 de julio está todavía en nuestro benchmark. Todo lo que se dice más abajo sobre GPT-6 Astra, Claude Fable 5.1 y Opus 5, Gemini 3.8 Flash, Grok 4.6, Qwen3.8 y GLM-5.3 se apoya en datos de los fabricantes y en dos plataformas independientes: Artificial Analysis y LMArena. Los resultados de nuestro propio benchmark describen el catálogo de julio, y lo indicamos siempre.
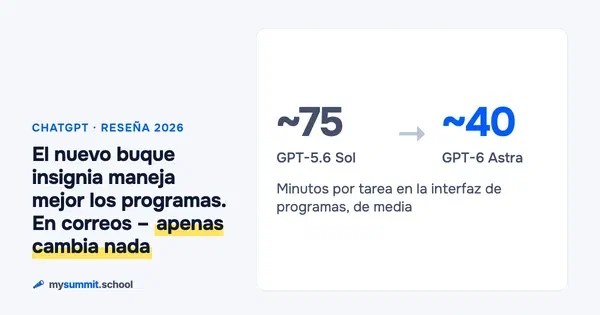
Hemos eliminado la nota histórica sobre GPT-5.4 de la versión de marzo: en seis meses la sustituyó GPT-5.6 Sol y ahora Astra. De aquel lanzamiento queda una consecuencia: el control del ordenador ha dejado de ser una rareza. Astra desarrolla justo eso: en OSWorld V2-Offline, según OpenAI, alcanza un 72,6 % frente al 65,7 % de GPT-5.6 Sol y dedica unos 40 minutos por tarea en lugar de 75. En código la mejora es más modesta: 74,1 % en DeepSWE v1.1 frente a 72,7 %.
Resultados del benchmark de mysummit.school (julio de 2026)
Desde la publicación original, en mysummit.school, plataforma educativa, hemos realizado un benchmark independiente con 47 modelos. Los modelos resolvieron tareas reales de gestión y dos modelos jueces evaluaron las respuestas: Claude Opus 4.6 y Gemini 3.1 Pro. La metodología y la escala están descritas en la página del benchmark.
El límite es sencillo: estos resultados son nuestros y se refieren a los modelos que hemos probado. Todo lo que los fabricantes lanzaron después del 16 de julio no aparece y solo entrará tras la próxima ronda.
Principales hallazgos:
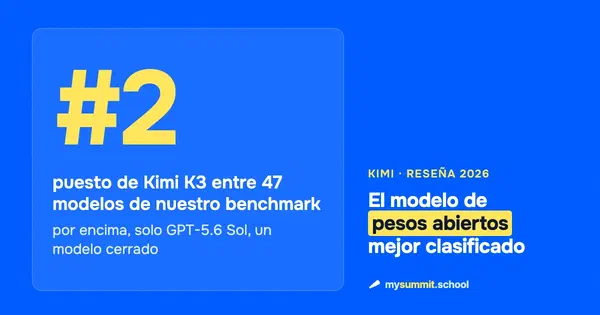
- En lo más alto están GPT-5.6 Sol de OpenAI y Kimi K3 de Moonshot: primer y segundo puesto en la ronda de julio. Kimi K3 es el modelo no estadounidense más potente del ranking.
- Los modelos chinos entran en el top 10. Además de Kimi K3, están MiniMax M3 y MiMo v2.5 Pro de Xiaomi. Los tres cuestan entre 5 y 10 veces menos que sus equivalentes occidentales.
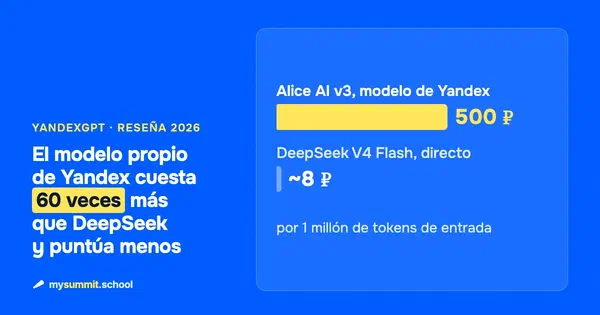
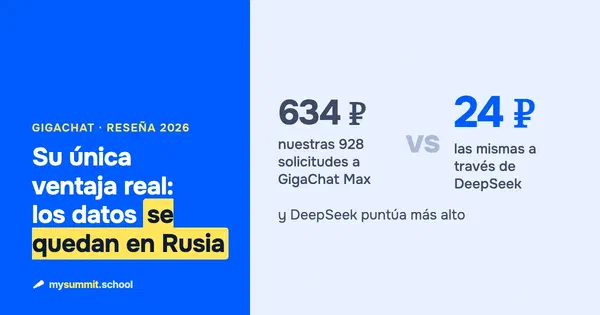
- DeepSeek V4 Flash en Yandex Cloud, la versión alojada en la nube rusa, cuesta entre 28 y 33 veces más que el original con una calidad algo inferior.
- El modelo más reciente de Sber, GigaChat 3.5 Ultra, ha mejorado claramente respecto a GigaChat 2 Max, pero su precio ya iguala al de GPT-4 y sigue lejos de los líderes.
- Grok 4.5 cierra el top 10 y sigue siendo de los mejores en gestión de equipos.
- Qwen tiene cinco modelos en el top 30. Qwen 3.6 Plus ofrece la mejor relación calidad-precio.
Los resultados detallados de cada herramienta están en los artículos actualizados de la serie, más abajo.
Qué ha cambiado de verdad
Siete historias que atraviesan a todos los proveedores. Conviene tenerlas presentes antes de abrir cualquier tabla.
El modelo barato ahora suele ser el mejor
Gemini 3.8 Flash cuesta 0,75 $ por millón de tokens de entrada y 3,75 $ por millón de salida: es el precio de lanzamiento de Google. En el índice de Artificial Analysis obtiene 47 puntos, los mismos que Qwen3.8-Max a 2 $/6 $, y cinco más que DeepSeek V4-Pro. En la tabla de texto de LMArena es octavo.
Dos salvedades cambian las cuentas. El precio de lanzamiento es válido hasta el 31 de diciembre de 2026 y Google no ha publicado la tarifa normal. Y la propia Google advierte que el coste real por consulta sale un 40 % por encima de la lista, porque el modelo genera más tokens de salida y da más pasos agénticos.
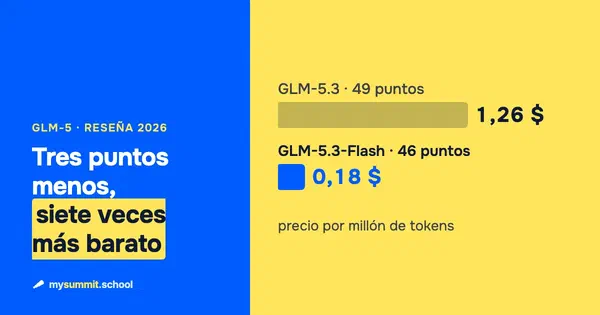
GLM-5.3-Flash cuesta 0,15 $/0,50 $ frente a 1,40 $/4,40 $ del GLM-5.3 completo. En el índice de Artificial Analysis queda tres puntos por detrás, 46 frente a 49, con una diferencia de siete veces en el precio combinado. Z.ai publica además sus propias comparaciones con la generación anterior: en DeepSWE v1.1 Flash logra 63,4 frente a 46,2 y en AutomationBench, 48,8 frente a 26,2. Tres puntos de índice a cambio de un ahorro de siete veces es un trato que se calcula para cada tarea concreta, no que se acepta por fe.
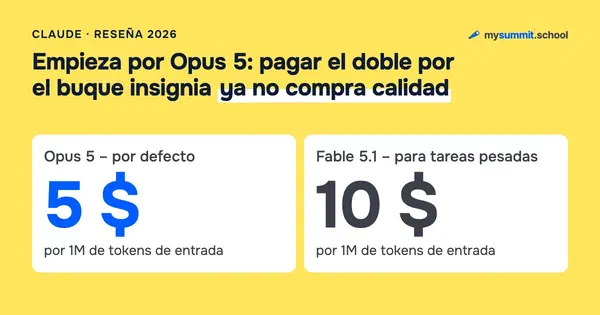
Anthropic ha construido su catálogo con el mismo principio. Opus 5, a 5 $/25 $, se queda según Anthropic a un 0,5 % del pico de Fable 5 en CursorBench 3.2 con la mitad de coste por tarea. Fable 5.1, a 10 $/50 $, es la escalada para problemas realmente difíciles, no el modo de trabajo habitual.
En septiembre de 2026, comprar por defecto el modelo de gama alta es un error más a menudo que un acierto.
Los umbrales de precio recalculan toda la consulta
GPT-6 Astra según la lista de precios de OpenAI: 10 $ de entrada y 50 $ de salida por millón de tokens mientras la entrada no supere los 272.000. A partir de ahí la tarifa de entrada se duplica a 20 $, la de salida sube a 75 $ y se recalcula toda la consulta, no solo los tokens que pasan del umbral. Un solo documento largo en el contexto cambia el precio de la llamada entera.
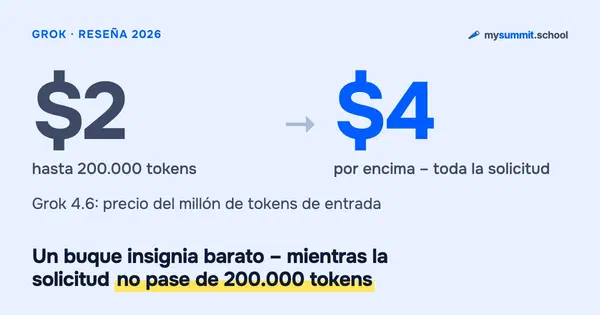
Grok 4.6 funciona igual, con el umbral más bajo, en 200.000: 2 $/6 $ se convierten en 4 $/12 $.
Desde el 16 de agosto, DeepSeek V4-Pro factura por franjas punta y valle; las horas punta son 01:00–04:00 y 06:00–10:00 UTC, y fuera de ellas el precio es la mitad. Al mismo tiempo, las tarifas por acierto de caché subieron más de un orden de magnitud respecto a los precios iniciales de la preview: hasta un 1.100 %, según el changelog oficial de DeepSeek. El más barato de todos, sí. Agresivamente barato, ya no.
Ninguno de estos mecanismos aparece en la página de precios tal como lo verá el departamento financiero a final de mes.
La velocidad, la variable que nadie compara
Artificial Analysis mide la velocidad de salida en tokens por segundo. Gemini 3.8 Flash da 334. Los otros nueve modelos del top 10 van de 40 a 87; los más lentos son Qwen3.8-Max y Kimi K3, con 40 y 42 respectivamente.
La latencia no sale en las diapositivas, pero la nota cualquiera que espere una respuesta más de un par de segundos. Cuando el modelo trabaja dentro de la interfaz del usuario –soporte, revisión de documentos, borrador de un correo–, una diferencia de velocidad de cuatro veces pesa más que tres puntos de índice.
«Pesos abiertos» ahora significa cuatro cosas distintas
| Qué pone | Qué te permite | Ejemplos del catálogo de septiembre |
|---|---|---|
| MIT | Disponer de los pesos sin condiciones | GLM-5.3-Flash, GigaChat 3.5 Ultra, DeepSeek V4-Pro |
| Apache 2.0 | Lo mismo, más una cláusula de patentes explícita | Qwen3.8-27B, toda la familia Qwen 3.5 |
| Licencia propia con umbral de ingresos | Libre por debajo del umbral; por encima, contrato con el proveedor | Qwen3.8-Max (umbral de 50 millones de dólares en ingresos por servicios de IA), Kimi K3 (20 millones) |
| Pesos cerrados | Solo API o suscripción | OpenAI, Anthropic, Google, xAI, Yandex, Meta |
Esta columna es más útil que cualquier columna de benchmark. La puntuación de un modelo se recalcula en seis semanas; el texto de la licencia los proveedores lo cambian con menos frecuencia y avisando con antelación.
Un apunte aparte sobre Qwen3.8-Max: Alibaba ha prometido por primera vez abrir un modelo Max, pero la licencia, por lo que se sabe, es propia y fija los ingresos superiores a 50 millones de dólares como condición para negociar. Revísala antes de incluir el alojamiento propio en el plan.
Alojar el modelo en casa ya no es un compromiso
Qwen3.8-27B es un modelo denso de 27–28.000 millones de parámetros con codificador de visión, contexto de 262.000 tokens y licencia Apache 2.0. Cuantizado en Q4_K_M ocupa unos 17 GB: cabe en una sola tarjeta gráfica de consumo tipo RTX 4090 o en un portátil de 16 GB con Ollama y llama.cpp.
GLM-5.3-Flash, con licencia MIT, necesita unos 306 GiB en FP8 y NVIDIA Hopper o posterior. Eso ya es escala de empresa mediana o grande, pero la licencia no impone ninguna condición.
GigaChat 3.5 Ultra es un MoE de 432.000 millones de parámetros, también MIT. Qwen3.8-Max pesa unos 2,5 TB en FP8 y sigue siendo una solución de centro de datos.
Para una empresa con requisitos de residencia de datos es un abanico de opciones realmente nuevo: todavía en julio, «quedárselo en casa» significaba elegir un modelo claramente más débil que los de la nube.
La visión llegó de forma desigual
Según su ficha en OpenRouter, Qwen3.8-Max acepta texto, imagen y vídeo. La tabla de visión de LMArena sitúa qwen3.8-max en tercer lugar con 1300±8: una confirmación independiente de que la multimodalidad es real, frente a una fuente secundaria que describía el nivel Max como solo texto.
GLM-5.3-Flash es el primer modelo nativamente multimodal de la línea GLM-5: texto, imagen, vídeo y archivos.
Su historia es instructiva. El 29 de junio, el fundador de Zhipu, Jie Tang, preguntó a la comunidad qué debía incluir el siguiente GLM. En las más de 1.400 respuestas dominaba la visión: los desarrolladores querían analizar capturas de pantalla, PDF, maquetas y mensajes de error sin un modelo intermedio. GLM-5.3 salió el 14 de agosto sin visión. La visión llegó doce días después, en otra línea de producto.
DeepSeek respondió el 21 de agosto con deepseek-v4-flash-vision-exp: imágenes y capturas, estáticas o en secuencias de fotogramas, pero sin vídeo de verdad; se factura a precios de V4-Flash y obtiene 64,3 en Chartography. El sufijo -exp aquí va en serio, no es decorativo: todavía es pronto para construir producción sobre él.
Google hizo otra cosa. Desde el 1 de septiembre, 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite ofrecen comprensión agéntica de vídeo: el modelo recorre la grabación y extrae bajo demanda las transcripciones, fotogramas y audio que necesita, en lugar de tragárselo todo. En grabaciones largas supone hasta un 88 % menos de tokens: una partida directa del presupuesto para quien procese grabaciones de llamadas o vídeos formativos.
Para planificar alrededor de estas novedades vale una sola regla: apóyate en lo que ya ha salido.
Google no tiene modelo de gama alta
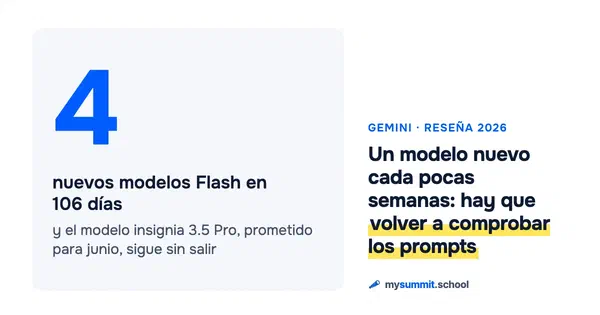
Cuatro lanzamientos Flash en 106 días –3.5 Flash-Lite, 3.6, 3.7 y 3.8 Flash–, de finales de mayo al 2 de septiembre. Sundar Pichai prometió Gemini 3.5 Pro en junio; el estado actual es «saldrá pronto». Según el WSJ, los candidatos internos a buque insignia no superaban a Flash lo suficiente como para justificar un lanzamiento.
Para compras, eso significa una sola cosa: si necesitas un modelo de primer nivel, ahora mismo Google no tiene nada que venderte.
También hay una parte operativa. El 21 de julio Google declaró obsoletos temperature, top_p y top_k: cambió los parámetros en plena oleada de lanzamientos. Los prompts ajustados para 3.6 Flash no están garantizados en 3.8 Flash, y cuatro cambios de modelo en 106 días son una partida de gasto aparte en pruebas de regresión.
Plataformas independientes
Dos plataformas evalúan a todos en las mismas condiciones. Cuando un artículo compara modelos, debe basarse en ellas y no en las cifras de los anuncios.
Artificial Analysis, datos a 6 de septiembre de 2026
| Modelo | Proveedor | Índice de inteligencia | Precio combinado, $/1M | Salida, tok/s |
|---|---|---|---|---|
| Claude Fable 5.1 (max, w/ fallback) | Anthropic | 57 | 6,12 $ | 70 |
| GPT-6 Astra (max) | OpenAI | 55 | 2,57 $ | 71 |
| Claude Opus 5 (max) | Anthropic | 54 | 4,21 $ | 58 |
| Muse Spark 1.3 (max) | Meta | 53 | 0,96 $ | 190 |
| GPT-5.6 Sol (max) | OpenAI | 51 | 1,25 $ | 85 |
| Grok 4.6 (high) | xAI | 51 | 1,25 $ | 63 |
| Kimi K3 (max) | Moonshot | 50 | 1,58 $ | 42 |
| GLM-5.3 (max) | Z.ai | 49 | 1,26 $ | 87 |
| Gemini 3.8 Flash (high) | 47 | 0,74 $ | 334 | |
| Qwen3.8 Max | Alibaba | 47 | 1,19 $ | 40 |
| Qwen3.8-Flash-Next | Alibaba | 46 | – | – |
| GLM-5.3-Flash | Z.ai | 46 | 0,18 $ | 48 |
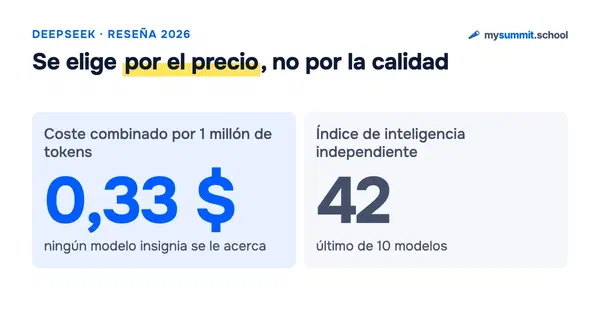
| DeepSeek V4 Pro 0813 (max) | DeepSeek | 42 | 0,33 $ | 71 |
Una salvedad sin la cual es mejor no usar esta tabla: Artificial Analysis publica el índice por versiones y lo reescala entre una y otra. El «60» del anuncio de Z.ai y el «49» del tablero en vivo son el mismo modelo en escalas distintas. Solo se puede comparar dentro de una misma instantánea.
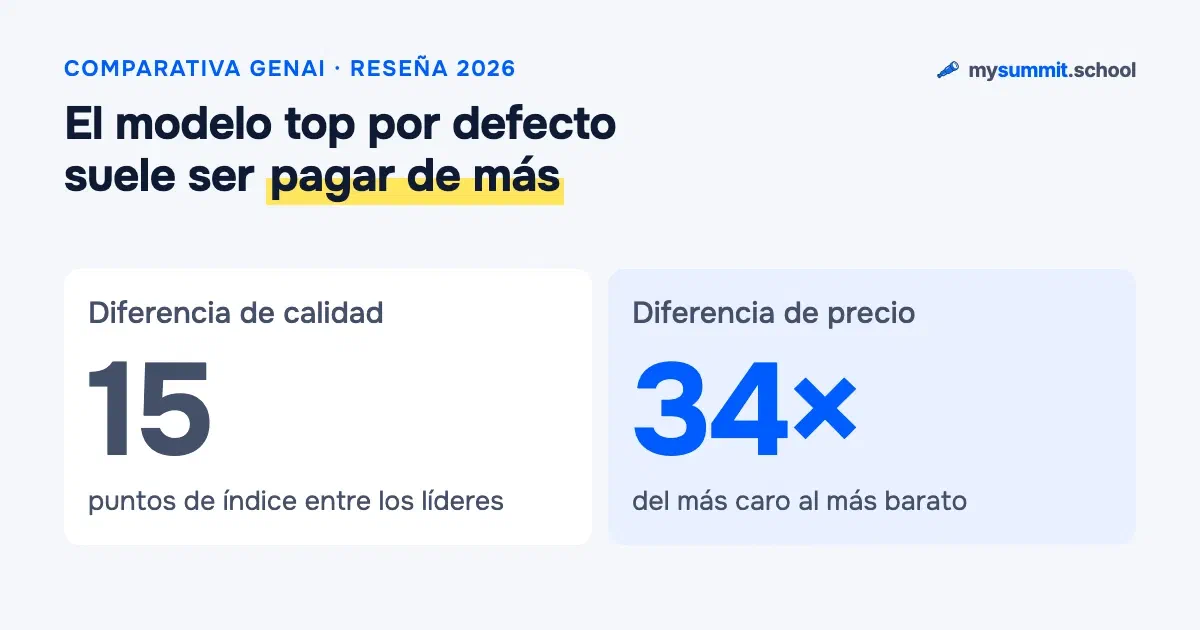
La distancia entre el primero y el último de la tabla es de 15 puntos. La diferencia de precio, de 34 veces: 6,12 $ frente a 0,18 $. Entre esos dos números está la decisión real: cuánto valen quince puntos de índice frente a pagar treinta veces más, precisamente en tus tareas.
LMArena, datos a 6 de septiembre de 2026
Texto, los diez primeros:
| # | Modelo | Puntuación |
|---|---|---|
| 1 | claude-fable-5 (Anthropic) | 1507±5 |
| 2 | claude-opus-4-6-high | 1505±4 |
| 3 | claude-fable-5.1-max | 1504±11 |
| 4 | claude-opus-4-7-high | 1502±4 |
| 5 | muse-spark-1.2 xHigh (Meta) | 1499±10 |
| 6 | claude-opus-4-6 | 1498±3 |
| 7 | claude-opus-4-7 | 1494±4 |
| 8 | gemini-3.8-flash-high (Google) | 1494±9 |
| 9 | claude-opus-5-high | 1493±5 |
| 10 | muse-spark-1.1 (Meta) | 1492±5 |
Visión, los diez primeros:
| # | Modelo | Puntuación |
|---|---|---|
| 1 | claude-fable-5 | 1313±8 |
| 2 | claude-opus-4-7-high | 1301±7 |
| 3 | qwen3.8-max (Alibaba) | 1300±8 |
| 4 | claude-opus-4-7 | 1299±7 |
| 5 | claude-opus-4-6-high | 1299±7 |
| 6 | muse-spark (Meta) | 1294±9 |
| 7 | claude-opus-4-6 | 1293±7 |
| 8 | muse-spark-1.2 xHigh (Meta) | 1292±15 |
| 9 | claude-opus-5-high | 1290±8 |
| 10 | gemini-3-pro (Google) | 1289±8 |
Las cifras de estas dos tablas proceden de LMArena y no tienen relación con nuestro benchmark.
Los intervalos de las posiciones primera a novena se solapan en ambos tableros. Estadísticamente es un empate, y cualquier texto que, basándose en LMArena, nombre al mejor modelo lee en el tablero más de lo que este permite. Analizamos este mecanismo en detalle en «Los benchmarks de IA pierden sentido»; sobre cómo funciona la propia medición, en «Cómo se evalúa la calidad de los LLM».
Los dos tableros divergen de forma reveladora. Anthropic ocupa seis de los diez puestos por preferencia humana y, sin embargo, está a mitad de tabla en Artificial Analysis. Un tablero comprueba las respuestas con una rúbrica; el otro pregunta a personas qué texto les resulta más agradable de leer. Son magnitudes distintas, y confundirlas es un error habitual al elegir.
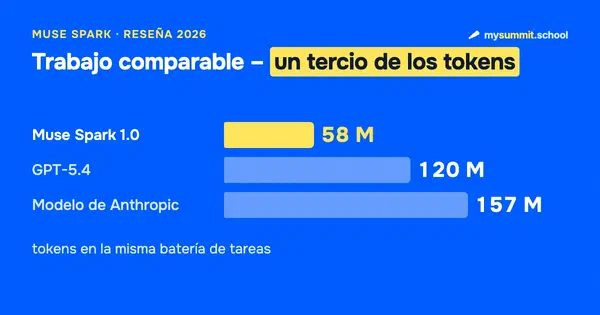
Meta, con la familia muse-spark, se mantiene en el top 10 de ambas tablas, y Muse Spark 1.3 aparece cuarto en Artificial Analysis con un precio de 0,96 $ y 190 tokens por segundo: el doble de rápido que todos los que tiene por encima. Analizamos el catálogo en una parte aparte de la serie.
Hasta aquí, cómo medir los modelos. Y medir no es sencillo: nuestro benchmark describe el catálogo de julio, Artificial Analysis reescala entre versiones y en LMArena los nueve primeros son indistinguibles. La tarea del manager no cambia por eso: necesita una respuesta que pueda meter en un informe o entregar a un cliente. El mismo modelo, con dos formulaciones distintas, produce un borrador que hay que reescribir o un resultado que no hace falta tocar. La diferencia entre «funciona» y «funciona de forma fiable» es la habilidad de formular tareas para la IA.
Tabla resumen: 13 herramientas comparadas
La tercera columna es el modelo de nuestra ronda de julio, no el insignia actual: todo lo que salió después del 16 de julio aún no lo hemos probado. Puestos y puntuaciones están en la tabla en vivo «Precio y resultado», más abajo, que se actualiza con cada oleada del benchmark.
| Herramienta | Insignia a 6 de septiembre de 2026 | Modelo en nuestro benchmark | Contexto | Suscripción | Punto fuerte |
|---|---|---|---|---|---|
| ChatGPT | GPT-6 Astra | GPT-5.6 Sol | 1M tokens en Astra | 20–200 $/mes | Versatilidad, ecosistema, control del ordenador |
| Claude | Fable 5.1; de trabajo – Opus 5 | Opus 4.6 | 1M tokens | 20–200 $/mes | Calidad de texto, planificación, navegador y Cowork |
| Gemini | 3.8 Flash; sin modelo de gama alta | 3.1 Pro | 2M tokens en 3.1 Pro | 20–250 $/mes | Google Workspace, velocidad de salida |
| Perplexity | Multimodelo | no probado | Variable | 20 $/mes | Búsqueda con fuentes |
| Grok | 4.6 | 4.5 | 500.000 tokens | 8–35 $/mes | Gestión de equipos, guiones para conflictos |
| YandexGPT | Alice AI, YandexGPT 5.1 Pro | Alice AI v3 | 128.000 tokens | Por API | Idioma ruso, Yandex 360 |
| GigaChat | 3.5 Ultra | 3.5 Ultra | – | Por API | Datos alojados en Rusia, pesos abiertos MIT |
| DeepSeek | V4-Pro (GA) | V4-Pro | 1M tokens | Por API | Precio, techo de salida de casi 400.000 tokens |
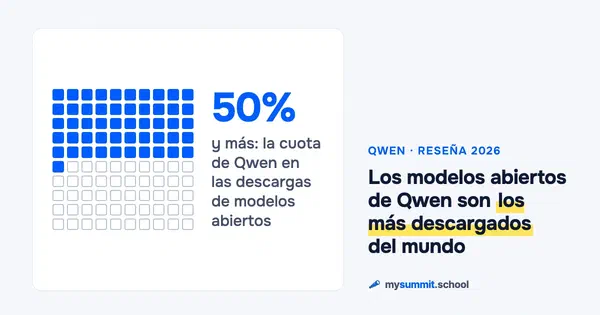
| Qwen | Qwen3.8-Max | 3.6 Plus | 1M tokens en Qwen3.8-Max | Por API | 5 modelos en el top 30, pesos abiertos |
| GLM-5 de Z.ai | GLM-5.3 y GLM-5.3-Flash | GLM-5.2 | 1M tokens | Por API | Pesos MIT en Flash, multimodalidad |
| Kimi | K3 | K3 | 1M tokens | 19–199 $/mes | El modelo no estadounidense más potente de nuestro benchmark |
| MiMo (Xiaomi) | v2.5 Pro | v2.5 Pro | – | Por API | Top 10 a una fracción del precio occidental |
| MiniMax | M3 | M3 | – | Por API | Top 10 a bajo precio |
Meta y su familia muse-spark no están en esta tabla porque no forman parte de nuestro benchmark. El análisis está en la reseña del catálogo Muse Spark; los datos de las plataformas independientes, más arriba.
Precios de los lanzamientos de septiembre
Cifras de las listas de precios de los fabricantes; estos modelos no están en nuestro benchmark.
| Modelo | Entrada, $/1M | Salida, $/1M | Qué conviene saber |
|---|---|---|---|
| GPT-6 Astra | 10 $ | 50 $ | Por encima de 272.000 tokens de entrada, 20 $ y 75 $ para toda la consulta |
| Claude Fable 5.1 | 10 $ | 50 $ | Lectura de caché 0,25 $, un 75 % más barata que en Fable 5 |
| Claude Opus 5 | 5 $ | 25 $ | La mitad que Fable 5.1 |
| Grok 4.6 | 2 $ | 6 $ | Por encima de 200.000, 4 $ y 12 $ |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | Precio de lanzamiento hasta el 31 de diciembre de 2026; tarifa normal sin anunciar |
| Qwen3.8-Max | 2 $ | 6 $ | Lectura de caché 0,25 $ |
| Qwen3.8-Flash-Next | 0,16 $ | 0,47 $ | Vista previa de la arquitectura Qwen4, contexto de hasta 1M con YaRN |
| GLM-5.3 | 1,40 $ | 4,40 $ | Precio sin cambios respecto a la generación anterior |
| GLM-5.3-Flash | 0,15 $ | 0,50 $ | Promoción hasta el 9 de septiembre: 0,075 $/0,25 $ |
Batch y Flex en OpenAI cuestan la mitad; el modo rápido, el doble a cambio del doble de velocidad. GPT-6 Astra tiene otra particularidad de acceso: es el primer modelo que alcanza el umbral crítico de ciberseguridad del Preparedness Framework de OpenAI. La API estándar rechaza las tareas de búsqueda de vulnerabilidades, el acceso completo solo se concede a los programas Trusted Access y Daybreak, y los usuarios normales, según advierte OpenAI, pueden toparse con ralentizaciones y bloqueos.
Comparativa de costes
| # | Modelo | Puntuación | Precio /1M (entrada/salida) | Por prueba | Desde Rusia |
|---|---|---|---|---|---|
| 16 | Kimi K3 | 7,4 | $3.00/$15.00 | $0.219 | sin VPN |
| 3 | GPT-5.6 Sol | 8,0 | $5.00/$30.00 | $0.190 | requiere VPN |
| 26 | Claude Opus 4.6 | 6,8 | $5.00/$25.00 | $0.216 | requiere VPN |
| 41 | MiniMax M3 | 6,2 | $0.30/$1.20 | $0.010 | sin VPN |
| 39 | MiMo v2.5 Pro | 6,2 | $1.00/$3.00 | $0.027 | sin VPN |
| 24 | Grok 4.5 | 6,9 | $2.00/$6.00 | $0.028 | requiere VPN |
| 40 | Kimi K2.6 | 6,2 | $0.74/$3.49 | $0.036 | sin VPN |
| 44 | Qwen 3.6 Plus | 6,1 | $0.33/$1.95 | $0.011 | sin VPN |
| 45 | DeepSeek V4 Pro | 6,0 | $0.43/$0.87 | $0.005 | sin VPN |
| 58 | DeepSeek V4 Flash | 5,6 | $0.09/$0.18 | $0.001 | sin VPN |
| 56 | DeepSeek V4 Flash (Yandex Cloud) | 5,6 | $3.00/$5.00 | $0.023 | sin VPN |
| 71 | GigaChat 3.5 Ultra | 5,1 | $1.07/$3.21 | $0.011 | sin VPN |
| 65 | Alice AI LLM (v3) | 5,4 | $4.10/$9.84 | $0.020 | sin VPN |
| 74 | GigaChat 2 Max | 4,5 | $7.22/$7.22 | $0.013 | sin VPN |
| 46 | Gemini 3.1 Pro | 6,0 | $2.00/$12.00 | $0.027 | requiere VPN |
Modelos en el benchmark: 74, datos a 2026-11-20 · Ranking completo →
Niveles gratuitos que la tabla no muestra: chat ilimitado en Kimi, acceso gratuito completo en Qwen y DeepSeek, interfaz web en GigaChat, Alice y Yandex Browser en Alice AI, y Grok a través de la suscripción X Premium.
El coste por test es el coste medio de un escenario del benchmark (prompt de sistema + tarea + respuesta del modelo, de media unos 2.000 tokens de entrada y 1.500 de salida). Consulta la metodología del benchmark completa.
DeepSeek V4 Flash en Yandex Cloud cuesta 23 veces más que el original con una calidad algo inferior: lo ves en la columna «Coste por test» de arriba. Lo que pagas es que los datos se queden en Rusia y el SLA de Yandex.
Qué herramienta elegir: 7 escenarios
1. Asistente todoterreno para el día a día
ChatGPT tiene el ecosistema más amplio: generación de texto, imágenes, análisis de datos, trabajo con archivos, integraciones a través de la GPT Store. Con GPT-6 Astra la apuesta se ha desplazado al control del ordenador: un contexto de algo más de 1M de tokens, entrada de texto e imagen, salida solo de texto y sin entrada de audio. Anthropic ofrece una elección más clara dentro de su catálogo: Opus 5 a 5 $/25 $ para la mayoría de tareas, Fable 5.1 a 10 $/50 $ para las difíciles y un razonamiento adaptativo (adaptive thinking) siempre activo que ya no hay que encender a mano.
En septiembre, la parte de producto de Anthropic es más interesante que la de modelos. Claude en Chrome ya está disponible para todos en todos los planes de pago, Cowork ha incorporado un navegador y la memoria es ahora compartida entre el chat y Cowork. Para el despliegue corporativo hay un detalle que conviene resolver de antemano: en los planes Team y Enterprise la memoria viene desactivada por defecto.
2. Investigación y verificación de datos
Una herramienta que busca información en internet y muestra enlaces a las fuentes. El modo Deep Research sirve para preguntas complejas.
3. Trabajo en el ecosistema de Google
Si tu empresa usa Google Workspace, Gemini está integrado en Gmail, Docs, Sheets y Drive. 3.8 Flash se ha añadido a la app de Gemini en los planes Pro y Ultra, al AI Mode del buscador y a Google Sheets. La ventana de contexto de 2 millones de tokens es de Gemini 3.1 Pro: es el modelo que permite analizar documentos enormes.
Dos circunstancias para el plan de compras. Google no tiene ahora modelo de gama alta, así que si la tarea exige lo máximo, no hay nada que elegir. Y el precio de lanzamiento de 3.8 Flash vale hasta el 31 de diciembre de 2026 sin tarifa normal publicada: presupuestar con esos 0,75 $ es arriesgado.
4. Trabajo en ruso y datos alojados en Rusia
Este escenario solo importa si operas en Rusia o trabajas con contenido en ruso: GigaChat (de Sber) y YandexGPT son allí los dos grandes modelos nacionales y ambos guardan los datos en Rusia. GigaChat 3.5 Ultra es el mejor modelo ruso de nuestro benchmark de julio, aunque ningún modelo resuelve con fiabilidad el derecho laboral (los occidentales incluidos). YandexGPT está integrado con el ecosistema de Yandex (Yandex 360, Browser, Alice). La alternativa es DeepSeek V4 Flash en Yandex Cloud: en la ronda de julio supera a Alice AI y guarda los datos en Rusia, pero cuesta entre 28 y 33 veces más que el original.
En verano cambiaron dos cosas. Sber lanzó GigaChat 3.5 Ultra con licencia MIT: un MoE de 432.000 millones de parámetros con atención lineal, casi la mitad de grande que el anterior insignia y hasta cuatro veces más rápido con textos largos. Según nuestras mediciones de julio está lejos de los líderes, pero la posibilidad de ejecutarlo en casa cambia las cuentas. Yandex relanzó Alice sobre el nuevo Alice AI LLM, de pesos cerrados, y actualizó YandexGPT 5.1 Pro. Según Yandex, la proporción de respuestas buenas subió del 60 % al 71 % y las alucinaciones se redujeron a la mitad, hasta el 16 %. El precio bajó a un tercio. Desde el 16 de julio todo el catálogo Alice AI –LLM, ART y VLM– está certificado según ISO/IEC 42001.
5. Presupuesto mínimo
DeepSeek V4 Flash sale 130 veces más barato que Gemini 3.1 Pro con más calidad. Qwen 3.7 Plus es «planificación casi gratis». Los precios por test están en la tabla en vivo de arriba.
A ellos se suman dos lanzamientos que no están en nuestro benchmark. Qwen3.8-Flash-Next es una vista previa abierta de la arquitectura Qwen4: 125.000 millones de parámetros, de los que 6.000 millones están activos por token. El contexto de 262.000 tokens se amplía hasta 1M con YaRN y el precio ronda los 0,16 $/0,47 $. Una capa de embeddings n-gram de 51.000 millones vive en la RAM normal en lugar de en la memoria de vídeo. Según Alibaba, supera a DeepSeek-V4-Flash y a Claude Opus 4.6 en la mayoría de las tareas evaluadas. GLM-5.3-Flash, a 0,15 $/0,50 $, añade multimodalidad y licencia MIT.
Con una salvedad sobre DeepSeek: la subida de precios, las franjas punta y la caché más cara significan que lo de «agresivamente barato» se ha acabado. Barato, sigue siéndolo.
6. Confidencialidad de los datos
Qwen, y ahora es una respuesta de verdad.
Qwen3.8-27B: Apache 2.0, codificador de visión, imagen y vídeo nativos, contexto de 262.000 tokens, unos 17 GB en Q4_K_M. Una sola tarjeta gráfica de consumo o un portátil de 16 GB con Ollama y llama.cpp. Todavía en julio este hueco lo ocupaban modelos abiertos de la generación anterior, útiles pero claramente más débiles que los de la nube; ahora es un modelo que puedes dar a tu equipo con tranquilidad.
Al lado hay dos opciones más grandes. GLM-5.3-Flash con licencia MIT, unos 306 GiB en FP8, NVIDIA Hopper o posterior: el único modelo multimodal de este nivel que puedes desplegar legalmente en tu propio hardware sin condiciones de licencia. Y GigaChat 3.5 Ultra con MIT, si necesitas un modelo desarrollado bajo jurisdicción rusa.
Qwen3.8-Max también está prometido formalmente con pesos abiertos, pero en la práctica son unos 2,5 TB en FP8, un centro de datos y una licencia con umbral de ingresos. Para la mayoría de las empresas no es una opción de alojamiento propio.
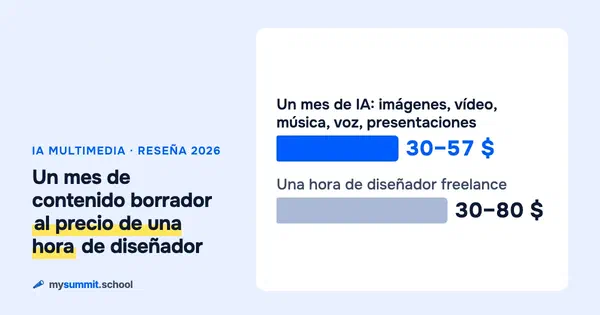
7. Creación de contenido multimedia
ChatGPT más herramientas especializadas.
GPT-6 Astra no acepta audio ni genera imágenes por sí mismo: la generación de imágenes se conecta como herramienta. Durante el verano ha crecido una capa propia alrededor de los modelos insignia: Gemini Omni Flash genera y edita vídeo de 360p a 4K, Lyria 3.5 compone pistas completas, Gemini 3.5 Transcribe reconoce el habla en más de 85 idiomas, separa a los interlocutores y pone marcas de tiempo exactas por palabra, y grok-imagine-video-1.5 entrega 1080p nativo.
Una reseña detallada de herramientas de IA para crear imágenes, vídeo, música y presentaciones está en un artículo aparte de la serie.
Cómo comparar modelos de forma objetiva
Las afirmaciones de marketing no son el mejor criterio de elección. Usa benchmarks independientes:
- Benchmark de mysummit.school: 47 modelos en tareas reales de gestión, dos modelos jueces independientes
- Artificial Analysis: una escala única de inteligencia, precio combinado y velocidad de salida; recuerda el reescalado entre versiones del índice
- LMArena: comparación anónima y a ciegas de modelos por personas reales; las nueve primeras posiciones se solapan en sus intervalos
- SWE-bench: para evaluar las capacidades agénticas de un modelo
Y lo mejor de todo: prueba dos o tres finalistas con tus propias tareas reales.
Consejo práctico: la estrategia «principal + reserva»
No te ates a una sola herramienta. La estrategia óptima:
- Herramienta principal, para el 80 % de las tareas diarias (ChatGPT, Claude o Gemini). Según el benchmark: Claude Opus 4.6 o Grok 4.5 y, por una fracción del precio, Kimi K3 y MiMo v2.5 Pro.
- Reserva, para cuando la principal falla o no está disponible. DeepSeek V4 Flash y Qwen 3.7 Plus son gratuitos.
- Especializada, para tareas concretas: Perplexity para investigar, GigaChat 3.5 Ultra para datos que deben quedarse en Rusia, Qwen para datos confidenciales en tu propio servidor.
Este enfoque te da margen de seguridad y te permite aprovechar los puntos fuertes de cada herramienta.
Trasladada al catálogo de septiembre, la misma lógica queda así: GPT-6 Astra o Claude Fable 5.1 como herramienta principal, Claude Opus 5 como modelo de trabajo a mitad de precio y GLM-5.3-Flash o Qwen3.8-Flash-Next como reserva que además puedes alojar tú mismo. Gemini 3.8 Flash merece una línea aparte: para tareas en las que la velocidad de respuesta importa más que los últimos tres puntos de calidad.
La tabla del principio de este artículo se quedó obsoleta en seis semanas, y la siguiente envejecerá más o menos igual de rápido: Google promete Gemini 3.5 Pro, xAI entrena Grok 5 y Z.ai mantiene los pesos de GLM-5.3 en revisión de seguridad posterior al lanzamiento. En estas tablas lo que antes cambia son las puntuaciones. La columna de licencia es la que menos cambia, y en septiembre de 2026 es la primera que hay que leer: la MIT de GLM-5.3-Flash y la Apache 2.0 de Qwen3.8-27B sobrevivirán al próximo lanzamiento y al próximo reescalado.
Otras partes de esta serie
 Parte 1
ChatGPT en 2026: qué ha cambiado y por dónde empezar si eres manager
 Parte 2
Claude de Anthropic en 2026: Opus 5, Fable 5.1, Mythos 5.1, Cowork y Chrome – guía para managers
 Parte 3
Perplexity AI en 2026: el buscador inteligente que todo manager debería probar
 Parte 4
Google Gemini en 2026: modelos, NotebookLM e integración con Workspace
 Parte 5
Grok de SpaceXAI en 2026: análisis de la IA de Elon Musk
 Parte 6
YandexGPT en 2026: análisis de la IA rusa de Yandex para empresas
 Parte 7
DeepSeek en 2026: análisis de V4-Pro y V4-Flash tras la subida de precios
 Parte 8
GigaChat en 2026: análisis honesto – ¿vale la pena usarlo para el trabajo?
 Parte 9
Qwen de Alibaba en 2026: los pesos abiertos vuelven a los modelos insignia
 Parte 10
Cómo se evalúa la calidad de los LLM en 2026: guía de benchmarks para managers
 Parte 11
IA para crear contenido multimedia en 2026: imágenes, vídeo, música y presentaciones
 Parte 13
Chat Z.AI (GLM-5) en 2026: el modelo chino que finge ser Claude
 Parte 14
Kimi de Moonshot en 2026: K3, K2.6, K2.7-Code y agentes
 Parte 15
GigaChat en el trabajo: cómo sacar el máximo a la IA soberana rusa
 Parte 16
Los benchmarks de IA pierden sentido: ¿cómo elegir un modelo entonces?
 Parte 17
Meta Muse Spark: el primer modelo cerrado de Meta desde 2023
 Parte 18
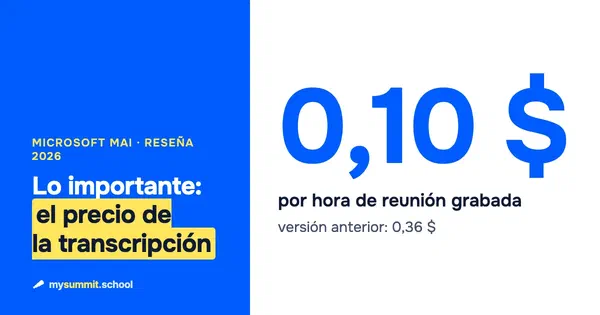
Modelos MAI de Microsoft en 2026: qué se puede usar de verdad y cuánto cuesta
 Parte 19
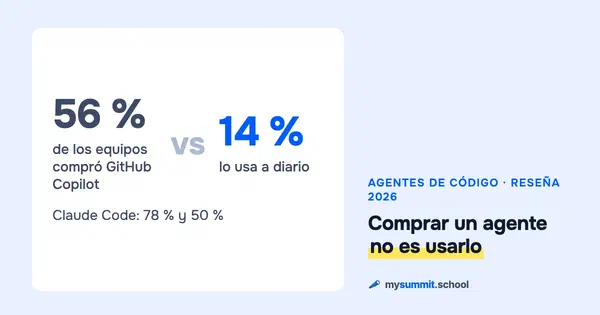
Agentes de código en 2026: dos formatos, el terminal y el escritorio
Todas las reseñas de la serie
- ChatGPT de OpenAI: ecosistema universal y control del ordenador
- Claude de Anthropic: la mejor calidad de texto y seguridad
- Perplexity AI: un buscador de nueva generación
- Gemini de Google: integración con Workspace y cuatro lanzamientos Flash en 106 días
- Grok de xAI: la IA de Elon Musk integrada en X
- YandexGPT: la IA rusa con el ecosistema de Yandex
- DeepSeek: el modelo chino de precios agresivos
- GigaChat de Sber: IA rusa para empresas
- Qwen de Alibaba: el suelo de precios y los pesos abiertos
- Cómo se evalúa la calidad de los LLM: benchmarks para managers
- IA para crear contenido multimedia: imágenes, vídeo, música
- GLM-5 de Z.ai: un modelo chino con pesos abiertos y multimodalidad

18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.