DeepSeek en 2026: análisis de V4-Pro y V4-Flash tras la subida de precios
Modelos de IA en este artículo
DeepSeek (a menudo escrito «Deep Seek») es una startup china de IA que en dos años se ha colocado entre los líderes del sector. En abril de 2026 lanzó V4; el 13 de agosto V4-Pro salió de la beta y el 16 de agosto la empresa cambió su política de precios.
La versión anterior de este artículo presentaba a DeepSeek como el buque insignia low cost y prometía precios entre 10 y 50 veces más bajos que la competencia. Lo primero sigue siendo cierto. Lo segundo hay que recalcularlo: DeepSeek ha subido sus tarifas, ha introducido franjas de hora punta y el precio de un acierto de caché ha crecido hasta un 1100% respecto a los primeros precios de la preview. La propia empresa lo justifica como el paso a ser un proveedor de cómputo sostenible. Sea como sea, un presupuesto calculado con los precios de primavera ya no cuadra.
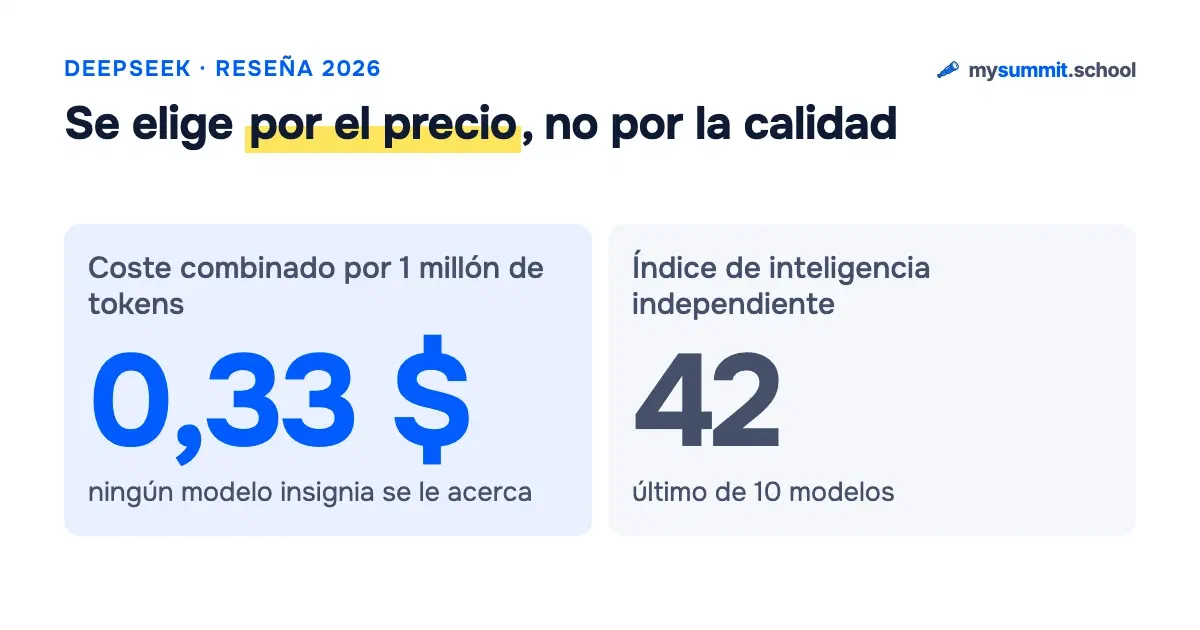
Para un manager, DeepSeek sigue siendo ante todo una cuestión de precio. Con un coste combinado de 0,33 $ por millón de tokens, ningún otro modelo insignia de la tabla de Artificial Analysis se le acerca. Pero el precio ha dejado de ser agresivo, y eso cambia la naturaleza de la decisión: elegir DeepSeek «porque es el más barato» tiene que ser ahora una elección consciente, sabiendo exactamente qué se está comprando.
Todos los modelos se publican con licencia MIT: se pueden descargar y desplegar en servidores propios. Eso sí, el endpoint público funciona con cuantización FP4, así que las respuestas de la API y las de un modelo desplegado en local con los pesos completos no tienen por qué coincidir.
¿Qué tiene de especial DeepSeek?
V4-Pro es un modelo MoE (mixture of experts) de 1,6 billones de parámetros, de los que en cada token se activan 49 000 millones. Se paga por la parte activa, así que, con tamaño de modelo insignia, cada consulta sigue saliendo barata. La atención híbrida y la compresión de la caché KV reducen el coste en contextos largos.
- Ventana de contexto de 1 048 576 tokens: unas 750 000 palabras, alrededor de 2500 páginas de texto.
- Límite de salida de 393 216 tokens, el mayor de todos los modelos de esta comparativa.
- Tres niveles de esfuerzo de razonamiento. En la API de DeepSeek se llaman low, high y max; en OpenRouter el mismo modelo ofrece high y xhigh. Si estás programando una integración, comprueba los nombres de los modos en cada proveedor: no coinciden.
Los principales modelos de DeepSeek (septiembre de 2026)
DeepSeek V4-Pro
 DeepSeek V4 ProEntiende tareas simples
puntuación 6,0/10 puesto 45 de 74 $0,005 por tarea sin VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
El modelo insignia, disponible para todos desde el 13 de agosto de 2026 en la app, en la web y por API. Un asistente polivalente: redacción, análisis, código, trabajo con datos. Sigue siendo un modelo de texto: la ficha de Pro no incluye entrada de imágenes, audio ni vídeo.
Las cifras del fabricante, del informe que acompañó al lanzamiento: Terminal Bench 2.1 – 87,9; HLE con herramientas – 60,0; DSBench-FullStack – 71,1. Para la variante V4-Pro-Max declara 93,5 en LiveCodeBench y 80,6 en SWE-bench Verified, además de 3206 en Codeforces y 83,5 en MRCR con un millón de tokens. Son evaluaciones del propio DeepSeek; más abajo está la imagen independiente, bastante más modesta.
- Contexto de 1 000 000 de tokens de entrada y hasta 393 216 de salida
- Herramientas, tool_choice, salida estructurada en JSON
- Pesos con licencia MIT; endpoint público en FP4
El límite de salida merece un párrafo aparte. 393 216 tokens son unas 295 000 palabras: el informe anual de una gran empresa en una sola pasada. En el resto de modelos de la comparativa el techo es varias veces menor, y para quien genera documentos largos es la única característica que ninguna puntuación de inteligencia sustituye.
DeepSeek V4-Flash
DeepSeek V4 FlashEntiende tareas simples
puntuación 5,6/10 puesto 58 de 74 $0,001 por tarea sin VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
El modelo rápido y barato, con 284 000 millones de parámetros. Su lanzamiento oficial en beta pública fue el 31 de julio de 2026, y el fabricante destacó las capacidades agénticas y el soporte de la Responses API para Codex. Terminal Bench 2.1 – 82,7 según el fabricante.
El mismo contexto de un millón de tokens y los mismos modos de razonamiento. Está pensado para trabajo de gran volumen: chatbots, procesamiento de documentos, consultas masivas.
Conviene tener presente una cosa: Qwen3.8-Flash-Next supera a V4-Flash en la mayoría de las tareas probadas con bastantes menos parámetros activos. Durante el verano, V4-Flash dejó de ser el modelo más fuerte de su segmento.
Visión: deepseek-v4-flash-vision-exp
El 21 de agosto de 2026 DeepSeek lanzó su primer modelo con entrada de imágenes. Se invoca como model='deepseek-v4-flash-vision-exp' y se factura a las tarifas de V4-Flash.
Su uso declarado es la automatización de interfaces y la lectura de gráficos. Acepta imágenes estáticas y secuencias de capturas de pantalla; no procesa vídeo real. Chartography – 64,3, y el fabricante afirma además que sus capacidades agénticas multimodales se acercan a las de Opus 4.8. Ambas cifras son suyas.
El modelo todavía no está en nuestro benchmark y tampoco tiene evaluaciones independientes: solo los datos del fabricante.
El sufijo -exp va en serio. Es una preview: no se puede construir un proceso en producción sobre ella, porque el comportamiento o el precio pueden cambiar en cualquier momento. La visión ha llegado al modelo barato; el insignia sigue siendo solo de texto.
La generación de imágenes sigue en la línea aparte Janus-Pro-7B: 80% en GenEval frente al 67% de DALL-E 3, con una resolución limitada a 384×384 px.
Los prompts para DeepSeek parecen sencillos: subes un documento y pides una conclusión. La dificultad empieza cuando la respuesta tiene que ser precisa, con números que cuadran y riesgos que no se pierden en la segunda página. La diferencia entre «el modelo ha respondido» y «con este modelo se puede trabajar» es saber plantear la tarea.
Comparación con la competencia
Qué dicen las plataformas independientes
La foto de septiembre de Artificial Analysis para diez modelos punteros. Índice de inteligencia, precio combinado por millón de tokens y velocidad de salida, todo con la misma metodología, que es lo que hace útil la tabla.
| Modelo | Fabricante | Intelligence Index | Precio combinado, $/1M | Salida, tokens/s |
|---|---|---|---|---|
| Claude Fable 5.1 (max) | Anthropic | 57 | 6,12 $ | 70 |
| GPT-6 Astra (max) | OpenAI | 55 | 2,57 $ | 71 |
| Claude Opus 5 (max) | Anthropic | 54 | 4,21 $ | 58 |
| Grok 4.6 (high) | xAI | 51 | 1,25 $ | 63 |
| Kimi K3 (max) | Moonshot | 50 | 1,58 $ | 42 |
| GLM-5.3 (max) | Z.ai | 49 | 1,26 $ | 87 |
| Gemini 3.8 Flash (high) | 47 | 0,74 $ | 334 | |
| Qwen3.8-Max | Alibaba | 47 | 1,19 $ | 40 |
| GLM-5.3-Flash | Z.ai | 46 | 0,18 $ | 48 |
| DeepSeek V4-Pro 0813 (max) | DeepSeek | 42 | 0,33 $ | 71 |
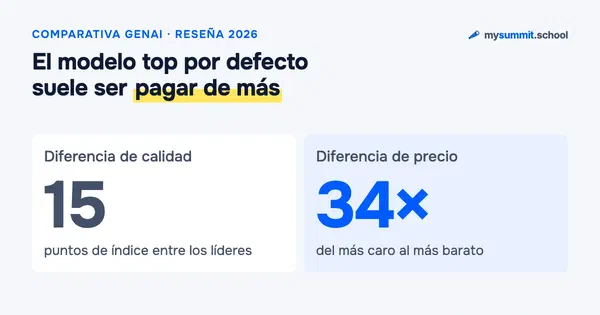
DeepSeek V4-Pro queda último en inteligencia en esta tabla; solo GLM-5.3-Flash es más barato, y juega en otra categoría. Entre la primera y la última fila hay 15 puntos de índice, y entre el precio más caro y el más barato de la foto, 34 veces. Ese es el posicionamiento honesto de DeepSeek en septiembre de 2026: se elige por el precio.
Una salvedad sobre la propia escala. Artificial Analysis publica el índice por versiones y lo reescala entre una y otra, de modo que el «60» de la nota de lanzamiento de un fabricante y el «42» de la foto actual pertenecen a sistemas de coordenadas distintos. Solo tiene sentido comparar dentro de una misma foto. Cómo funciona este tipo de medición, en Cómo funcionan los benchmarks de LLM en 2026.
LMArena ofrece una segunda imagen: DeepSeek no aparece en el top 10 ni de texto ni de visión. Los intervalos de confianza de las nueve primeras filas del ranking de texto se solapan, así que las posiciones de la primera a la novena son estadísticamente indistinguibles. Cualquier «el modelo X es el mejor» sacado de ahí le pide al ranking más de lo que mide, justo el argumento que la serie ya desarrolló en Los benchmarks de IA pierden sentido.
Los vecinos chinos
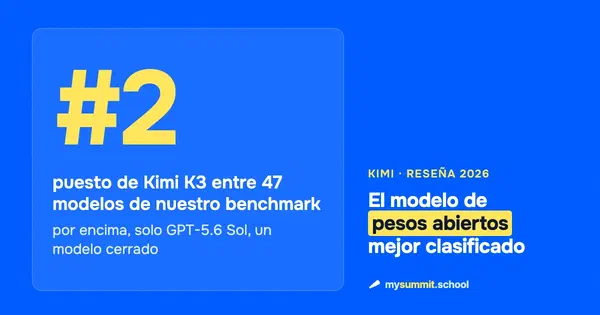
Kimi K3 es el principal competidor chino de DeepSeek en tareas agénticas. En la foto de Artificial Analysis obtiene 50 puntos de índice con un precio combinado de 1,58 $: unas cinco veces más caro que V4-Pro y ocho puntos por encima. K3 todavía no está en nuestro benchmark, así que aquí se citan los datos de la plataforma independiente.
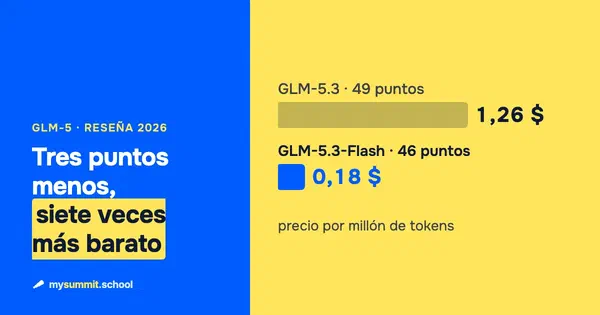
La fila más incómoda para DeepSeek en esa misma tabla es la de GLM-5.3-Flash: 46 puntos de índice y 0,18 $ de precio combinado. Cuatro puntos por encima de V4-Pro y casi a mitad de precio. El argumento «cojamos DeepSeek, que es más barato que los otros chinos» ya no funciona por defecto.
Dónde V4-Pro es más fuerte
- Límite de salida de 393 216 tokens, el máximo de la comparativa. Para generar documentos largos, nadie en esta tabla ofrece una cifra así.
- Contexto largo a un precio razonable: un millón de tokens de entrada por unos 0,435 $ por millón en acceso directo fuera de hora punta.
- Código, según el fabricante: 93,5 en LiveCodeBench y 80,6 en SWE-bench Verified para V4-Pro-Max.
- Pesos con licencia MIT: el modelo se puede llevar dentro del perímetro propio, algo imposible con los modelos cerrados de la parte alta de la tabla.
Dónde V4-Pro se queda atrás
- La evaluación independiente de calidad. 42 puntos en Artificial Analysis: la última fila entre los diez modelos de esta foto.
- La brecha entre las cifras del fabricante y la verificación independiente. DeepSeek declara 87,9 en Terminal Bench 2.1 y 60,0 en HLE con herramientas, mientras el índice independiente coloca el modelo al final de la lista. Ambas cifras son honestas; simplemente responden a preguntas distintas.
- Multimodalidad. El insignia no tiene ninguna, y en Flash está en preview. En Claude, GPT y Gemini el análisis de imágenes está integrado en el modelo principal.
- Comunicación. Según nuestros datos, uno de los peores resultados entre los modelos punteros en tareas de redactar feedback.
Eso sí, cambiar de modelo no es la única forma de reducir la brecha en tareas agénticas. En agosto de 2026, el estudio StateM subió a DeepSeek-V4 Flash del 82,7% al 88,1% en Terminal-Bench 2.1 sin cambiar los pesos, solo con el andamiaje alrededor del modelo: runbooks, estado persistente y verificación de pasos. Qué se hizo exactamente y por qué importa para los modelos abiertos y baratos, en nuestro análisis de los últimos benchmarks de ingeniería de prompts (en ruso).
Saber qué modelo es más barato es útil. Más útil es saber explicar por qué en tu tarea el modelo barato da un resultado aceptable y en la de al lado no.
Aplicaciones prácticas para el manager
- «Traducir» lo técnico a lenguaje llano: resumir un informe técnico complejo en una nota breve para la dirección.
- Poner a prueba la lógica de una decisión (modo max): sube un plan de negocio y pide que encuentre sus puntos débiles. El nivel máximo de razonamiento saca a la luz riesgos poco evidentes.
- Análisis de datos: describe con tus palabras qué quieres saber de una hoja de Excel y DeepSeek escribirá las fórmulas o un script.
- Trabajo con documentos grandes: sube un reglamento interno o un informe anual (hasta ~2500 páginas) y hazle preguntas. Un contexto de un millón de tokens da cabida a bases de código o bases de conocimiento corporativas enteras.
- Documentos largos como resultado: el límite de 393 216 tokens permite pedir un texto coherente de cientos de páginas en una sola consulta, sin ir pegando trozos.
- Acelerar al equipo de IT: escribir código, revisarlo, tests y documentación.
Pruébalo tú mismo: análisis de una decisión arriesgada
Abajo tienes un caso de gestión con problemas poco evidentes. Pulsa «Ejecutar» y compara cómo V4-Pro, V4-Flash y Kimi K3 se enfrentan a la búsqueda de riesgos. Fíjate en la profundidad del razonamiento y en lo concretas que son las recomendaciones.
Tú
Eres un analista de negocio con experiencia. Encuentra los riesgos ocultos en la siguiente decisión.

## Decisión
Una cadena de 40 cafeterías en Madrid planea automatizar por completo en 3 meses la preparación de café en todos sus locales (robots barista). Presupuesto: 12 millones de euros. Ahorro esperado en personal: 800 000 €/mes. Amortización: 15 meses. Un piloto en 2 locales mostró un aumento del 40% en la velocidad de servicio.

## Contexto
- 340 baristas afectados por un ERE
- El contrato de alquiler del 60% de los locales vence dentro de 18 meses
- Ticket medio: 4,80 €; el 70% de la facturación se concentra en la hora punta de la mañana (7:00–9:30)
- NPS de los clientes actuales: 72

## Tarea
1. Encuentra 3–5 riesgos que los autores de la decisión podrían haber pasado por alto
2. Para cada uno: probabilidad (alta/media/baja) y daño potencial
3. Acciones concretas para mitigar cada riesgo
4. ¿Qué supuestos no están respaldados por datos?
5. Recomendación final: aprobar, revisar o rechazar
En qué fijarse en las respuestas:
- V4-Pro con el nivel máximo de razonamiento construye una cadena de análisis y encuentra con más frecuencia conexiones poco evidentes (alquileres + despidos = riesgo reputacional; un piloto en 2 locales no es representativo para 40)
- V4-Flash responde más rápido y más barato, pero pasa por alto con más frecuencia cómo se relacionan los riesgos
- Kimi K3 suele estructurar la respuesta con más detalle, aunque puede resultar redundante
Actualización: nuestro benchmark, nuevos precios y revendedores (septiembre de 2026)
En nuestro benchmark de tareas de gestión (42 modelos, 80 escenarios), DeepSeek V4 se probó con los precios de primavera. Los resultados de calidad siguen vigentes; las cifras de coste, ya no.
DeepSeek V4-Pro
- Information search5,8
- Data analysis6,3
- Decisions under uncertainty6,6
- Feedback analysis6,5
- Corporate requirements and risks5,8
- Automation5,5
- People management6,5
- Russia and Kazakhstan specifics5,0
Con los precios hay ahora mucha dispersión, y es mejor mostrar el cuadro completo que escoger la cifra que más convenga. En DeepSeek directo, fuera de hora punta, se pagan unos 0,435 $ por millón de tokens de entrada y 0,87 $ de salida, con el acierto de caché en torno a 0,0036 $. El precio combinado de OpenRouter entre 16–17 proveedores ronda 0,69 $ y 1,37 $, con lectura de caché a 0,057 $. La diferencia se debe tanto a la tarifa de hora punta como al margen que añade cada proveedor. Para el presupuesto, usa el canal por el que realmente vaya a pasar tu tráfico.
Para qué sirve el modelo según nuestros escenarios: planes de implantación de procesos, guiones para conversaciones difíciles con el equipo, correspondencia rutinaria en volumen. Dónde falla sistemáticamente: ROI y modelos financieros con errores de cálculo, argumentación jurídica, análisis de precios SaaS.
DeepSeek V4-Flash
0,09 $/0,18 $ por millón de tokens fuera de hora punta es el último precio publicado del modelo, y en las franjas punta se duplica. En nuestro benchmark Flash quedó por encima de Gemini 3.1 Pro con un precio dos órdenes de magnitud menor. Un buen modelo de trabajo para textos y planes, si consigues repartir tus consultas entre las franjas tarifarias.
Sirve para: informes semanales, clasificación de feedback, planes trimestrales y matrices de riesgos. No sirve para: presupuestos y modelos financieros, derecho internacional y RGPD, código de automatización.
Comprar a través de un revendedor: el caso de Yandex Cloud
Un revendedor añade su propia capa de precios sobre la de DeepSeek. Yandex Cloud, el mayor proveedor cloud de Rusia, vende DeepSeek V4 Flash a través de su propia API. DeepSeek V4 Flash (Yandex Cloud) es exactamente el mismo modelo, con precio fijo, y desde los cambios de agosto el tamaño del margen depende de la hora del día.
| Parámetro | DeepSeek directo, fuera de punta | DeepSeek directo, en punta | Yandex Cloud |
|---|---|---|---|
| Entrada por 1M | 0,09 $ | 0,18 $ | 3,00 $ |
| Salida por 1M | 0,18 $ | 0,36 $ | 5,00 $ |
| Margen del revendedor | ×33 en entrada, ×28 en salida | ×17 en entrada, ×14 en salida | – |
En la versión de primavera de este artículo el margen era de 28–33 veces. No ha desaparecido; simplemente ya no es la única cifra: las franjas punta reducen la diferencia a la mitad.
Lo que paga ese margen es local de Rusia: acceso sin VPN, un SLA de Yandex, datos alojados en el país y una ventana de contexto de un millón de tokens. Para un equipo en España o Latinoamérica nada de eso aplica, pero la lección sí: el precio fijo de un revendedor puede compensar cuando necesitas su contrato, su SLA o la residencia de datos, y la prima se reduce si tu tráfico iba a caer en hora punta de todos modos. Si nada de eso importa y puedes sacar el tráfico de las franjas punta, el acceso directo sale decenas de veces más barato y, según nuestro benchmark, además un poco más preciso.
Generaciones anteriores
DeepSeek V3.2 (probado anteriormente): un sólido nivel medio-alto, especialmente fuerte en planificación y resolución de problemas. Su gran carencia es la comunicación: uno de los peores resultados entre todos los modelos probados.
DeepSeek R1: un nivel comparable. Sus puntos fuertes son la búsqueda de información y el análisis, donde el razonamiento paso a paso da una ventaja clara.
Resultados interactivos completos ->
El análisis detallado por categorías está en nuestro artículo sobre las mejores IA para managers.
Limitaciones y riesgos
- Multimodalidad en fase preview: el insignia V4-Pro es de texto; la entrada de imágenes llegó el 21 de agosto solo al modelo Flash y con el sufijo
-exp. El modelo no procesa vídeo real. La generación de imágenes es una línea aparte, Janus-Pro, con resolución de 384×384. En Claude, GPT y Gemini la multimodalidad está integrada en el modelo principal. - Seguridad del contenido: los filtros de protección son más débiles que los de ChatGPT y Claude. Es más fácil «convencer» al modelo de que genere contenido no deseado.
- Confidencialidad de los datos: la empresa tiene su sede en China. La solución: descargar el modelo (licencia MIT) y desplegarlo en local; los destilados de DeepSeek de 7B y 14B funcionan en un portátil normal. Hay que recordar el FP4 del endpoint público: la API y una instalación local con los pesos completos se comportan de forma distinta.
- Menos integraciones listas para usar: no hay plugins oficiales para CRM ni ERP. Pero admite los formatos de API de OpenAI y Anthropic, así que la mayoría de herramientas funcionan a través de un adaptador.
- Estabilidad de la API: en horas punta hay retrasos y fallos. Desde el 16 de agosto la hora punta está fijada en las tarifas, lo que da una pista de dónde está la carga máxima. Para sistemas en producción conviene usar proveedores intermediarios (DeepInfra, Together.ai, OpenRouter).
- Las integraciones antiguas se rompen: los identificadores
deepseek-chatydeepseek-reasonerse desactivaron el 24 de julio de 2026. Si la integración no se actualizó, ya ha dejado de funcionar. - El chino, primero: pero la calidad en otros idiomas se mantiene. Nuestro benchmark se hace en ruso, y según nuestros datos DeepSeek V3.2 supera a todos los modelos rusos (incluidos Alice AI y GigaChat) incluso en tareas propias del contexto ruso.
Tarifas y disponibilidad
Desde el 16 de agosto de 2026 DeepSeek cobra los tokens con dos tarifas. Las franjas punta son 01:00–04:00 y 06:00–10:00 UTC, y dentro de ellas el precio se duplica. En la España peninsular equivale a 03:00–06:00 y 08:00–12:00 en horario de verano (una hora antes en invierno).
La segunda franja cubre toda la mañana laboral en España. Lo que se ejecuta de forma interactiva entre las 8 y las 12 paga el doble; lo que se puede pasar a un proceso nocturno paga la mitad. En Latinoamérica la punta cae de noche: en Ciudad de México, de 19:00 a 22:00 y de 00:00 a 04:00; en Buenos Aires, de 22:00 a 01:00 y de 03:00 a 07:00. Ahí la trampa es justo el batch nocturno, la tarea que normalmente se programa de noche para ahorrar. La diferencia entre ambos modos de trabajo es exactamente el doble, y no la verás en ninguna página de precios: depende de tu calendario.
| Canal | Entrada por 1M | Salida por 1M | Caché |
|---|---|---|---|
| DeepSeek directo, fuera de punta | 0,435 $ | 0,87 $ | ~0,0036 $ |
| DeepSeek directo, en punta | ~0,87 $ | ~1,74 $ | el doble que fuera de punta |
| OpenRouter, combinado de 16–17 proveedores | ~0,69 $ | ~1,37 $ | 0,057 $ por lectura |
| DeepSeek V4-Flash directo, fuera de punta | 0,09 $ | 0,18 $ | ~0,014 $ |
- Acceso gratuito: chat.deepseek.com se puede usar gratis, incluido el modo de razonamiento profundo.
- Open source (MIT): todos los modelos se pueden descargar, usar comercialmente y modificar sin restricciones.
- Lo que más ha subido es la caché: la tarifa por acierto de caché de V4-Pro ha crecido hasta un 1100% respecto a los primeros precios de la preview. Si el ahorro se basaba en consultas repetidas con un prefijo común largo, hay que volver a hacer las cuentas.
- El descuento del 75%, anunciado en primavera como temporal, se hizo permanente en verano, y en agosto se le sumó el recargo de hora punta. Resultado: el precio estándar de salida de V4-Pro es de 0,87 $ fuera de punta y unos 1,74 $ en punta.
- Los proveedores no coinciden en precio: el acceso directo a DeepSeek es aproximadamente 1,5 veces más barato que la tarifa combinada de OpenRouter, pero OpenRouter resuelve la disponibilidad y la tolerancia a fallos.
Así queda la cuenta para el presupuesto. Un equipo que procesa 100 millones de tokens al mes con V4-Flash pagaba con los precios anteriores unos 18 $ por la salida. El mismo volumen en franja punta cuesta el doble, y con V4-Pro en punta la factura sube a cientos de dólares. La única forma gratuita de recuperar ese dinero es sacar la carga batch de las franjas punta: en España, de la mañana de 08:00 a 12:00; en Latinoamérica, de las horas nocturnas.
Qué cambió de V3 a V4
| Parámetro | DeepSeek V3.2 | DeepSeek V4-Pro |
|---|---|---|
| Contexto | 128K tokens | 1 000 000 de tokens |
| Parámetros | 671B (37B activos) | 1,6T (49B activos) |
| Modos de razonamiento | modelo R1 aparte | integrado (3 niveles de esfuerzo) |
| Licencia | Custom open | MIT |
| Salida máx. | ~8K | 393 216 tokens |
| Entrada de imágenes | no | no en Pro, preview en Flash |
| Compatibilidad de API | formato OpenAI | OpenAI + Anthropic |
| Tarifas | planas | punta y fuera de punta desde el 16/08/2026 |
| Chips | Nvidia H800 | Nvidia + Huawei Ascend |
Migración desde versiones anteriores
Los identificadores deepseek-chat y deepseek-reasoner se desactivaron el 24 de julio de 2026. Antes redirigían a V4-Flash; ahora las peticiones simplemente fallan. Los identificadores actuales son deepseek/deepseek-v4-flash, deepseek/deepseek-v4-pro y deepseek-v4-flash-vision-exp para la entrada de imágenes.
De paso, revisa los nombres de los modos de razonamiento: en la API directa son low, high y max; en OpenRouter, high y xhigh. Una integración que pasa fielmente reasoning_effort: "max" a un canal puede, en otro, volver en silencio al valor por defecto.
Enlaces útiles
- Web oficial de DeepSeek
- DeepSeek Chat – interfaz web gratuita
- Registro oficial de cambios de la API
- Documentación de la API y precios
- Modelos en Hugging Face
- Anuncio de V4 (informe técnico)
En cuatro meses DeepSeek ha subido sus precios, ha introducido franjas punta, ha encarecido la caché en un orden de magnitud y sigue siendo el modelo insignia más barato de la tabla independiente. Quien lo eligió en primavera «porque es barato» lo elige en septiembre por el mismo motivo, y paga más.
Lo que la tabla no responde es la pregunta principal: cuántos puntos de índice pierde tu tarea concreta. Solo se puede comprobar con tus propios escenarios, y mejor antes de que el modelo quede integrado en un proceso y sustituirlo se convierta en un proyecto aparte.
Este artículo forma parte de la serie «Revisión de herramientas GenAI 2026». Todas las herramientas se analizan con ejercicios prácticos en el curso de mysummit.school.
Otras partes de esta serie
 Parte 1
ChatGPT en 2026: qué ha cambiado y por dónde empezar si eres manager
 Parte 2
Claude de Anthropic en 2026: Opus 5, Fable 5.1, Mythos 5.1, Cowork y Chrome – guía para managers
 Parte 3
Perplexity AI en 2026: el buscador inteligente que todo manager debería probar
 Parte 4
Google Gemini en 2026: modelos, NotebookLM e integración con Workspace
 Parte 5
Grok de SpaceXAI en 2026: análisis de la IA de Elon Musk
 Parte 6
YandexGPT en 2026: análisis de la IA rusa de Yandex para empresas
 Parte 8
GigaChat en 2026: análisis honesto – ¿vale la pena usarlo para el trabajo?
 Parte 9
Qwen de Alibaba en 2026: los pesos abiertos vuelven a los modelos insignia
 Parte 10
Cómo se evalúa la calidad de los LLM en 2026: guía de benchmarks para managers
 Parte 11
IA para crear contenido multimedia en 2026: imágenes, vídeo, música y presentaciones
 Parte 12
Comparativa de herramientas GenAI 2026: ¿qué IA debe elegir un manager?
 Parte 13
Chat Z.AI (GLM-5) en 2026: el modelo chino que finge ser Claude
 Parte 14
Kimi de Moonshot en 2026: K3, K2.6, K2.7-Code y agentes
 Parte 15
GigaChat en el trabajo: cómo sacar el máximo a la IA soberana rusa
 Parte 16
Los benchmarks de IA pierden sentido: ¿cómo elegir un modelo entonces?
 Parte 17
Meta Muse Spark: el primer modelo cerrado de Meta desde 2023
 Parte 18
Modelos MAI de Microsoft en 2026: qué se puede usar de verdad y cuánto cuesta
 Parte 19
Agentes de código en 2026: dos formatos, el terminal y el escritorio

18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.